Affichage des articles dont le libellé est graphe. Afficher tous les articles

28 février 2011

Compléter sa CD-thèque : Set Cover pour une intégrale Dvorak ?

Un peu de programmation linéaire en nombres entiers aujourd'hui, appliquée à la constitution d'une collection de CD. Depuis son édition intégrale des oeuvres de Mozart en 2005, Brilliant Classics a récidivé avec Bach en 2006, Chopin et Beethoven en 2007, Brahms et Haydn et Rachmaninov en 2008. A chaque fois avec des prix canons. Pour Schubert et Dvorak, en revanche, il faut être patient, et ça m'embête bien...

Alors comment réunir une intégrale d'un compositeur en achetant le minimum de CD (sans pirater bien sûr !) ? Cela correspond précisément au problème SetCover. Les données : des éléments (les oeuvres), et des ensembles de ces éléments (les CD qui réunissent une ou plusieurs oeuvres). Le problème : sélectionner un minimum de ces ensembles pour couvrir tous les éléments. Si vous voulez optimiser non pas le nombre de CD mais le prix total, il faut considérer la version pondérée du problème, en attribuant à chaque CD un poids qui correspond à son prix, et en cherchant à couvrir tous les éléments par des ensembles dont la somme des poids est minimale.

Illustrons cela sur les 9 symphonies de Dvorak. Le graphe biparti ci-dessous représente les CD sur la ligne du haut, les symphonies sur la ligne du bas, et chaque CD est relié aux symphonies qu'il contient.

La solution est montrée en rouge. Comment l'ai-je trouvée ? Le problème est NP-complet, il n'existe donc probablement pas d'algorithme rapide (qui s'exécutera en temps polynomial par rapport à la taille de l'entrée du problème) pour le résoudre. Cependant, il existe un moyen rapide en pratique pour de petites instances du problème : le coder par un programme linéaire en nombres entiers (cette expression barbare est déjà apparue dans le billet précédent). Vulgarisons un peu pour montrer comment ça fonctionne, en utilisant les mêmes notations que l'article Wikipedia sur SetCover : il s'agit d'associer à chaque CD appelé S une variable binaire c(S) qui prend la valeur 1 si le CD fait partie de la solution, 0 sinon. En appelant x(S) le coût du CD S, pour calculer le coût total de la solution, que l'on cherche à minimiser, il faut faire la somme (pour tout S) des x(S)*c(S). On ajoute des contraintes pour assurer que chaque symphonie est bien présente dans un des CD de la solution : pour toute symphonie e, la somme des c(S), pour l'ensemble des CD S qui contiennent la symphonie e, est supérieure ou égale à 1.

Et maintenant que le problème est ainsi formulé de manière mathématique, comment trouver les valeurs solutions pour les variables c(S) ? En théorie, on résout rapidement une relaxation du problème (c'est-à-dire la version du problème où on laisse prendre à c(S) n'importe quelle valeur entre 0 et 1, comme si on avait le droit d'acheter des portions de CD...), puis une fois cette solution trouvée, on va essayer d'en déduire (et c'est cette étape qui risque de prendre du temps) une solution où les c(S) prennent soit la valeur 0, soit la valeur 1. En pratique, on utilise par exemple le programme GLPK qui est gratuit, et s'installe aussi sous Windows. On commence par s'inspirer du fichier exemple (ou on lit la doc') pour formuler le problème dans le langage voulu, et on obtient le fichier de paramètres dvorak.mod. On exécute alors GLPK avec la ligne de commande :
"C:\Program Files\GnuWin32\bin\glpsol.exe" -m "C:\Program Files\GnuWin32\bin\examples\dvorak.mod"
La réponse s'affiche : "Optimal set cover has cost 4460 with 3 elements with sets: 3 8 16", ce qui correspond à ma solution en rouge qui coûte donc 44 euros 60.

Vous allez me dire que dans une bonne intégrale de musique classique, le prix n'est pas votre critère de sélection. Vous voulez assurer une certaine cohérence dans votre collection, en achetant toutes les symphonies enregistrées par le même orchestre ? Dans ce cas regroupez en un seul tous les ensembles qui correspondent à ces enregistrements. Vous voulez ajouter un critère de qualité ? N'utilisez pas le simple prix comme pondération, mais, par exemple, divisez-le par votre score de qualité pour chaque CD, score d'autant plus élevé que vous appréciez le CD.

Pour Dvorak, malheureusement, cette modélisation n'a pas suffi à résoudre ma quête d'une intégrale en CD, tout simplement parce que certaines oeuvres ne sont à ma connaissance pas enregistrées. En voici la liste, au cas où vous voudriez vous lancer dans des "world premiere recordings", les numéros de référence correspondent au catalogue Burghauser :

  • B11 intégrale des chants du cycle Cyprès,
  • B13 22 Songs,
  • B16 Alfred,
  • B22/B43 Potpourri on King and Charcoal Burner,
  • B48b Nocturne in B major (piano 4 mains),
  • B113 Festival Song,
  • B119 Gallop in E major,
  • B125 Josef Kajetán Tyl,
  • B143 Hymn of the Czech Peasants,
  • B204 Song of the Smith of Lešetín.
A défaut des enregistrements, je suis preneur d'infos sur les partitions ! Et je vous laisse découvrir le reste de son oeuvre sur le site francophone de référence sur Antonin Dvorak.

23 janvier 2011

Mème : Scrabble international

Nouvelle chaîne dans ma boîte mail, nouvelle analyse de mème sur ce blog (après la F-list, et fait-ou-pas) : le "Scrabble International".

Il s'agit d'une liste de mots de 6 lettres, à laquelle on doit ajouter un mot français :
- de 6 lettres pas encore présent dans la liste
- ayant exactement une lettre de différence avec le mot précédent (dont les lettres sont éventuellement réordonnées).

Sont ajoutés le prénom et la ville du participant, ainsi que sa date de participation. Voilà l'exemple de la liste que j'ai reçue (209 mots). J'en ai trouvé quatre autres sur le net, de 124, 85, 216 et 89 mots, qui montre que la liste a voyagé (par mail, pas sur la blogosphère apparemment) en Belgique d'où elle est partie, en France, en Algérie, en Suisse, au Canada, au Maroc... L'arbre de diffusion à gauche résume l'historique de ces listes.

Je me suis demandé quelle taille pourrait atteindre cette liste, en théorie. Eh oui, car en pratique, comme pour tous les mèmes, les participants ne suivent pas toujours les règles, éviter et tourbe sont deux fois dans la première liste, piéger et pingre dans la cinquième, et je ne parle pas de ceux qui oublient d'inscrire la date, ou prennent un malin plaisir à changer le format pour que je ne puisse pas récupérer toutes les infos facilement avec un script.

Bref, supposons que tout le monde suive les règles, le jeu correspond à construire un chemin qui ne repasse jamais pas le même sommet (en bleu dans l'illustration ci-dessous) dans un graphe :
- dont les sommets sont les mots français de 6 lettres
- dont les arêtes rejoignent deux mots qui ont une lettre de différence.
Quelles sont les propriétés de ce graphe ? Quelle est la taille du plus long chemin qu'il contient ? Est-ce que 6 lettres est la taille de mots la plus adaptée pour assurer le succès de ce mème ? Voici les quelques questions auxquelles je vais tenter de répondre dans ce billet, avant une suite éventuelle qui sera dédiée à une analyse des données des les 5 listes récoltées.

Première chose à faire, construire ce graphe à partir d'une liste de tous les mots français. Je récupère ça chez un collègue marseillais, regroupe les mots par taille en passant tout en minuscules et en enlevant les lettres accentuées : 2 mots de taille 1, 81 de taille 2, 427 de taille 3, 1799 de taille 4, 5897 de taille 5, 13931 de taille 6... Tiens tiens, ça augmente comme ça jusqu'à 50097 (taille 10) avant de redescendre. Mais la longueur du plus long chemin n'est pas directement reliée à la taille du graphe : certes, celui des mots de 10 lettres a plus de sommets, mais il est moins dense (moins d'arêtes), et contient donc probablement moins de longs chemins. Grâce à quelques scripts en Python, voici les réseaux obtenus pour les mots de taille 3, 4, 5, 6, 7, 8 (18 Mo pour le dernier...).

Première chose à faire, calculer les composantes connexes, les parties du graphes où toute paire de sommets est reliée par un chemin. Pour cela (merci Anaïs !) la bibliothèque iGraph en R fait tout le boulot. Téléchargez-la, installez-la (install.packages("igraph")), puis lancez le code suivant :
library(igraph)
g<-read.graph("http://philippe.gambette.free.fr/Blog/2011Scrabble/Mots6.graph.txt",format="ncol")
cc<-clusters(g)
cc$csize

On obtient une composante connexe de taille 13865, et 5 de taille 2. Pour avoir la composition des cinq paires :
V(g)[which(cc$membership==1)-1]
V(g)[which(cc$membership==2)-1]
...
Les 5 paires sont donc : {rococo, corozo}, {hiboux, bijoux}, {puffin, muffin}, {okoume, loukoum}, {zozota, zozote}.


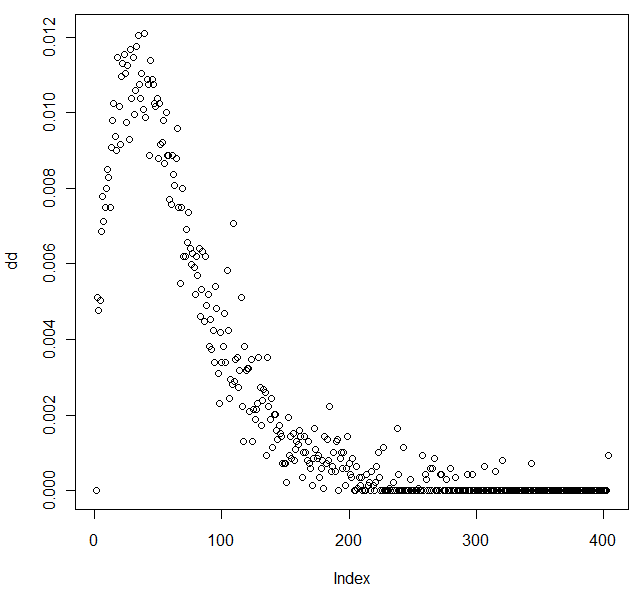
dd <- degree.distribution(g)
plot(dd)
On obtient l'image ci-contre, qui sent le Poisson...

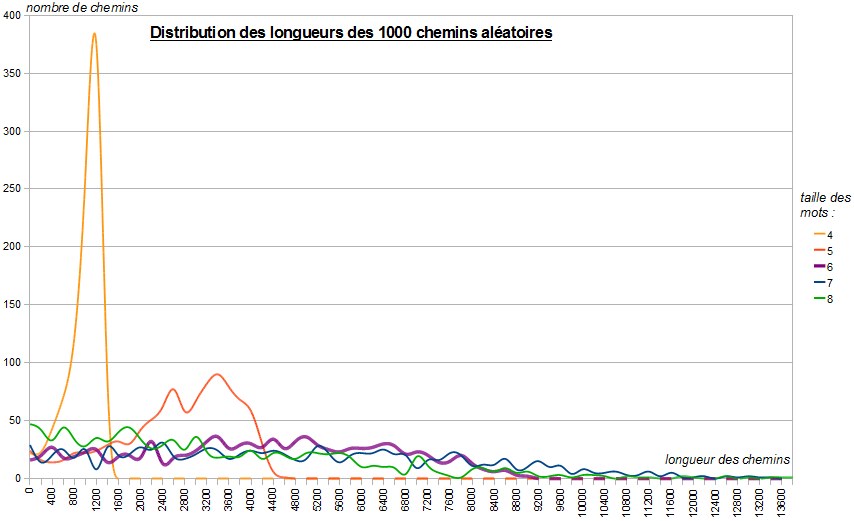
Quelle est la taille du plus long chemin dans ces graphes ? Eh bien ce problème est NP-complet (difficile à résoudre pour un ordinateur), et je n'ai pas encore essayé de le soumettre (pour les mots de taille 3, car je doute qu'il arrive à traiter un graphe à 10000 sommets et 400000 arêtes) au programme linéaire en nombres entiers récemment ajouté par Nathann dans Sage (au moins j'ai - enfin - installé le logiciel). En revanche j'ai programmé un script qui lance un millier de chemins au hasard, en partant d'un sommet également choisi au hasard, et enregistre la taille de chacun des chemins obtenus.

J'obtiens les valeurs moyennes suivantes : la longueur maximale parmi tous les chemins trouvés augmente jusqu'à 8 lettres inclus (je n'ai pas testé les graphes pour les mots de taille supérieure), en revanche la longueur moyenne des chemins atteint un maximum pour le graphe des mots de sept lettres (cliquez sur le graphique pour voir la distribution des longueurs de chemins obtenue) :
Vous me direz qu'en calculant simplement le degré moyen des sommets du graphe, on obtenait justement un maximum pour une taille de mots de 6, avec un nombre moyen de voisins de 28,7 qui correspond à peu près à la valeur où le pic de la loi de Poisson est atteint ci-dessus... J'aimerais bien savoir comment Eliane de Bruxelles a choisi la taille de 6 quand elle a conçu ce jeu. En tout cas c'était bien trouvé, et il ne reste plus qu'à trouver quelques milliers de participants pour commencer à rendre le jeu difficile... A moins que vous ne vouliez vous lancer dans une stratégie de blocage du jeu, en l'orientant vers un "cul-de-sac", soit en faisant revenir le chemin vers des sommets déjà visités, soit vers des sommets de faible degré...

Si vous avez participé au mème, et que vous avez une liste différente de celles montrées ci-dessus, ça m'intéresse, dans la perspective d'un prochain billet sur le sujet : indiquez en commentaire une adresse de page web où vous l'avez placée, ou envoyez-la moi par courriel en indiquant dans le sujet "Scrabble International". Et si vous voulez lancer le mème sur la blogosphère, faites-vous plaisir, en citant des blogs pour les inciter à propager la chose ! Plutôt des blogs féminins, au vu des prénoms dans mes listes...

31 mai 2010

Graphe orienté et politique : le cercle vertueux

Les graphes apparaissent rarement sur ce blog, alors qu'ils constituent l'une de mes thématiques de recherche. Une utilisation dans le cadre du débat politique me donne l'occasion d'en parler aujourd'hui.


Combats de chiffres parfois, d'égos souvent, de mots toujours, les débats politiques s'enlisent bien souvent sans faire apparaître clairement le fond du problème, sorte de plus petit commun désaccord. Des outils informatiques de brainstorming et de web-débat commencent à voir le jour pour structurer les discussions et les confrontations. Mais ceux que je connaissais ne me satisfaisaient pas au moment où nous avons commencé avec d'autres doctorants des universités montpelliéraines à débattre sur la future charte des thèses.

Un peu d'éléments de contexte avant d'aborder l'outil proposé. La charte des thèses existe dans les établissements d'enseignement supérieur pour donner un cadre à la préparation du doctorat. Ces chartes détaillent de façon plus ou moins poussée les droits et devoir des doctorants, de leurs encadrants, et des structures liées au doctorat. Selon les universités et les domaines de recherche, elles assurent aux doctorants un statut clair de professionnel de la recherche recruté sur un projet précis (en affirmant par exemple que tout doctorant doit être rémunéré) ou bien restent plus vagues, pour diverses raisons. Raisons historiques, contextuelles, et scientifiques se mélangent bien souvent dans les explications, il est difficile de faire le tri. Face à cette confusion, la Confédération des Jeunes Chercheurs tient un discours clair, argumenté et documenté sur le sujet.

J'ai donc essayé de regrouper l'ensemble de ces arguments dans une synthèse qui ferait apparaître la cohérence d'ensemble de ce discours, et permettrait rapidement de mettre le doigt sur les points de désaccord. Les arguments étant souvent liés les uns les autres, il semblait apparaître une sorte de cercle vertueux, et c'est cet aspect que j'ai essayé de mettre en valeur dans un graphe orienté (un ensemble de points reliés par des flèches), à l'occasion d'une pause MacDo par un sombre dimanche d'hiver. Les flèches s'interprètent comme des implications logiques, mais comme tout modèle mathématique, il s'agit d'une simplification de la réalité, où les flèches doivent plutôt être interprétées comme "conduisent à" ou "favorisent".

Il fallait ensuite passer de l'ébauche sur carnet Moleskine au document clair et utilisable, ça a été fait grâce à l'outil de dessin de Google Docs (afin de laisser la possibilité à d'autres participants de notre groupe de réflexion de modifier la figure), et aux conseils esthétiques de Paola et Alban pour mieux faire ressortir le cercle vertueux, et faire apparaître la charte des thèses, et ses effets sur le cercle, en position centrale :


Etape suivante, rendre la figure entièrement cliquable pour expliquer les flèches et les cases dans une interface très navigable. L'outil de création de maps HTML d'OpenOffice a permis de faire ça très rapidement, le résultat se trouve ici.

Résultat sur les discussions et le débat ? On y gagne une vision d'ensemble assez claire : ce cercle fonctionne bien actuellement pour les doctorants en sciences exactes, en revanche c'est moins le cas pour les doctorants en sciences humaines. La clé du débat est alors de savoir comment l'amorcer : en imposant de nouvelles contraintes sur les doctorants (obligation de financement pour s'inscrire en thèse, durée limitée de façon stricte à 3 ans), ou bien en améliorant les conditions d'encadrement et de travail en équipe ? La réponse est vite trouvée, et correspond à l'évolution en cours dans les écoles doctorales montpelliéraines en sciences humaines : EDEG, 58 et 60. Pour Droit et sciences sociales, le chemin à parcourir semble plus important...

C'est justement dans cette école doctorale qu'on nous dit que le "cercle vertueux" est inadapté, en ciblant les cases et les flèches qui ne sont pas correctes. L'insertion professionnelle dans le privé aurait peu de lien avec le bon déroulement de la thèse, en droit, et serait même à l'origine d'un grand nombre d'abandons de thèse. De plus, le rapport personnel et subjectif du doctorant à son sujet de thèse et aux textes de sa bibliographie, ainsi que la maturation de la réflexion nécessaire à produire un résultat de recherche intéressant, seraient à l'origine d'une impossibilité de borner une thèse à une durée maximale de trois ans. Là, toute la question est de savoir s'il s'agit d'un principe qui fait consensus en droit voire dans d'autres domaines scientifiques (philosophie ? littérature ?), ou si elle concerne seulement certains sujets de thèse exceptionnels qui demandent des durées adaptées en conséquence... auquel cas une simple exception à la règle, bien encadrée dans la charte des thèses, suffirait.

Verdict attendu suite aux discussions dans les écoles doctorales et les conseils scientifiques... En tout cas la phase de réflexion des doctorants est en train d'aboutir, grâce à une consultation de l'ensemble des doctorants montpelliérains, et ce graphe orienté aura contribué à faciliter le débat et sa synthèse.

27 avril 2007

Postures et énigme politicombinatoire

Avec les débats Royal-Bayrou demain et Royal-Sarkozy la semaine prochaine, on peut espérer que la campagne va toucher au fond des discours de chacun, après avoir plutôt touché le fond. La campagne du premier tour a été une succession de postures (et d'impostures ?).

Les trois candidats arrivés en tête ont tenu à incarner le politique nouveau, avec en particulier une liberté de ton rafraîchissante, à laquelle chacun a ajouté ses spécificités. Ségolène Royal s'est définie comme l'incarnation de l'ordre juste, de la femme, de la mère, du vote utile anti-Le Pen. Pour Nicolas Sarkozy, c'était la fermeté, la réforme ou rupture, et plus récemment le rassemblement. François Bayrou a commencé par être l'opposant aux puissances médiatiques, pour devenir le centriste en lutte contre le bipartisme, ou encore le vote utile anti-sarkozy.

Ces postures ont l'avantage d'être très faciles à médiatiser. Elles créent la polémique et peuvent facilement être démontées par les adversaires : les qualités mises en avant par le candidat sont retournées contre lui, ou tout simplement niées preuve à l'appui ou presque. Royal a donc subi le machisme et les accusations d'incompétence. Sarkozy est devenu un facho, ou l'héritier du bilan du gouvernement sortant. Bayrou, un utopiste sans majorité à l'assemblée profondément ancré à droite.

Le débat "proposition contre proposition" sur des questions précises n'a jamais été mis en avant à la télévision ou dans la presse écrite. Ce que j'aurais aimé avoir, ce n'est pas le catalogue de propositions de chacun des candidats, mais plutôt, sur chaque thème, les différents points de vue et les convergences. Des tentatives de synthèse ont été entreprises, mais elles ne faisaient pas apparaître clairement les consensus et les incompatibilités. C'est une démarche que j'aurais attendu de la part des centristes : combien de points du pacte présidentiel de Ségolène Royal seraient acceptés aussi par Nicolas Sarkozy ? On en a vu défiler, des pactes ou questionnaires (celui de Nicolas Hulot, du collectif AC Le Feu, des langues, le questionnaire sur les logiciels libres...) : ce sont devenus des packs de propositions ne donnant lieu à aucun débat contradictoire, aucun résumé synthétique.

Et les sites qui prétendaient avec une série d'une vingtaine de questions calculer votre similarité avec tous les candidats ? Où sont les tableaux des réponses des candidats à ces questions ? Pour une fois qu'on aurait pu avoir un avis clair (voire binaire) à des questions censées nous déterminer politiquement de la part de tous les prétendants...

On a préféré la politique spectacle, plus facile à "vendre", et plus ludique. Attention, je ne le critique pas totalement : déjà, ça a permis d'atteindre presque 85% de participation au premier tour. Je vais même plus loin, c'est l'appréciable, voire nécessaire, première étape d'une démarche qui me plaît : commencer par des légèretés pour motiver à "mettre les mains dans le cambouis". Exprimé par Stefan Zweig dans La Confusion des Sentiments : "celui qui n'est pas passionné devient tout au plus un pédagogue ; c'est toujours par l'intérieur qu'il faut aller aux choses, toujours, toujours en partant de la passion." Et si on a droit à de vrais débats de fond calmes et intéressants dans les jours qui viennent, après la passion de l'avant premier-tour, la campagne présidentielle de 2007 sera réussie !

Et maintenant à moi d'illustrer cette démarche, en motivant un problème combinatoire par une petite histoire de politique d'image et de posture : le Problème du Club de Réflexion, que j'appellerais presque le problème du siècle (issu d'une discussion initiée avec Nergal)...

F.B. affirme n'avoir pas parlé à N.S. depuis 3 ans. Ces deux hommes appartiennent à un même club de réflexion, qui se réunit tous les mois de la façon suivante : parmi tous ses n membres, un certain nombre est invité à venir manger à l'Automobile Club de France. Ils peuvent alors discuter autour de tables de k personnes. Disons qu'il y a t tables. En pratique il paraît que k=7, qu'environ 300 personnes participent à chaque dîner soit t=43, et que le club a environ n=700 membres. La première question, facile, consiste à déterminer quelle est la probabilité que F.B. n'ait en effet jamais dîné à la même table que N.S. depuis 3 ans, en supposant que les organisateurs des soirées invitent et placent leurs membres aléatoirement à chaque fois.

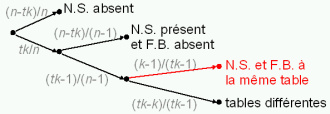
Calculons la probabilité à chaque réunion que F.B. ne soit pas à la même table que N.S. Est-ce que N.S. est là ? Il y a seulement tk invités, donc il n'est pas là avec proba (n-tk)/n. S'il est là, alors F.B. n'est pas là avec proba (n-tk)/(n-1), et il est là avec proba (tk-1)/(n-1). Si les deux sont là, alors une fois que N.S. est placé il y a k-1 chaises vides autour de lui, et il reste à placer tk-1 convives donc F.B. n'est pas à sa table avec proba (tk-k)/(tk-1). Comme on le voit avec l'arbre de toutes les possibilités ci dessous, on obtient la probabilité que F.B. ne soit pas à la table de N.S. à une réunion par la formule :

P=(n-tk)/n + tk/n ((n-tk)/(n-1) + (tk-1)/(n-1).(tk-k)/(tk-1))


Soit pour les valeurs de n, t et k données une probabilité de 99,6309% que F.B. et N.S. ne se rencontrent pas à une certaine réunion. On élève à la puissance 36 pour chacune des 36 réunions en 3 ans : il y a 87,5% de chances qu'ils n'aient effectivement pas mangé à la même table pendant tout ce temps...

La deuxième question, beaucoup plus compliquée, consiste à trouver la stratégie de placement des organisateurs. On considère raisonnablement qu'ils veulent que tout le monde parle avec tout le monde. Quel est donc le nombre minimum de réunions à effectuer pour qu'en effet tout le monde ait mangé au moins une fois avec tout le monde ? Et comment inviter et placer les membres pour atteindre ce minimum ? En déduire le nombre maximal de réunions consécutives où N.S. et F.B. ne mangent pas à la même table.

Si on prend la restriction de ce problème avec n=tk et k=2, ça revient à un problème d'organisation de tournoi d'échecs : on a n participants, et on fait jouer en parallèle t parties, en cherchant à minimiser le nombre de parties permettant que tout le monde ait joué contre tout le monde. Cela nous permet d'introduire de la théorie des graphes : on considère le graphe complet, c'est à dire qu'on relie un ensemble de 2k sommets (les joueurs) par toutes les arêtes possibles, chaque arête correspondant à une partie d'un joueur contre l'autre. On va colorier les arêtes de telle sorte que les couleurs correspondent à des parties qui peuvent se dérouler en parallèle, c'est à dire que deux arêtes partageant un même sommet n'auront pas la même couleur. On cherche à minimiser le nombre de couleurs, c'est à dire l'indice chromatique du graphe complet à 2k sommets. Le problème, classique ("promenade des demoiselles"), est résolu ici : 2k-1 couleurs (donc 2k-1 parties) suffisent, vous avez même la configuration des parties !

Pour le cas général je cherche encore, quelques variantes du problème sont réunies sur cette page...

1 avril 2007

Analyse du buzz F-List de la blogosphère francophone (2/3)

Le voilà enfin, l'arbre de diffusion de la F-list que je promettais il y a une semaine :

Cliquez sur l'image pour naviguer sur l'arbre et voir à quel blog correspond chaque point. Cet arbre donne tout de même une bonne interprétation du déroulement du phénomène : on peut voir un certain nombre de paliers qui rythment la transmission de la F-liste, c'est à mon avis là qu'il faut chercher les sites influents de la blogosphère (parmi les participants). Le site dont la F-list a été reprise directement le plus souvent est sendtofriend, dont le noeud, repassé en bleu dans l'arbre, a 11 fils (on remarque toutefois que ces fils ). La profondeur de l'arbre (la longueur de la plus longue chaîne, indiquée en rouge) est 18 :
Xavier - Bozarblog - BAO - 2ro - Jérôme Bouteiller - Bertrand Duperrin - Activeille - Démodéouss - Le web a meilleur goût - Mimie In Vivo - Planetargonautes - Marcus Retais - Luc - Woueb - Loneline - Ataegina - William Peres - Art pour tous.

Je détaille la méthode de construction, que je tenais à faire de façon automatique, et qui s'est révélée moins efficace que prévu. La principe de la F-list était qu'un blogueur B reprenait celle du blogueur A par qui il l'avait découverte, pour y ajouter ses propres liens favoris. Théoriquement donc, si la liste est transmise du blogueur A vers le blogueur B, celle de B contient celle de A. L'idée était donc de construire le graphe d'inclusion des F-listes, c'est à dire un ensemble de points (ou "noeuds") représentant chacun une F-liste, qu'on relie par une flèche (un "arc orienté") si une des listes contient l'autre. Si l'on dessine ce graphe, il est assez illisible à cause de la transitivité de la relation d'inclusion : si A contient B et que B contient C, alors A contient C, il y a donc des arêtes "superflues" dans le graphe. Les éliminer correspond à l'opération de réduction transitive, décrite dans la figure ci-dessous. Pour tout arc reliant A à B, s'il existe un arc reliant B à C et un arc reliant A à C, alors celui reliant A à C est superflu donc il faut l'effacer.

Si l'on effectue cette opération le plus de fois possible, on obtient un diagramme de Hasse qui représente très lisiblement les inclusions entre les listes étudiées, comme on le voit sur la figure ci-dessous (à côté de chaque noeud j'ai mis un exemple de F-list contenant les liens a, b, c, d, e ou f, le sens des flèches correspond au fait qu'une liste en contient une autre, c'est donc le sens inverse du sens de transmission des listes).

En faisant un tel traitement des listes, je comptais obtenir un arbre (où les branches ne se rejoignent jamais). En fait, le cas représenté dans la figure ci-dessus, c'est à dire que deux blogueurs ajoutent indépendamment les mêmes blogs dans leur liste (b c et d dans la figure), apparaît assez souvent, pour une quarantaine de listes. Je suis donc allé vérifier dans chacun de ces cas douteux où le blogueur disait avoir trouvé la liste (pour certains, comme Miss Tics, j'ai encore un doute...). Dans d'autres cas, le blogueur avait fait une erreur en recopiant la liste (ou avait choisi de ne pas la recopier).

J'ai donc vérifié l'ensemble de l'arbre, et le résultat de la méthode automatique n'est pas vraiment brillant : 77 erreurs d'identification du "père" sur un ensemble de 184 F-listes. Il faut tout de même relativiser ce taux d'erreur de 42% en notant que de nombreux blogueurs ont publié des F-lists ne respectant pas scrupuleusement les règles, qui n'étaient pas tout à fait claires (il n'était pas évident qu'il fallait ajouter les blogs lus régulièrement à la fin de la F-list, ce qui aurait pourtant facilité l'interprétation des listes, les chaînes de diffusion se trouvant alors en début de liste).

Conclusion : l'épisode 3 !

12 février 2007

VisualisationMétro est GI-complet

Les InformationArchitects sont partis d'une carte du métro de Tokyo pour proposer une visualisation intéressante des sites web les plus connus ou les plus tendance. Est-ce qu'il est facile de programmer un logiciel qui ferait un travail similaire avec d'autres données, d'autres cartes de métro ? Plus précisément, qu'en est-il de la complexité théorique de ce problème, qu'on appellera VisualisationMétro ?

Formalisons un peu le problème tout d'abord. Disons qu'on a une liste quelconque de termes (de sites web par exemple), une liste quelconque de thèmes qu'ont certains de ces termes en commun, ainsi qu'un plan de métros. VisualisationMétro consiste à déterminer s'il existe algorithme polynomial (c'est à dire que le temps de déroulement de l'algorithme sera proportionnel à un polynôme en la taille des deux listes) pour savoir si l'on peut étiqueter les stations de métro par la liste de termes, et chaque ligne de métro par un concept de telle sorte que deux termes partagent un même thème si et seulement si les deux stations correspondantes se trouvent sur la même ligne de métro.

Si vous trouvez une solution à ce problème, n'hésitez pas à me la communiquer ! En effet, VisualisationMétro est équivalent (plus précisément se réduit en temps polynomial) au problème d'isomorphisme de graphes : on a deux graphes (disons, de même taille n), c'est à dire des ensembles de "noeuds" numérotés de 1 à n dont certains sont reliés par des arêtes, et on veut savoir si on peut numéroter les noeuds du premier de telle sorte qu'il soit identique au deuxième. La complexité de ce problème est une question ouverte depuis plus de trente ans : on ne sait s'il est polynomial ou NP-complet (un problème NP-complet, on peut en donner une définition "économique" : vous serez millionnaire si vous trouvez un algorithme polynomial pour le résoudre, ou que vous montrez au contraire qu'il n'en existe pas. De façon plus intuitive c'est un problème qu'il est très long de résoudre de manière exacte avec un ordinateur). Pour avoir une idée des algorithmes utilisés en pratique pour résoudre efficacement un problème d'isomorphisme de graphes, lisez la synthèse (en anglais) de Scott Fortin : The Graph Isomorphism Problem.

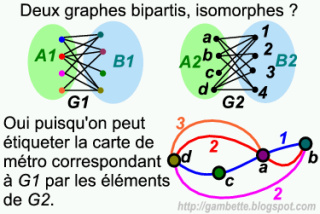
Regardons de plus près la réduction de isomorphisme de graphes à VisualisationMétro. Déjà, on va montrer que le problème d'isomorphisme de graphes se rapporte au problème d'isomorphisme de graphes bipartis (l'ensemble de noeuds d'un graphe biparti peut être découpé en deux ensembles V1 et V2 tel qu'il n'y a aucune arête entre deux noeuds de V1 ou entre deux noeuds de V2). Pour cela, supposons qu'on a deux graphes G1 et G2, dont on veut savoir s'ils sont isomorphes (identiques à réétiquetage près, donc). Transformons chaque arête en deux arêtes un chemin constitué de deux arêtes consécutives : on obtient deux 2-subdivisions : G'1 et G'2... qui sont des graphes bipartis, et qui sont isomorphes si et seulement si G1 et G2 sont isomorphes ! Donc si on avait un algorithme polynomial pour savoir si G'1 est isomorphe ou pas à G'2, on saurait si G1 est isomorphe ou pas à G2.

Deuxième étape maintenant. Supposons qu'on a deux graphes bipartis G1 et G2, dont on veut savoir s'ils sont isomorphes, et qu'on connaît un algorithme pour résoudre VisualisationMétro. G1 et G2 étant des graphes bipartis, les sommets de G1 sont découpés en deux ensembles de sommets indépendants A1 et B1, on fait de même avec G2 pour obtenir A2 et B2. On crée alors la carte de métro suivante : les lignes de métro correspondent aux éléments de A1 et les stations aux éléments de B1, et pour tous les éléments de B1 reliés à un certain élément a de A1, les stations correspondant à ces éléments de B1 seront sur la ligne associée à a. Ensuite, on considère les éléments de A2 comme des termes, et ceux de B2 comme des thèmes et on exécute l'algorithme résolvant VisualisationMétro. On l'exécute une nouvelle fois en considérant A2 comme des thèmes, et B2 comme des termes. G1 et G2 sont isomorphes si et seulement si au moins une de ces deux exécutions montre qu'on peut faire correspondre les deux listes à la carte.

Alors évidemment, les InformationArchitects n'ont pas commencé par s'arracher les cheveux en se demandant s'ils étaient assurés de pouvoir placer leurs sites web et leurs thèmes sur une carte de métro, mais ils ont certainement procédé de façon heuristique, en trouvant une méthode (commencer par placer les noeuds de plus fort degré peut-être ?) pour être à peu près sûrs d'obtenir un résultat à peu près correct, à défaut d'être tout à fait exact. Par exemple, en comparant en détail avec la carte du métro de Tokyo, on remarque que certaines stations ont été oubliées. Ce qui ne change rien à l'intérêt de la visualisation, puisque les "petites stations" où ne passe qu'une ligne sont moins connues et identifiables au premier coup d'oeil que les "grandes" qui sont bien étiquetées par des noms de sites web. Et puisque la visualisation a un intérêt autre qu'esthétique plutôt pour ceux qui connaissent bien la carte de départ, y ont des repères, il pourrait être intéressant de faire ça sur la carte du métro parisien. A suivre...

1 juin 2006

Créations lexicales et graphe sémantique

Une question intéressante en commentaires du dernier post de Jean Véronis. Spinodo - Charles Mougel a dit…

Quel est la probabilité, pour qu'une personne, associe ces deux mots, au cours de sa vie ?
- "ordre" et "juste".
Il me semble qu'il est loin d'être nul. Car ordre et la justice, sont tout de même des notions qui reviennent souvent dans le vocabulaire politique ou religieux, non ?
Quelles sont les chances de naissance indépendante de ce couple de mots ?
Depuis un petit moment déjà, j'ai comme projet de créer un petit graphe sémantique à partir d'un dictionnaire : des points, chacun représentant un mot, sont reliés s'ils sont souvent cités dans une même définition du dictionnaire, ou si l'un est cité dans la définition de l'autre, la longueur des liens étant proportionnelle à une certaine distance. J'espère que ce truc pourrait donner un graphe qui rapproche bien (en terme de plus court chemin entre deux points) des termes entre lesquels on peut faire des associations d'idées facilement.

Si c'est le cas, la distance entre deux mots, par exemple "ordre" et "juste", pourrait refléter la probabilité que les deux mots soient naturellement associés par un individu lambda, la probabilité que le couple "ordre juste" soit créé (peut-être faudra-t-il au passage vérifier/imposer au passage que le groupe de mot créé soit grammaticalement correct). La comparaison entre la probabilité théorique de création des couples (d'après le dico) et la création effective se ferait en comparant ces distances et les distances Google (Normalized Google Distance). Le nombre de couples de mots "créés" par une seule personne étant vraisemblablement plus rares que ceux apparus naturellement (plusieurs créations indépendantes), on peut attendre que les deux distances soient en général cohérentes... les exceptions représentant justement les créations lexicales d'une seule personne.

Bon, bon, je suis peut-être trop optimiste... et surtout créer le graphe sémantique demande un certain temps de programmation que je n'ai pas, donc pas moyen de faire une petite vérification rapide de ce que j'espère. Un week-end tranquille en juin, peut-être...