Affichage des articles dont le libellé est traduction. Afficher tous les articles

20 avril 2010

Sous-titrage xkcd : 100% !

J'ai eu le plaisir de valider ce matin la 729ème traduction en français d'une vignette xkcd, qui a permis d'atteindre les 100% dans la petite barre de progression d'xkcd.free.fr !

En à peine moins de 500 jours, avec un total de 100 participants (dont les 20 plus actifs ont réalisé 90% des traductions), toutes les vignettes de xkcd ont été sous-titrées en français. Merci donc à useless, Djool, Antoine, justt, Manutaust, I5, pascal, Zuiter, Kith, Yun-Kang, PH TRIVIER, Jmfork, Mutte, Lolouf, François, Quark, Arnaud R, Eniotna, Anouck, Anonyme, Di@bl@l, Nicomm, Tejgad, Malta, relaurelius, Nitrec, LS, cwoodin, Romain, Lagierl, anonyme, Iain, Pierre Ligot, brazzmonkey, Jules.LT, Xavier, Phersv, Kasui, Oaz, iuchiban, GG, neurone, Christophe, Alice, Carrot, Le pti yo, Fanch, crox, Romu, Takhiarel, Sioc, CaptainDangeax, egogramme, azerwhite, ianux, Thieums, Yves, Alexis, P., Nightgeek, DVLish, DenisQC, Bab, Niaatan, J. Ruaud, irqy, Cynoid, Baudelaire, Bernard Tribot, PL, wed, cerca, Wen, Philippe MacKay, Yves Roumazeilles, Arnaud, Johngeek, medard, AmideLanval, Delphine, Padreik, RJL, Egogramme, Guilac, seb, Ozh, oDn, Aelfgar, Nic, Em, Christophe Thill, Fractal, raph, dgryski, Ha3, Christophe S., mrlargo, Krom et kercoz.


Le graphique ci-dessous montre l'évolution de la traduction. J'ai indiqué pour les 14 plus gros contributeurs le moment où ils avaient particulièrement participé :

Je précise tout de même que ce graphique n'indique pas la difficulté de la contribution. En participant dès le début, j'ai pu traiter les plus simples et donc participer sur une grosse quantité. Au contraire, ceux arrivés plus récemment ont eu le courage de s'attaquer à quelques gros morceaux (je pense par exemple à Nicomm pour le 24, Manutaust pour la Blogofractale, ou encore brazzmonkey pour le 472).

Merci également à ceux qui ont fait connaître ce projet, en particulier Astrid Girardeau dont l'article dans Libération/Ecrans a bien augmenté le nombre de visiteurs, ou encore MacGeneration et CommentCaMarche.

Le projet peut maintenant passer dans une autre phase. Outre bien sûr la traduction au jour le jour, il faut désormais améliorer les traductions existantes (j'ai un gros mois de retard sur la modération de ces améliorations), et passer de cette version sous-titrée à une version "en VF", traduite directement sur l'image. Heureusement, Phiip a commencé ce travail sur xkcd.lapin.org de façon indépendante il y a quelques semaines, il avance vite et bien, et pourra utiliser ou améliorer les traductions d'xkcd.free.fr.

Deux flux RSS à ajouter donc : celui d'xkcd.free.fr pour continuer à recevoir les textes des traductions le jour de leur sortie, et celui d'xkcd.lapin.org pour recevoir les images au fur et à mesure de leur traduction !

Encore une fois bravo et merci à tous, l'aboutissement (relatif) de ce projet d'équipe constitue une excellente motivation pour en terminer un autre, qui m'occupe depuis près de 3 ans... Et bon courage pour les traducteurs allemands (145/729), espagnols (204/729) et russes (422/729) !

Episodes précédents : traduction d'xkcd et loi de Pareto (31 mars 2009), xkcd en français (13 décembre 2008)

31 mars 2010

Comment translater les titres de films (2)

J'avais proposé dans un billet précédent une petite typologie de la traduction des titres de films, et je vois ressortir ce sujet un peu partout, en particulier au début du mois dans un article de Julien Jouanneau pour Le Post. Il y notait en particulier une utilisation assez importante du mot "enfer" dans les traductions de titres anglais et américains.

Dès 2007, je m'étais lancé dans la récupération d'un corpus de titres et leur étiquetage selon cette typologie. Il est temps de mettre à disposition mes données et mes premiers résultats, même si leur quantité et leur qualité est améliorable, je pense qu'il y a des choses intéressantes à en tirer.

Quelques infos sur ces données pour commencer (n'hésitez pas à me demander le droit d'édition du fichier en commentaires si vous voulez participer à l'étiquetage !). Elles ont été récupérées automatiquement sur le site Allociné, ce qui est à l'origine de quelques erreurs sur la date de sortie : celle mentionnée est la date de dernière sortie cinéma en France, ce qui peut être une date de reprise. J'ai donc le projet de corriger cela un de ces jours...

Les films ont alors été étiquetés de la manière suivante :
- F pour un titre français,
- O pour un titre anglais gardé en français,
- D pour une traduction littérale de l'anglais,
- T pour une traduction un peu plus subtile voire complètement différente,
- A pour une traduction "fashion", de l'anglais vers autre chose en anglais,
- N pour une traduction "note du traducteur", où le titre anglais est gardé mais complété par des mots en français,
- C pour une traduction "censure", où le titre anglais est tronqué,
- S pour une traduction "sans the", où le titre anglais est gardé mais en enlevant le premier "the" (Da Vinci Code, Last Kiss, etc.).
- la lettre ci-dessus doublée quand il s'agit du même phénomène avec une autre langue que l'anglais.

Bref, j'arrive à une base étiquetée de plus de 1600 titres traduits de films dont la dernière sortie a eu lieu dans les années 1967-1974, 1982-1984, 1994, ou 2002-2006 : vous devinez que j'ai recherché des évolutions dans les habitudes de traduction... Et effectivement il semble avoir des variations, avec de plus en plus de titres gardés sous leur forme originale et de moins en moins de traductions littérales, et peut-être également un engouement ces dernières années pour les traductions "fashion" et "sans the". A confirmer quand la qualité et la quantité des données sera améliorée bien sûr.

Pour voir si d'autres mots comme "enfer" étaient particulièrement choisis dans les traductions subtiles, on peut extraire toutes les traductions subtiles d'une part (549 dans la colonne F), toutes les traductions littérales d'autre part (283 dans la colonne G), et comparer le vocabulaire qu'elles utilisent.

J'extrais donc la liste des mots les plus fréquents dans chacune de ces deux catégories avec Dico, puis je les compare en les explorant avec un multinuage de mots (les tailles des mots en bleu reflètent le nombre d'occurrences dans le corpus des traductions littérales, en rouge dans celui des traductions subtiles) :
Attention toutefois un corpus a une taille deux fois plus importante que l'autre, il faut donc visualiser les fréquences, avec Lexico3 par exemple, voici les mots du nuage avec les différences de fréquences les plus significatives :


Le mot "roi" est donc moins utilisé dans les traductions subtiles, alors que "mort", "enfer", "affaire" et "secret" y sont plus souvent employés. Attention toutefois : si l'on calcule les spécificités avec Lexico3, aucun de ces mots n'apparaît comme statistiquement sur-représenté dans un des deux corpus. Le fait qu'"enfer" ne soit pas présent dans les traductions littérales et 6 fois dans les traductions subtiles peut donc être dû au hasard. Plus de données permettra peut-être de conclure... avis aux amateurs qui voudraient participer à l'étiquetage du reste de la base !

En tout cas voilà les titres à traduction subtile contenant le mot "mort" : Side Street (La rue de la mort), I'll Sleep When I'm Dead (Seule la mort peut m'arrêter), The Bourne Supremacy (La mort dans la peau), Touching the Void (La mort suspendue), Kiss of Death (Le carrefour de la mort), Double Indemnity (Assurance sur la mort), Stepping Razor - Red X (La vie et la mort de Peter Tosh), Battletruck (Le camion de la mort), Still of the Night (La mort aux enchères).

D'ailleurs, le mot avait bien été gardé pour la traduction officielle du titre du film Deathproof de Tarantino. A sa sortie, TFM Distribution avait lancé un concours de traduction, je ne sais pas quel titre avait finalement gagné, mais le titre officiel "Boulevard de la mort" fait bien apparaître ce fameux mot-clé, et a apparemment conquis Tarantino, même s'il a fait causer des dizaines de cinéphiles.

31 mars 2009

Traduction d'xkcd et loi de Pareto

Le projet de traduction d'xkcd, conçu en un week-end et lancé début décembre, a plutôt bien démarré : 2/3 des planches de Randall Munroe sont maintenant traduites en français ! C'est plus que les versions russe (299/562) et espagnole (150/562)... pour une raison simple : le projet est collaboratif ! (Bon, et on traduit en dessous, et pas sur les images, aussi, hein, il faut reconnaître que c'est plus rapide). Une trentaine de personnes a participé : quelques amis, et une majorité d'internautes que je ne connais pas (vous pouvez vous signaler en commentaire de ce post afin que j'ajoute un petit lien sous votre pseudo dans la liste des traducteurs ;)).

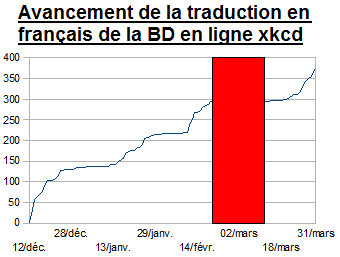
Voici quelques données sur l'avancement du projet, au cas où vous voudriez vous lancer dans une aventure similaire. Tout d'abord, la chronologie de l'avancement du projet. J'ai indiqué par une bande rouge une période d'indisponibilité de l'interface de traduction (du 21 février au 13 mars) qui avait échappé à mon attention, le reste du site étant fonctionnel. La forme de la courbe en escaliers correspond à l'arrivée de participants motivés, qui se lassent au bout d'un moment, ou ont fini de traduire tout ce qui les intéressait (ou pensent que le site est cassé, à partir du 21 février :s).

Passons justement à la distribution des contributions. Pour la Wikipedia anglaise, Aaron Swartz nous apprenait en 2006 que 2% des contributeurs font presque 75% des modifications de l'encyclopédie. Pour la traduction d'xkcd, les pourcentages de participation des divers traducteurs se trouvent ici (quand plusieurs collaborateurs ont contribué à la traduction d'une planche, je leur attribue naturellement l'inverse du nombre de contributeurs et je divise finalement ces scores par le nombre total de planches en anglais pour obtenir les pourcentages). Notons que ces pourcentages ne prennent pas en compte la longueur des traductions réalisées (tout comme l'étude d'Aaron Swartz d'ailleurs), ce qui ne rend pas vraiment compte, par exemple, du travail de Kith sur la série à propos du Ministre de l'Internet. Toujours est-il que ces données font apparaître une loi classique : la loi de Pareto ! 20% des utilisateurs (les 6 plus gros collaborateurs) ont réalisé 80% des traductions. Ce soir, le nombre précis est même 79.62%, ce qui semblerait donc moins "élitiste" que la Wikipedia !

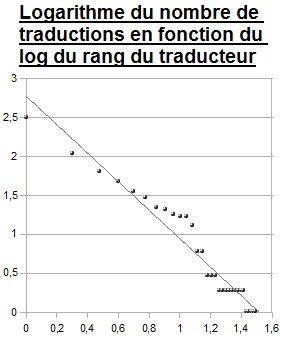
En fait, on voit même apparaître une distribution de Pareto (une loi de puissance qui vérifie la règle des 80-20), comme nous le montre la courbe log-log ci-contre.

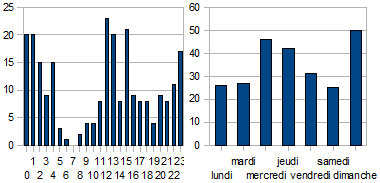
On peut aussi avoir un aperçu des horaires et des jours de la semaine où les traducteurs montrent le plus d'activité (j'ai exclu les valeurs me concernant) : valeurs anormalement élevées le dimanche, à midi, et en pleine nuit, tout ça rappelle les habitudes de surf des étudiants.
Un petit aperçu de ces traductions, maintenant, avec le nuage arboré des mots apparaissant plus de 10 fois, ci-dessous. Je ne l'ai pas annoncé en grande pompe, j'attends une jolie interface web pour ça, mais ça y est (enfin), un outil pour créer des nuages arborés avec plein de paramètres personnalisés est disponible sur www.treecloud.fr (ou treecloud.org pour les anglophones). Attention, c'est un outil en ligne de commande, qui nécessite un détour par le manuel d'utilisation, en anglais. Mais ça en vaut la peine : le programme permet d'obtenir de jolis résultats, en particulier grâce à la coloration "chronologique" : les mots du nuage arboré ci-dessous apparaissent plutôt rouge s'ils se trouvaient dans les premières planches de xkcd, plutôt bleu s'ils sont beaucoup présents dans les planches récentes. On est en train, avec Jean, de tenter d'ajouter à ça des informations sur la dispersion des mots : plus de nouvelles quand ce sera prêt !
Et si ce nuage arboré vous intrigue, allez jeter un oeil à ces traductions de xkcd, ou abonnez-vous au flux RSS pour recevoir les dernières traductions dès qu'elles sont validées ! A propos, petit aparté sur le spam : les robots n'ont pas tardé à trouver le site et envoyer des traductions bien peu fiables, incitant plutôt à l'achat de petites pilules bleues, mais le flux reste faible (un spam par jour en moyenne) et la procédure de modération manuelle permet d'éviter de les laisser passer.

Pour finir, un grand merci à tous les participants à la traduction ! Internet est de plus en plus collaboratif, alors si vous avez un peu de temps, profitez-en pour vous lancer dans quelques aventures. C'est l'occasion de faire un peu de pub pour les JeuxDeMots, et Pti Clic, qui, dans le genre de Google Image Labeler ou VideoTagName, sont en train de construire petit à petit un magnifique réseau sémantique, à faire pâlir Wordnet. Les données récoltées sont en plus mises à disposition en format brut, ou consultables par des interfaces web, qui peuvent déjà être utilisées pour retrouver, par association d'idées, ces mots qu'on a sur le bout de la langue. Le premier jeu permet d'aider le système à apprendre des relations sémantiques entre mots (synonyme, contenu/contenant, lieu d'une action, etc), et le second (dont on devient vite accro, même en jouant au touchpad...) de renforcer ou préciser ces relations. Le meilleur moyen pour comprendre le principe est de tester en mode invité, et le meilleur moyen pour comprendre l'utilité des données produites est de les utiliser dans des applications diverses... ce qui ne manquera pas d'être fait bientôt sur ce blog !


Comme toujours, les données liées à ce billet sont disponibles : dans ce fichier tableur Open Office. Et le nuage arboré à ouvrir avec SplitsTree pour pouvoir zoomer, etc. Il a été construit par SplitsTree et TreeCloud avec une stoplist française, et les options distance=hyperlex minnb=11 window=100 unit=1 color=chronology.

Episodes précédent et suivant.

13 décembre 2008

Xkcd en français

xkcd est une mine d'illustrations pour les enseignants en informatique, et j'ai décidé cette année d'illustrer chaque séance des TP de système/réseau que j'assure en L2 avec un dessin traduit pour l'occasion.

Les difficultés sont multiples : choisir le dessin tout d'abord. Car parmi les quelques centaines de l'auteur, Randall Munroe, il faut en trouver qui ont un rapport plus ou moins direct avec la séance du jour, et je remercie Arnaud de m'avoir fait profiter de sa mémoire et de sa connaissance pointue de xkcd pour m'éviter d'être bloqué sur la fin.

Autre problème, la traduction. Ces courtes vignettes faisant appel à un vocabulaire spécialisé sont assez difficiles à traduire en restant aussi concis. Quand il faut en plus gérer des problèmes de culture geek dont l'équivalent français n'existe pas, ça devient mission impossible. Quant au texte alternatif, c'est souvent difficile même d'y comprendre la blague.

Encore un obstacle, la réalisation. Retrouver une police de caractères qui ressemble à l'écriture - en majuscules - de Randall Munroe n'est pas évident. On trouve quelques essais ici ou là. La police International Playboy, qui contient même la plupart des majuscules accentuées, donne un résultat convenable.

Enfin, dernier problème : la publication et les droits d'auteurs. Eh bien ce n'en est pas un, puisque xkcd est publié sous licence Creative Commons autorisant justement les modifications !

Alors, qu'attendent tous les geeks de France pour lancer une vraie interface collaborative de traduction d'xkcd ?

Il y a eu quelques essais, mais la plupart n'ont pas survécu à quelques dizaines de dessins. Le total, recensé ci-dessous, permet tout de même d'arriver à 11% de la BD. Mais attention, la qualité de traduction n'est pas toujours au rendez-vous :
21 45 77 86 86' 123 129 132 148 156 163 169 171 185 191 195 198 202 208 208' 218 221 224 227 231 232 233 242 244 247 275 275' 287 290 302 302' 303 307 323 327 327' 329 341 342 343 344 345 349 350 353 374 377 378 378' 385 385' 386 397 399 400 405 411 411' 414 425 425' 426 427 428 429 432 433 434 435 436 441 444 445 447 448 451 453 456 456' 469 479 488 488' 530

Si l'on veut lancer une traduction massive, l'idée serait de permettre une collaboration. Difficile si l'on travaille directement sur les images. J'ai donc préparé une interface de traduction d'xkcd en français qui fonctionne seulement en ajoutant le texte sous l'image. Ceux qui le voudront pourront ensuite créer les images, en y insérant ces textes. Pour arriver à une bonne qualité, je propose le système suivant :

  • n'importe qui peut envoyer une traduction
  • des modérateurs (moi pour l'instant, mais si je peux vous faire confiance, j'accepterai certainement de vous ajouter à la liste) se chargent de la valider pour qu'elle apparaisse sur le site, et de choisir la meilleure (et donc bye bye les robots spammeurs !).
Le système est réalisé en PHP/MySql, sur une structure très proche de celle utilisée pour le guide de Pessoa sur Lisbonne. L'adaptation à d'autres langues sera donc très facile (contactez-moi si vous êtes intéressé par les sources). Et bien sûr, je compte sur vous pour proposer des traductions ! Il suffit de cliquer sur l'image voulue, puis compléter le formulaire, en utilisant éventuellement le lien vers l'image originale pour l'avoir sous les yeux pendant la traduction. Et surtout n'oubliez pas l'infobulle, qui apparaît quand on laisse traîner la souris sur l'image !


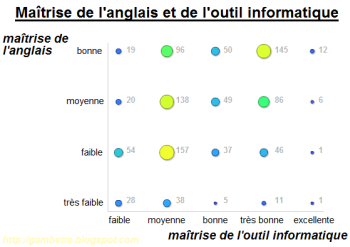
Alors bien sûr, vous allez me dire que la traduction des xkcd est un peu inutile, vu que la connaissance de l'anglais fait partie de la culture geek. Ce n'est pas complètement faux. Un sondage a été organisé cette année pour évaluer la familiarité avec l'outil informatique de tous les entrants en licence de la Faculté des Sciences de l'Université Montpellier 2, dans le cadre d'une UE préparant à l'examen du C2I (Certificat Informatique et Internet). Un millier d'étudiants a répondu, et voici les résultats des deux questions suivantes :

Si, sur internet, vous arrivez sur une page écrite en anglais :
  • vous n'y comprenez rien
  • vous y déchiffrez quelques mots
  • vous pourriez la comprendre en cherchant le sens de quelques expressions
  • vous la lisez en comprenant la plupart des phrases
À propos du contenu de cette unité FLIN102, vous pensez :
  • que vous aurez du mal, qu'il y aura beaucoup (trop ?) de choses à découvrir,
  • que ça ira en suivant les TP, et en les travaillant en plus chez vous,
  • que suivre les TP vous suffira pour apprendre des choses et les retenir,
  • que vous connaissez déjà une bonne partie des choses enseignées en TP, mais que vous en découvrez quelques unes,
  • que suivre les TP est pour vous complètement inutile, vous savez déjà tout ou presque.

Comme vous pouvez le constater, la maîtrise de l'anglais augmente en même temps que la maîtrise de l'outil informatique. Alors peut-être que les fous d'ordinateurs continueront à se précipiter sur la version originale de la BD, et que la traduction leur servira seulement en cas de problème. Peut-être qu'ils profiteront de leur maîtrise de la langue pour faire profiter d'xkcd aux allergiques à l'informatique pour lesquels quelques planches sont tout à fait accessibles.


Episodes suivants : traduction d'xkcd et loi de Pareto (31 mars 2009), sous-titrage xkcd : 100% ! (20 avril 2010)

10 janvier 2007

Comment translater les titres de films (1)

La traduction des titres de films est un exercice périlleux, pas toujours réussi à en croire les commentaires sur internet. Le magazine Première révèle en tout cas les coupables du choix du titre des films : les distributeurs. Ce sont donc eux qui ont inventé le concept ultime : la traduction de l'anglais vers l'anglais ! Avant d'atteindre ces sommets de ridicule, regardons quelques autres cas particuliers d'adaptations de titres de films sortis en France en 2006.

La version "censure" consiste à décider que le public français ne mérite pas de connaître la totalité du titre américain, alors on l'abrège ! C'est le traitement qui a été réservé à Basic instinct 2 (Basic Instinct 2 : Risk Addiction), Slevin (Lucky Number Slevin), Block Party (Dave Chappelle's Block Party), Love Song (A love song for Bobby Long).

Au contraire, la version "note du traducteur" garde le titre original mais ajoute quelques mots pour le rendre plus compréhensible, comme dans les cas suivants : Alex Rider : Stormbreaker (Stormbreaker), Inside man - l'homme de l'intérieur (Inside Man), Le Secret de Brokeback Mountain (Brokeback Mountain), Jarhead - la fin de l'innocence (Jarhead). Je dois tout de même avouer que c'est parfois judicieux, comme la substitution de Truman Capote à Capote.

On arrive maintenant aux deux formes que je préfère. La première, c'est la version "sans the". Ces décisions sont certainements prises par des distributeurs traumatisés par la prononciation du "th" dans les cours d'anglais de leur enfance, alors ils se vengent sur Da Vinci code (The Da Vinci Code), Last kiss (The Last Kiss), Fast & Furious : Tokyo Drift (The Fast and the Furious: Tokyo Drift), Fog (The Fog), et bientôt History Boys (The History Boys).

La seconde, la plus belle, la traduction "fashion", d'un anglais que les français comprennent pas, vers un anglais que les français comprennent ! C'est sûr que l'espace de Shop girl (Shopgirl) était vraiment nécessaire pour saisir le message profond du film. De même tout s'élaircit quand on lit Lucky girl (Just My Luck), Sexy dance (Step Up), Big Mamma 2 (Big Momma's House 2), Basket academy (Rebound), Girls in America (On the outs), Baby Boy Frankie (The Blast of Silence), Dance with me (Take the Lead), The Last Show (A Prairie Home Companion), Coast Guards (The Guardian) et bientôt Bad Times (Harsh Times). Une seule exception me paraît justifiable : Sexy movie, dans la lignée des Scary Movies, qui sonne bien mieux que le Date Movie original. Mais dans ce cas, pourquoi est-ce qu'il n'avait pas été utilisé dans la version originale ? Comme le suggérait un internaute dans une page du forum Allociné citée ci-dessus, cela peut venir de l'existence préalable d'un film ayant déjà ce titre. Cherchons sur Google si "Sexy Movie" correspond à un autre film ? Damn, les résultats sont parasités par les pages françaises sur le film, et je ne vois pas de bouton "chercher uniquement dans les pages anglophones". Mais on peut simuler ce bouton, il suffit d'interdire la présence de mots français fréquents n'existant pas en anglais, par exemple "est" et "une", et on obtient notre résultat !

A quand remonte cette pratique de traduire de l'anglais vers l'anglais, qui me semble assez récente ? Je me souviens de Phone game (Phone Booth) en 2003, mais avant ça, je ne vois pas.


La suite (3 ans plus tard) ici !

15 octobre 2006

Croissance quadratique des traductions européennes

Emission très intéressante sur Europe 1 hier, annoncée par Jean Véronis la semaine dernière. En bonus de la discussion sur la cyberlangue qui sera certainement approfondie dans un livre comme évoqué en fin d'émission, le co-animateur Nicolas Delourme évoque à la mi-temps l'explosion des demandes en traduction des institutions de l'Union Européenne (traductions effectuées par la Direction Générale de l'Interprétation) avec l'élargissement, déjà évoqué par exemple dans un article de La Libre de 2003.

Et là les mathématiques sont un poil malmenées. Nicolas Delourme commence par citer les langues actuellement gérées : anglais, allemand, français, italien, espagnol, néerlandais, grec, portugais, sudéois, danois, finnois et depuis l'élargissement de 2004, estonien, hongrois, letton, lituanien, maltais, polonais, slovaque, slovène et tchèque.

Pour calculer le nombre de sens de traductions, c'est simple, on a 20 langues-sources à traduire, et pour chacune 19 possibilités de langue-destination, soit 380 possibilités. Ce qui nous donne, pour n langues, n(n-1) possibilités de sens. Au passage, dommage que les interprètes/traducteurs ne soient apparemment pas parfaitement billingues, ce qui diviserait ce nombre par deux (il faut d'après ce calcul un interprète du français vers l'anglais, et un autre de l'anglais au français). De toute façon la croissance du nombre de sens de traductions en fonction du nombre de langues est quadratique (proportionnel au carré du nombre de langues) et pas exponentiel comme le dit Nicolas Delourme :

"Et comme le nombre de possibilités, pour utiliser un terme qui va plaire à Jean Véronis, comme le nombre de possibilités est exponentiel, à chaque fois que l'on rajoute une langue, la DGT doit aujourd'hui faire face à 380 combinaisons possibles, aussi bien en traduction de texte qu'en interprétation de discours."

Alors évidemment, le terme "exponentiel" est certainement plus parlant que "quadratique" pour évoquer une hausse importante. Mais il faut bien avoir à l'esprit qu'une complexification quadratique (ou même polynomiale) d'un problème par rapport au temps est tout à fait maîtrisable, grâce par exemple à la loi de Moore, qui nous promet que nos moyens de calculs bénéficient d'une croissance exponentielle : les performances sont doublées à peu près tous les 2 ans, les prix divisés par deux dans la même période. Et même plus généralement que cette "loi" qui s'applique typiquement sur le champ restreint du matériel informatique, on attend généralement du chiffre d'affaire d'une entreprise, ou du PNB d'un état, une croissance constante en pourcentage, soit une valeur en hausse exponentielle par rapport au temps.

Ainsi, tant que chaque langue ne donne pas naissance à 2 langues-filles à chaque décennie (ce serait rigolo, que la communauté européenne multiplie le nombre de ses langues par deux en considérant la version SMS de chacune...), le budget nécessaire à la traduction gardera une progression quadratique tout à fait gérable.

Evidemment, l'existence de la loi de Moore ne constitue pas un prétexte pour se dire qu'il est inutile de chercher à faire des économies en étant plus efficace, et le système de langues pivots qui consiste à avoir une traduction en deux temps (3 interprètes pour la langue actuellement parlée, un vers l'anglais, un vers l'allemand et le troisième vers le français, ainsi qu'un interprète d'une de ces trois langues vers chacune des 19 langues) est intéressant dans l'optique d'une économie de moyen (même s'il est nécessaire en pratique pour éviter de rechercher des interprètes du lettonien au portugais...). Mais le résultat du calcul mentionné par Nicolas Delourme est erroné, il compare les 380 possibilités des traductions exhaustives, à 60 dans le cas des langues-pivots (détail sur le travail des "interprètes relayeurs" page 9 de ce document) :

"Ce procédé permet déjà de limiter le nombre d'interprètes à 60 pour un régime complet de traduction. [...] 60 interprètes seulement pour 380 combinaisons possibles."

En fait, il faut pour chacune des 20 langues une traduction vers l'anglais, l'allemand et le français, ce qui donne 60, moins les traductions anglais-anglais, allemand-allemand, et français-français, ce qui fait 57. Et une fois que les traductions dans les trois langues pivot ont été obtenues, il faut les traduire vers seulement 17 langues, ce qui donne 57+17*3=108. De façon plus intelligente, on peut même traduire seulement l'une des 3 langues pivot vers une des 17 autres langues, soit un résultat total de 57+17=74 sens de traduction différents.

Cet exemple est typique d'erreurs que l'on peut faire lors de calculs de probabilités ou de combinatoire qui semblent très simples apparemment, mais qui s'avèrent cacher des cas particuliers ou des répétitions à considérer... Quoi qu'il en soit, ces calculs sont seulement théoriques puisqu'on n'emploie pas exactement un traducteur par sens de traduction comme expliqué dans l'article de La Libre...