Affichage des articles dont le libellé est nébuloscope. Afficher tous les articles

12 décembre 2007

tag cloud + tag tree = nuage arboré (1)

Vous avez déjà travaillé avec deux objets, pour vous rendre compte que combinés ils fonctionnaient vachement mieux ? C'est la vraie révélation du dernier article de Jean Véronis sur Aixtal !
Après lecture de son blog ou du mien, vous êtes convaincus qu'un nuage de mots dont la taille (et la couleur, j'apprécie beaucoup les teintes rouges, oranges, et bleues du Nébuloscope, introduites en partie chez TagCloud) reflète la fréquence, c'est très utile pour donner un aperçu rapide d'un texte ou d'un corpus. Vous êtes tout autant convaincus qu'un arbre phylogénétique peut donner un aperçu rapide de relations entre des mots-clés. Et quand on mixe les deux ? Je cite : "c'est marrant les arbres... ils peuvent nous raconter des histoires". Et voilà, un nouvel outil de visualisation d'histoires !

Dans l'exemple dédié à Laurence Ferrari, ce sont les résultats Wikio qui sont "passsés à la moulinette". Mais de la même façon qu'on peut effectuer un nuage de mots depuis un simple texte (avec TagCloudBuilder et une échelle de coloriage logarithmique bien sûr !), j'ai l'impression qu'un nuage arboré (tree-cloud pour nos amis anglophones) est encore un meilleur moyen d'avoir un aperçu rapide d'un texte. L'ordre alphabétique complètement artificiel des tags dans le nuage est remplacé par une disposition hiérarchique intuitive et informatrice !

Alors maintenant, quelle distance entre mots choisir pour reconstituer l'arbre, sur un simple texte ? J'ai fait l'essai suivant : pour chaque paire de mots, leur distance mutuelle est égale au log du nombre de mots minimal qui les sépare. J'avais déjà tenté de commencer à justifier théoriquement l'introduction du log pour certaines reconstructions "phylogénétiques" (la seconde partie du billet est toujours dans les cartons), là je l'introduis a priori seulement pour éviter quelques trop longues branches. J'ai prévu de tester quelques améliorations de cette idée : nombre de mots moyen séparant la paire de mots, éventuellement seulement sur les occurences les plus rapprochées de la paire...

Je garde ces préoccupations pour un éventuel billet suivant, et je livre un exemple d'application de ce principe, tiré du premier texte de longueur convenable que j'avais sous la main, une interview en anglais de Tom Sharpe. L'heure tardive ne me permet pas de mixer arbre et nuage de mots, les voici donc, à mixer mentalement (pour le moment) :
Pour la construction de l'arbre, j'ai gardé seulement les mots présents plus de 3 fois, et contrairement au nuage de mots, n'ai pas enlevé les mots très présents peu porteurs de sens (I, the, to, l'antidico quoi...), qui ne gènent pourtant pas vraiment dans l'arbre (is, of, in, the, he arrivent au niveau du centre).

Le choix de la distance conduit à certains rapprochement un peu artificiels, toutefois la plupart des sous-arbres ont un sens. Soit constitués justement de mots de l'antidico, donc à négliger, soit reflétant les principaux thèmes de l'article. En particulier le sujet général apparaît dans le sous-arbre {village,where,Tom,Sharpe}. Afficher le contexte au passage de la souris sur une feuille ou un sous-arbre serait donc particulièrement intéressant.

Du travail en perspective, donc. A suivre sur ce blog... et sur treecloud.org !

Les fichiers sources des images ci-dessus : fichier Nexus de l'arbre phylogénétique, mots et occurences, mots et occurences avec anti-dico manuel, nuage de mots de TagCloudBuilder, programme de construction de la matrice de distance format Nexus et source Delphi peu commenté pour l'instant.

4 janvier 2007

Arbre phylogénétique des députés

Bonne année 2007 ! 2007, qui sera l'année des élections présidentielles, même le Nébuloscope est au courant. Mais c'est aussi l'année des élections législatives, et donc l'occasion de revenir un peu sur les députés et leurs votes à l'Assemblée Nationale.

Je l'avais promis en juin, le voilà enfin après plusieurs jours d'efforts pour colorier ses feuilles : l'arbre phylogénétique des députés qui rapproche ceux qui votent de façon similaire.


Construit à partir des votes des députés qui se sont exprimés aux 43 derniers scrutins publics, soit depuis octobre 2004, l'arbre offre une jolie synthèse de ces votes.

On remarque tout d'abord que cet arbre a une forme assez linéaire, séparant parfaitement les groupes socialistes (en rose) et UMP (en bleu), avec l'UDF (en orange) qui s'égrène entre les deux. On peut aussi noter la présence de gros noeuds regroupant des députés qui votent de manière identique (vous trouverez la légende de ces noeuds ici). Sur plus de 500 députés, on n'obtient finalement que 69 feuilles dans l'arbre : assez déprimant, cette logique de vote très partisane, non ? Heureusement certains députés réputés pour ne pas suivre les mouvements généraux du parti apportent un peu de fantaisie en créant de nouvelles branches, comme Dupont-Aignan et Boutin à l'UMP. Les députés "apparentés" à certains partis se retrouvent aussi intégrés à la bonne place. Et les députés non inscrits (et donc sans couleur spécifique dans l'arbre) n'auraient pas trop de mal à trouver chez qui adhérer, à part peut-être Philippe Edmond-Mariette et Alfred Marie-Jeanne qui ont visiblement trouvé la position d'équilibre gauche-droite.

L'arbre a été construit à partir de SplitsTree et d'un programme maison pour le pré et post-traitement, comme détaillé (avec les données sources si vous voulez vous amuser) ici. L'idée de construire des arbres phylogénétiques d'hommes politiques n'est pas nouvelle, vous pourrez en trouver ici et là. Et pour les phylogénies construites à partir de distances de vote, j'ai vu ça pour la première fois par David Bryant avec les votes de pays à l'ONU.

30 novembre 2006

Nuages du projet socialiste et du programme UMP

Les militants UMP ont voté lundi dernier pour leur programme législatif pour 2007, cinq mois après l'adoption du projet socialiste par le PS. C'est l'occasion de comparer les deux textes, et voir si on peut y trouver un peu de l'originalité lexicale à la mode en ce moment, et identifier les thèmes et les termes chers à chacun.

Le projet PS étant plus court que le projet UMP, on ne comparera donc pas les nombres d'occurences (après avoir éliminé quelques mots "parasites" très fréquents dans la langue française et peu porteurs de sens, ce que fait très bien le programme Dico, voilà le fichier résultat pour l'UMP et le PS), mais les fréquences. En effet, quand on organise les mots par fréquence décroissantes , les courbes des fréquences sont tout à fait comparables :


Les simples nuages de mots font apparaître de nombreux mots identiques dans les deux nuages, avec des variations plus ou moins importantes, il est donc plus intéressant d'effectuer un "contraste" des deux nuages. Pour cela, une méthode expéditive : si un mot est plus fréquent dans le nuage de l'UMP que du PS, on le supprime du nuage du PS et on retranche à sa fréquence dans le projet UMP sa fréquence dans le projet PS (et inversement, ce qui nous donne les fichiers suivants pour le PS et l'UMP). Au passage on peut aussi ajouter les fréquences des termes trouvés dans les deux programmes, pour obtenir un troisième fichier, de fréquences de mots communs aux deux projets. Et là, un petit coup de Freecorp TagCloud Builder, pour obtenir les trois nuages ci-dessous :

Je suis étonné de voir "culturelle", "écologie", et "mondialisation" à droite, et "violence" à gauche, cela diffère un peu des idées reçues sur les préoccupations de chaque camp. Toutefois, celles-ci apparaissent tout de même très nettement, le nuage "commun" étant aussi révélateur sur les sujets chauds du moment. Un grand absent cependant, le terme "chômage" !

24 octobre 2006

Nuages de mots artisanaux

J'avais besoin il y a peu de temps d'un programme de construction de nuages de mots à la Nébuloscope pour visualiser les mots les plus fréquents dans des conversations de messagerie instantanée. C'est désormais chose faite avec Freecorp TagCloud Builder.

Ce petit programme gratuit consiste à charger une liste de mots avec leur nombre d'occurences dans un texte, fournie par exemple par l'utilitaire gratuit Dico de Jean Véronis. Après le réglage éventuel de quelques paramètres, le programme fournit une page html contenant le nuage de mots correspondant. J'ai naturellement choisi le style de nuages le plus joli que je connaisse... celui du Nébuloscope bien sûr (le code HTML des résultats du Nébuloscope est librement copiable, ça tombe bien ;)) ! Je trouve d'ailleurs très étonnant le succès des "tags clouds" ayant des styles beaucoup plus ternes, monochromes sur le site del.icio.us par exemple.

Passons un peu à la description des fonctionnalités du programme avant d'évoquer un problème technique. Le résultat du programme Dico appliqué sur un texte est une liste de mots au format texte détaillé ci-dessous :
N'importe quoi sur la première ligne
mot_le_plus_fréquent Nombre_d'occurences
deuxième_mot_le_plus_fréquent Nombre_d'occurences
...
(l'espace entre un mot et son nombre d'occurences étant en fait une tabulation)

Par exemple pour les mots les plus fréquents dans les avis cinéma de Monique Pantel (critique ciné dans l'émission On va se gêner de Laurent Ruquier sur Europe 1) :
Forme Fréquence
FILM 689
BEAU 149
PETIT 144
VOIR 142

Vous devez alors choisir le nombre de mots que vous voulez afficher dans le nuage (100 par défaut) et la largeur du nuage (300 pixels par défaut). D'autre part, les mots seront cliquables, un clic conduit sur une recherche Google de ce mot sur le site de votre choix, que vous pouvez configurer : c'est celui de la Wikipedia par défaut. La page web contenant le nuage est enregistrée par défaut dans le nom de fichier source, suffixé d'un ".html", et son code source s'affiche sur la fenêtre du programme, vous pouvez le copier/coller librement où vous voulez.

Un dernier paramètre est réglable, l'échelle. Ce réglage constitue le principal ennui technique des nuages de mots. Jean Véronis a apparemment réussi à le régler de façon admirable puisque les nuages font toujours bien apparaître en rouge/orange les mots les plus fréquents : ni trop ni pas assez. Il s'agit en effet de choisir à quelles plages de fréquences des mots on associe telle ou telle taille ou couleur dans le nuage. Supposons qu'on veut faire le nuage des 100 mots les plus présents, le plus présent l'étant 90 fois et le moins présent 40 fois. Sachant qu'il y a 10 variations possibles de taille/couleur, une stratégie pourrait consister à découper en 10 parties égales l'intervalle [40,89] des nombres d'occurences des 100 termes les plus présents. On écrirait donc en rouge et gras tous les mots présents entre 85 et 89 fois. En gris tout petit les mots présents entre 40 et 44 fois.

Mais rappelons-nous : les mots dans un texte sont généralement présents selon la loi de Zipf : peu de mots très présents, beaucoup de mots peu présents. D'un autre côté notre nuage doit aussi refléter cet effet, sans l'exagérer. Mais voilà ce qui se passe sur les avis de Monique Pantel si l'on choisit cette solution (image de gauche) :
Il faut donc renforcer un peu le poids des termes peu présents. J'ai donc essayé de considérer non pas les intervalles, mais les intervalles "passés à la racine", ce qui donne l'image de droite. Mieux, mais encore pas ça.

Quand on "passe les intervalles au log", on obtient un résultat à peu près satisfaisant qui montre bien l'enthousiasme de Monique pour certains films :
Ca reste toutefois peu robuste, et je réfléchis donc à une solution alternative, qui découperait l'intervalle des nombres d'occurences de façon "intelligente" par un algorithme de clustering des nombres d'occurences en 10 classes.

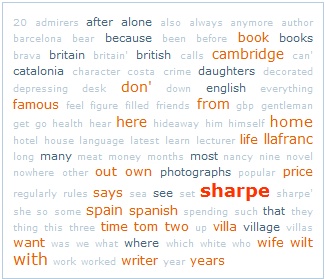
Voilà pour finir le nuage des 300 mots les plus fréquents dans les critiques de Monique Pantel de ces deux dernières années grâce à Dico et Freecorp TagCloud Builder !

31 août 2006

Connais-toi toi-même

Jean Véronis nous avait montré comment mieux comprendre les pensées et projets de Nicolas Sarkozy ainsi que "Valéry Giscard d'Estaing et ses amis" en analysant leurs discours et écrits. Et si le traitement automatique des langues vous permettait d'en savoir plus sur vous-même ?

C'est tout à fait possible si vous êtes utilisateur de messagerie instantanée, comme 48% des internautes français et plus de 300 millions de Terriens à ce jour. Enfin, à condition de cocher l'option de votre logiciel permettant l'enregistrement de vos conversations (sous MSN et GAIM en particulier c'est possible), et de bidouiller un peu pour en extraire les informations intéressantes (ou d'attendre la mise en ligne de l'analyseur automatique, quand j'aurai un peu avancé dans la todo list qui a occupé mon été au détriment de ce blog... et de mes vacances).

Rebaptisons vos amis (ou "relations", j'adore l'utilisation de ce terme chez copaindavant) Pote_i, i variant de 1 à... plus ou moins beaucoup, disons n pour rester discrets. Parmi ces n seront présents uniquement ceux que vous contactez régulièrement : en effet, des statistiques significatives ne fonctionnent que sur des données assez conséquentes. Disons plus de 1000 lignes (5000 mots). Appelons Moi_i l'ensemble de vos écrits à Pote_i, et Ami_i, l'ensemble de ses écrits à votre intention. Le premier problème pratique consiste à créer un fichier texte pour chacun de ces ensembles.

Pour Gaim, chaque conversation entre une ouverture et une fermeture de fenêtre est enregistrée dans un fichier à part. Chaque ligne est précédée par l'alias de l'interlocuteur qui parle. J'ai donc programmé un petit utilitaire pour sélectionner uniquement les lignes suivants certains alias sélectionnés. Merci au passage à ceux qui changent d'alias comme de chemise, ou de chanson de Rammstein dans leur playlist (suivez mon regard, ceux qui comprennent la private joke...). Donc bon, voilà, un fichier texte avec tout Ami_i, un autre avec tout Moi_i. Ou plutôt 2n fichiers pour mes n contacts MSN.

Et maintenant, on peut commencer l'analyse. Quels outils pour ça ? En attendant le bidule tout-automatique, décrivons une procédure "alla mano". Allez, commençons par ouvrir Microsoft Word et Excel (ou leurs équivalents libres OpenOffice, on décrit la procédure microsoft-friendly ci-après...). Word, c'est pour leur excellent outil de statistiques. Ironie mise à part, connaître le nombre de mots de votre fichier Ami_i et Moi_i (grâce au menu Outils, Statistiques) est une condition préalable pour toute analyse. En bonus vous avez le nombre de caractères et de lignes qui vous permet après divisions de connaître la longueur moyenne des mots que vous utilisez (4,5 à peu près pour moi, un pote égyptien avec ses "yo" et ses "mec" descend à 3,8), et celle de vos lignes (quelques passages enflammés me font monter à plus de 6 mots par ligne, alors que 4-5 semble plus répandu chez mes interlocuteurs).

Passons maintenant au coeur de l'analyse. Il s'agit d'extraire les mots les plus fréquents. C'est là qu'Excel vous filera un coup de main, en vous permettant de réserver une colonne pour lister les mots de Moi_i ou Ami_i, la suivante pour le nombre d'occurences de chacun, et la dernière pour les fréquences, en divisant la seconde par le nombre de mots du texte total. Ca, c'est pour jouer un peu : intuitez des mots que vous pensez utiliser fréquemment avec Pote_i, ou qu'il utilise fréquemment d'après vous, et mettez-les dans ce tableau. Pour en connaître le nombre d'occurences, en attendant mieux (paragraphe suivant), vous pouvez l'approximer en faisant un Ctrl H (rechercher-remplacer sous Word) et rechercher le mot voulu, le remplacer par lui-même. Cliquer sur Remplacer tout vous donne le nombre d'occurences trouvées. Une fois que vous aurez joué à ça, vous pourrez connaître les mots véritablement les plus fréquents, c'est le (déjà fameux) paragraphe suivant !

Nous cherchons à extraire de Moi_i et Ami_i les mots les plus fréquents avec leur nombre d'occurences. Pour cela, nous allons utiliser un programme de devinez-qui ? Jean Véronis ! Son pratique et rapide Dico. Installez le programme, exécutez-le, ouvrez le fichier texte contenant Moi_i et Ami_i, cochez éventuellement la case Antidico qui permet de cacher les mots les plus fréquents en français dans l'analyse, puis cliquez sur Filtrer. Et là, magique, en quelques secondes, la liste des mots avec leur nombre d'occurences, triable par ordre alphabétique ou par nombre d'occurences, s'affiche.

Et là vous pouvez commencer par finir le jeu qui consistait à deviner quels mots vous utilisiez le plus souvent dans vos conversations avec Pote_i. Vous serez impressionné d'avoir eu de très bonnes intuitions pour certains !

Mais allons plus loin, comment mieux se connaître avec cet outil ? Pour tous les fichiers Moi_i, calculez (en utilisant Excel sur les données de Dico) les fréquences des 50 mots les plus présents. Le faire pour chaque fichier vous permet de voir la variabilité des fréquences, afin de vérifier si la fréquence d'un mot est une constante dans votre conversation, ou si elle est spécifique aux conversations avec un de vos contacts MSN. Puis il s'agit de vérifier si cette haute fréquence est vraiment une de vos spécificités, ou si elle est présente chez tout le monde. En attendant mieux (héhé, un petit nébuloscope des mots les plus fréquents chez vous, contrasté avec le nébuloscope de ces mêmes mots cités par vos contacts), vous pouvez calculer la moyenne des fréquences de ces mots dans tous les fichiers Pote_i, et par exemple représenter le résultat pour les plus fréquents sur un histogramme dans Excel. Si vous voyez un mot au même niveau pour toutes vos barres de Moi_i, et à un niveau très différent pour la barre de moyenne dans Amis_i, vous avez identifié un peu de votre patois bien à vous ! Pour moi, j'aime bien "truc", "genre", "oué"...

Passons maintenant à l'identification de vos relations avec vos amis. Il s'agit là d'identifier les mots qui apparaissent souvent dans Ami_k + Moi_k, et peu souvent dans les Ami_i + Moi_i, pour i différent de k. Pas mal de "cours" avec une camarade de classe par exemple.

Bon, et évidemment on peut passer à une dernière application plus sournoise, celle d'en savoir plus sur vos amis. Vous serez par exemple surpris de remarquer les mots utilisés pour vous interpeler, vous saluer. Pour ça, bien sûr, comparer Ami_k, avec les Ami_i, pour i différent de k. Quelques autres mots intéressants, voire surprenants,dont vous pourrez aussi vérifier la fréquence : "merci", "tu", "je", "!".


La prochaine étape, c'est de mettre tout ça dans un logiciel en précisant que la divulgation d'extraits de correspondance personnelle sans l'avis de ses interlocuteurs est passible de x horreurs. Etape suivante, ajouter une couche d'apprentissage automatique afin de caractériser une relation entre individus à partir de leurs conversations MSN...

20 juin 2006

Explique les pics !

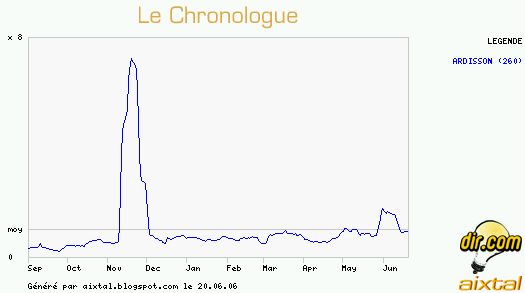
Jean Véronis nous disait récemment comment quantifier l'importance des pics observés dans les résultats du Chronologue, en appliquant un logarithme (pour se rapprocher de l'échelle de Richter) sur la différence max-min de la courbe. Mais comment expliquer la présence de ces pics ?

Google Trends le fait assez bien. Rappelons que ce site fournit une courbe similaire à celle du Chronologue : "popularité" d'un terme ou d'une expression sur le web par rapport au temps, la popularité étant ici évaluée en fonction du nombre de recherches sur le moteur Google. Et là, Google utilise Google News pour chercher dans les actualités de l'époque les articles se rapportant au sujet. Bel exemple d'interaction dans la Galaxie Google !

Mais la Galaxie Véronis en forte expansion elle aussi pourrait faire pareil, en utilisant... le Nébulsocope ! On commence par cibler l'emplacement du pic. Pour cela, appelons C(d) le nombre de résultats du Chronologue à la date d. soit d_m la date correspondant au maximum (global, pour le local il faudrait être un poil plus subtil, par exemple considérer la courbe de la fonction restreinte aux dates où C(max_local)) de C. On considère les deux dates les plus proches de d_m, une avant, d_b et l'autre après, d_a, qui sont à l'intersection entre la courbe de C et la courbe constante de valeur la moyenne de C sur toutes les dates (plus formellement : d_b = min{d > d_m / C(d_b) ‹ moy (C)}). On peut alors appeler le Nébuloscope sur la requête initiale (trucbidule), ainsi que sur la requête accompagnée des précisions de date : trucbidule dd>d_a dd<d_b. On choisit Contraster plutôt que Comparer, bien sûr, pour mieux extraire les spécificités du nuage de mot à la période ciblée.

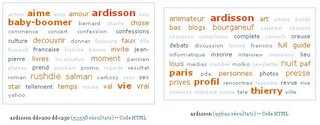
Un petit exemple pour comprendre : comment expliquer le pic d'Ardisson en novembre-décembre 2005 ? Google Trends le marque moins, et reste muet sur le sujet. Mais on peut identifier les dates de début et de fin du pic (à la louche) : il y a 230 jours, et il y a 200 jours. Appelons le Nébuloscope avec ces paramètres !
Les mots qui se détachent : ardisson, aime, vie, baby-boomer. Voilà les mots-clés qu'il faudrait indiquer sous les pics du chronologue ! En cliquant sur baby-boomer pour préciser, on voit qu'il s'agit de l'autobiographie de notre animateur vedette, Confessions d'un baby-boomer, publiée à l'automne 2005. Vivement le pic pour le bouquin de Jean Véronis et Louis-Jean Calvet...