Affichage des articles dont le libellé est phylogénie. Afficher tous les articles

12 décembre 2007

tag cloud + tag tree = nuage arboré (1)

Vous avez déjà travaillé avec deux objets, pour vous rendre compte que combinés ils fonctionnaient vachement mieux ? C'est la vraie révélation du dernier article de Jean Véronis sur Aixtal !
Après lecture de son blog ou du mien, vous êtes convaincus qu'un nuage de mots dont la taille (et la couleur, j'apprécie beaucoup les teintes rouges, oranges, et bleues du Nébuloscope, introduites en partie chez TagCloud) reflète la fréquence, c'est très utile pour donner un aperçu rapide d'un texte ou d'un corpus. Vous êtes tout autant convaincus qu'un arbre phylogénétique peut donner un aperçu rapide de relations entre des mots-clés. Et quand on mixe les deux ? Je cite : "c'est marrant les arbres... ils peuvent nous raconter des histoires". Et voilà, un nouvel outil de visualisation d'histoires !

Dans l'exemple dédié à Laurence Ferrari, ce sont les résultats Wikio qui sont "passsés à la moulinette". Mais de la même façon qu'on peut effectuer un nuage de mots depuis un simple texte (avec TagCloudBuilder et une échelle de coloriage logarithmique bien sûr !), j'ai l'impression qu'un nuage arboré (tree-cloud pour nos amis anglophones) est encore un meilleur moyen d'avoir un aperçu rapide d'un texte. L'ordre alphabétique complètement artificiel des tags dans le nuage est remplacé par une disposition hiérarchique intuitive et informatrice !

Alors maintenant, quelle distance entre mots choisir pour reconstituer l'arbre, sur un simple texte ? J'ai fait l'essai suivant : pour chaque paire de mots, leur distance mutuelle est égale au log du nombre de mots minimal qui les sépare. J'avais déjà tenté de commencer à justifier théoriquement l'introduction du log pour certaines reconstructions "phylogénétiques" (la seconde partie du billet est toujours dans les cartons), là je l'introduis a priori seulement pour éviter quelques trop longues branches. J'ai prévu de tester quelques améliorations de cette idée : nombre de mots moyen séparant la paire de mots, éventuellement seulement sur les occurences les plus rapprochées de la paire...

Je garde ces préoccupations pour un éventuel billet suivant, et je livre un exemple d'application de ce principe, tiré du premier texte de longueur convenable que j'avais sous la main, une interview en anglais de Tom Sharpe. L'heure tardive ne me permet pas de mixer arbre et nuage de mots, les voici donc, à mixer mentalement (pour le moment) :
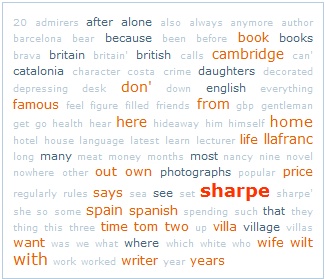
Pour la construction de l'arbre, j'ai gardé seulement les mots présents plus de 3 fois, et contrairement au nuage de mots, n'ai pas enlevé les mots très présents peu porteurs de sens (I, the, to, l'antidico quoi...), qui ne gènent pourtant pas vraiment dans l'arbre (is, of, in, the, he arrivent au niveau du centre).

Le choix de la distance conduit à certains rapprochement un peu artificiels, toutefois la plupart des sous-arbres ont un sens. Soit constitués justement de mots de l'antidico, donc à négliger, soit reflétant les principaux thèmes de l'article. En particulier le sujet général apparaît dans le sous-arbre {village,where,Tom,Sharpe}. Afficher le contexte au passage de la souris sur une feuille ou un sous-arbre serait donc particulièrement intéressant.

Du travail en perspective, donc. A suivre sur ce blog... et sur treecloud.org !

Les fichiers sources des images ci-dessus : fichier Nexus de l'arbre phylogénétique, mots et occurences, mots et occurences avec anti-dico manuel, nuage de mots de TagCloudBuilder, programme de construction de la matrice de distance format Nexus et source Delphi peu commenté pour l'instant.

23 octobre 2007

Dissection d'une pétition (3) : robustesse des résultats

Je reviens sur les résultats de mon dernier billet concernant les tendances horaires d'utilisation d'internet selon la catégorie professionnelle. Quelques éléments de tendance avaient été identifiés, et j'avais avancé dans chaque cas une cause pouvant les expliquer. A quel point ces tendances sont-elles réelles, pourraient-elles être dues à la procédure utilisée pour obtenir les graphiques ?

En général pour vérifier que des résultats trouvés à partir d'analyses statistiques sont corrects, on réeffectue tous les calculs en modifiant légèrement les données. C'est la technique de "rééchantillonnage" ou "bootstrap", particulièrement utilisée en phylogénie (c'est d'ailleurs cette étape de vérification qui traîne et m'empêche de terminer mon billet sur une proposition de "distance Eurovision").

Dans le cas de la pétition TouchePasAMonAdn je ne vais pas modifier les données de départ concernant les signataires, mais plutôt utiliser d'autres règles de regroupement de professions qui donneront donc lieu à un nouveau lot de données. J'avais précisé que les règles que j'avais utilisées pour interpréter les noms de professions entrées par les signataires étaient un peu arbitraires, j'obtenais finalement trois gros groupes (retraités, étudiants, enseignants), et un ensemble de groupes beaucoup plus petits. C'est en tombant sur l'analyse des statistiques sur la pétition EUCD.info que j'ai découvert d'autres règles de groupement de professions qui m'ont semblé meilleures (page 2). Sont-elles effectivement meilleures ? Est-ce qu'en les appliquant on obtient des courbes de tendances similaires ?

Première réponse : oui, les règles d'Eucd sont meilleures, puisqu'elles permettent d'identifier plus de professions. Mes règles personnelles appliquées sur les signataires du 4 octobre permettait de récupérer la profession de 50,5% d'entre eux. Avec les règles d'Eucd.info, j'arrive à 64,3% d'identification de la profession (les signataires de TouchePasAMonAdn ont "mieux" indiqué leur profession que ceux d'Eucd où ils atteignaient seulement 36,6% d'identification). Et en plus de la quantité, la qualité est au rendez-vous : les courbes sont beaucoup plus équilibrées, avec le groupe des "employés" qui passe en première position dans l'ensemble des signataires.

Seconde réponse : oui, les tendances identifiées sont toujours visibles, excepté peut-être le "repas de 13h" des journalistes un peu noyés dans la masse. La disjonction du groupe d'étudiants en post-bac et lycéens/collégiens permet aussi d'identifier une nouvelle tendance sur ces derniers (utilisation d'internet plutôt le soir).

On remarque aussi certaines courbes presque constantes, celles des cadres, des professions libérales, des fonctionnaires, groupes au sein desquels on ne peut donc pas identifier de comportement commun vis à vis de l'utilisation d'internet.

Enfin je m'étais bien gardé de comparer entre différentes professions les pourcentages de signataires trouvés (pour éviter de fausses impressions du genre "ceux qui ont le plus signé la pétition sont les employés", attention j'ai 30% de professions que je n'ai pas identifiées !), mais après cet avertissement je peux me permettre de comparer les pourcentages de signataires par profession avec ceux de la pétition EUCD.info :
Et là les pourcentages de signataires de la pétition TouchePasAMonAdn sont clairement plus représentatifs de la société française que ceux de Eucd.info. Je suis particulièrement étonné par la proportion de retraités : traduit-elle un plus grand intérêt pour cette pétition comme pour les enseignants ou les professions libérales, ou est-ce simplement un reflet de la forte augmentation du "taux de connexion" des retraités depuis 2 ans (la pétition EUCD a commencé fin 2005) ?

30 mai 2007

Eurovision, géopolitique et phylogénie, partie 1/2 : des pourcentages d'amitié aux distances d'amitié

Un peu plus d'un an que ce blog existe, je me permets donc de faire un petit bilan, avant de passer au sujet principal de ce billet, qui répond justement au premier posté ici l'an dernier, à propos de l'Eurovision.

Un rythme pas trop inégal d'un peu moins d'un billet par semaine, une collection de petits outils informatiques qui s'agrandit régulièrement (celui pour créer des nuages de mots, lancer de multiples requêtes Google, analyser les logs MSN), quelques idées de futurs billets en tête, tout cela m'incite à continuer dans la même veine. Surtout que ce blog m'est finalement très utile. Pour mettre à l'épreuve quelques idées reçues (sur la collusion des votes à l'Eurovision, la qualité des sondages...), ou quelques idées tout court (l'utilisation des moteurs de recherche pour l'orthographe et ses limites, le déclin de la qualité de traduction des titres de films...). Mais il m'a aussi permis quelques découvertes inattendues, sur la datation du big bang du web, la spécificité francophone de l'abréviation "MacDo" ou le syndrôme des moutons de Panurge chez les députés. Et je profite souvent d'avoir posté un billet pour approfondir un peu sur le sujet (certes, il serait préférable de le faire avant, mais je ne tiens pas vraiment à me lancer dans une étude biblio systématiquement...).

Je ne suis pas le premier à me féliciter des avantages du blog en tant qu'outil comunautaire, mais les discussions faisant suite à certains posts, qu'elles aient lieu sur le blog ou non, ont toujours été très enrichissantes. Et elles ont parfois rejoint directement un sujet de recherche scientifique "sérieux", que ce soit pour l'illustrer (le Voronoï des McDos parisiens par exemple, pour illustrer le jeu de Voronoï, ou la visualisation en plan de métro pour l'isomorphisme de graphes), le motiver (de nombreuses problématiques sur les distances en phylogénie), ou rester à sa frontière en attendant des liens éventuels (le corpus de la F-list et les modèles de diffusion ou les communautés dans les blogs). Bref, le blog qui s'introduit comme une des composantes de la méthode scientifique, ça me plaît bien, et je vais continuer à véroniser encore un peu...

Et pour aujourd'hui, ce sera un problème qui me trotte dans la tête depuis quelque temps déjà. Cela fait belle lurette que l'arbre phylogénétique a été utilisé pour représenter autre chose que des relations de parenté entre espèces ou gènes... C'est simplement un excellent outil de visualisation, qui est très expressif pour représenter des données séparées par des distances connues, plus en tout cas qu'un plongement dans le plan (en deux dimensions, parfois même plus expressif qu'un plongement en 3D...), bien qu'il soit planaire.

Le problème est que pour des applications non bioinformatiques, les distances utilisées doivent ressembler à des distances le long de branches d'un arbre pour que celui-ci soit vraiment expressif. On peut se rappeler de l'arbre des thèmes de la présidentielle de Jean Véronis construit à partir des "distances Google normalisées", qui était beaucoup plus expressif quand on fixait une longueur unitaire à toutes les arêtes de l'arbre. Si on ne le faisait pas, on obtenait une sorte d'étoile, avec des branches menant aux feuilles toujours très longues.

J'avais obtenu pour l'Eurovision l'an dernier un arbre assez satisfaisant, mais celui-ci représentait seulement les proximités de votes entre les pays : deux pays étaient rapprochés s'ils votaient de la même façon, et pas s'ils votaient l'un pour l'autre. Or ce second problème semble plus intéressant quand on désire quantifier les effets du vote d'amitié entre pays voisins. Reste à trouver une distance d(i,j) qui reflète que le pays i avantage le pays j dans ses votes, et inversement. Si vous voulez éviter ces détails techniques croustillants et passer directement aux résultats... vous n'avez plus qu'à attendre la seconde partie du billet

Un des défis est que la distance soit normalisée, c'est à dire qu'un pays n'ayant pas souvent participé, ou ayant reçu peu de points, ait des distances avec les autres comparables à celles d'un pays souvent présent au palmarès. Pour cela je propose donc l'approche suivante, qui m'a surpris par ses résultats qui semblent robustes (j'obtiens pour cette distance des arbres très similaires avec diverses méthodes de reconstruction, je reviendrai là-dessus...).

J'appelle P(i->j) le pourcentage des points donnés par le pays i au pays j, parmi tous les points reçus par le pays j. Un des avantages de cette approche est que le nombre de compétitions auxquelles ont participé i et j importe peu (ce qui est intéressant parce que par exemple l'Albanie n'a participé qu'une fois de 1975 à 2004, alors que la Grande-Bretagne était présente tous les ans). On dispose donc d'un ensemble de données normalisées P(i->j) pour chaque couple de pays, et on voudrait les transformer en données de distances qu'on note d(i->j). En particulier on veut qu'elles soient symétriques, c'est à dire que d(i->j) = d(j->i), et on veut que d(i->j) soit petit quand P(i->j) et P(j->i) sont grands, c'est à dire que d soit une fonction décroissante par rapport à P. Mais quelle fonction décroissante choisir ?

Pour trouver cette fonction convenable pour d, commençons par raisonner sur de petits exemples, c'est à dire de petits arbres binaires non enracinés où d est donc connue, et où on cherche à déterminer pour chaque noeud i des pourcentages P(j->i) raisonnables. On commence par l'arbre le plus simple possible, à 3 feuilles, en figure (a) ci-dessous. Chaque feuille étant placée à distance égale de ses deux voisins, les pourcentages des deux voisins doivent être égaux, c'est à dire par exemple pour la feuille 2 que : P(1->2) = P(3->2) = 1/2.
Supposons maintenant qu'on insère une feuille 4 dans l'arête qui aboutit à 3, comme illustré dans la figure (b). Le sous-arbre contenant 1 et 2 n'étant pas changé, on garde P(1->2) = P(2->1) = 1/2. Il reste donc 50% des points reçus par 1 à attribuer à 3 et 4, qui sont tous deux à la même distance de 1, donc : P(3->1) = P(4->1) = 1/4. En procédant de même pour chacune des autres feuilles, on obtient les pourcentages indiqués dans la figure (b).
De même, si on ajoute une nouvelle feuille, 5, on peut attribuer les points pour obtenir les pourcentages indiqués en figure (c). En fait la procédure pour attribuer les pourcentages de points de la feuille i peut se voir ainsi : on part de la feuille i et on parcourt l'arbre : à chaque embranchement rencontré, on divise par deux le nombre de points attribué par chacun des sous-arbres délimités par l'embranchement. Cette technique permet bien d'arriver à un total de 100% des points attribués, pour chaque feuille.

La formule est donc la suivante pour P en fonction de d :

P(i->j) = P(i->j) = 1/2^(d(i->j)-1),
ce qui donne pour d en fonction de P :
d(i->j) = 1 + log2 (1/P(i->j)),
et comme on veut que les distances soient symétriques, on fait la moyenne :
d(i,j) = (d(i->j) + d(j->i))/2.

Il reste à gérer un "léger" problème, celui des cas où P(i->j)=0, qui devrait donner une distance infinie. Quelle distance choisir dans ces cas-là, qui ne sont pas rares ? Difficile de choisir, je ne vois aucune façon naturelle de répondre à la question, et tous les essais que j'ai faits (choisir par exemple la plus grande distance dans la matrice pour ces cas-là, ou deux fois cette distance) donne des arbres avec quelques très longues branches au niveau des pays touchés par le problème. Ceci dit, il y a un moyen simple de régler le problème : corriger les données a priori !

Au lieu d'utiliser les données brutes, on va effectuer une sorte de lissage en ajoutant le fait que tout pays donne de toute façon un point à tout autre pays. Ainsi, en notant p(i->j) le nombre de points réellement donnés à j par i, au lieu de définir :
P(i->j) = p(i->j) / (Σk p(k->j)),
on définit :
P(i->j) = (1+p(i->j)) / (Σk 1+p(k->j)).
Ainsi, P n'est jamais nul, et l'arbre obtenu est plutôt convaincant... mais pour s'en rendre compte il faudra attendre la seconde partie de ce billet ;).

Je suis allé faire un petit tour dans la littérature concernant le concours de l'Eurovision, et les moyens utilisés pour estimer une "distance Eurovision" entre les pays sont assez variés.

Il y a une sorte de référence en la matière, l'article de Fenn, Suleman, Efstathiou et Johnson de 2005 (paru cette année dans Physica A) qui propose plusieurs critères quantitatifs :
- ils considèrent pour chaque année le graphe formé simplement en mettant les pays comme noeuds et une arête entre deux noeuds si un pays a donné un ou des points à l'autre. Ils comparent les coefficients de clustering, et la distribution des degrés (des paramètres classiques en étude de réseaux sociaux), de ce réseau par rapport à un réseau correspondant à un concours attribuant les points aléatoirement.
- pour dessiner un dendrogramme (une sorte d'arbre phylogénétique), ils ne se basent pas sur une distance indiquant l'affinité entre pays (qui était pourtant exprimée par le coefficient de clustering, et la distribution des degrés), mais reviennent à une approche plus classique de comparaison des votes, en utilisant le coefficient de Pearson (donc un peu plus sophistiqué que la simple somme des valeurs absolues des différences que j'avais utilisée l'an dernier), et en utilisant la méthode UPGMA pour la construction de l'arbre. En tout cas l'arbre obtenu fait bien ressortir quelques signaux forts d'affinité de goûts entre pays.

L'analyse de Gatherer de 2006 cherche à identifier localement les collusions entre pays et leur évolution, mais ne fournit pas de panorama global.

L'article de Dekker, The Eurovision Song Contest as a 'Friendship' Network, propose un "score d'amitié" intéressant : il estime un score attendu en fonction des résultats globaux, et le score d'amitié reflète la différence entre le nombre de points attendu et le nombre de points réellement obtenus. Toutefois, l'auteur indique que la construction d'un arbre phylogénétique n'est pas appropriée en utilisant ces scores : ajouter un bruit aléatoire de 0 à 0,1% pour altérer les données fournit des arbres assez différents. C'est justement sur ce point que j'espère que la formule de distance présentée dans ce billet sera plus robuste.
A noter aussi dans cet article le joli graphique en 3D représentant les points attribués entre pays en fonction de la proximité entre eux (calculée en terme de nombre minimal de frontières à traverser pour passer de l'un à l'autre).

Bref, tests et figures à venir, en attendant vous pourrez toujours aller voir la carte de l'Europe colorée en fonction des points attribués au concours 2007 sur Agoravox...

25 janvier 2007

Blanc bleuté plus qu'orangé

Le député apparenté UDF Christian Blanc a annoncé hier qu'il soutient Nicolas Sarkozy pour la présidentielle. Pas vraiment une surprise. Au cours de ma construction de l'arbre phylogénétique des députés, j'avais été étonné de le voir apparaître carrément à l'intérieur du groupe UMP. Puis, au fur et à mesure que j'intégrais des votes plus anciens, il migrait vers la frontière entre l'UDF et l'UMP, où il avait finalement abouti dans le bilan des 43 derniers scrutins publics. J'ai donc refait proprement l'arbre obtenu par la proximité de vote aux 15 derniers scrutins publics (avec de nouveau l'UMP en bleu, l'UDF en orange, le PS en rose, l'extrême gauche en rouge, et les apparentés en couleurs plus pâles), la feuille correspondant à Christian Blanc a été entourée en gris, et la scission de Nicolas Dupont-Aignan apparaît tout aussi prévisible :

4 janvier 2007

Arbre phylogénétique des députés

Bonne année 2007 ! 2007, qui sera l'année des élections présidentielles, même le Nébuloscope est au courant. Mais c'est aussi l'année des élections législatives, et donc l'occasion de revenir un peu sur les députés et leurs votes à l'Assemblée Nationale.

Je l'avais promis en juin, le voilà enfin après plusieurs jours d'efforts pour colorier ses feuilles : l'arbre phylogénétique des députés qui rapproche ceux qui votent de façon similaire.


Construit à partir des votes des députés qui se sont exprimés aux 43 derniers scrutins publics, soit depuis octobre 2004, l'arbre offre une jolie synthèse de ces votes.

On remarque tout d'abord que cet arbre a une forme assez linéaire, séparant parfaitement les groupes socialistes (en rose) et UMP (en bleu), avec l'UDF (en orange) qui s'égrène entre les deux. On peut aussi noter la présence de gros noeuds regroupant des députés qui votent de manière identique (vous trouverez la légende de ces noeuds ici). Sur plus de 500 députés, on n'obtient finalement que 69 feuilles dans l'arbre : assez déprimant, cette logique de vote très partisane, non ? Heureusement certains députés réputés pour ne pas suivre les mouvements généraux du parti apportent un peu de fantaisie en créant de nouvelles branches, comme Dupont-Aignan et Boutin à l'UMP. Les députés "apparentés" à certains partis se retrouvent aussi intégrés à la bonne place. Et les députés non inscrits (et donc sans couleur spécifique dans l'arbre) n'auraient pas trop de mal à trouver chez qui adhérer, à part peut-être Philippe Edmond-Mariette et Alfred Marie-Jeanne qui ont visiblement trouvé la position d'équilibre gauche-droite.

L'arbre a été construit à partir de SplitsTree et d'un programme maison pour le pré et post-traitement, comme détaillé (avec les données sources si vous voulez vous amuser) ici. L'idée de construire des arbres phylogénétiques d'hommes politiques n'est pas nouvelle, vous pourrez en trouver ici et là. Et pour les phylogénies construites à partir de distances de vote, j'ai vu ça pour la première fois par David Bryant avec les votes de pays à l'ONU.

8 juillet 2006

Teaser (suite) et parenthèse UNITAID

Eh oui, vous l'avez deviné en déchiffrant les Taubira, Montebourg ou Strauss-Kahn, l'arbre phylogénétique de mon post précédent était celui des députés en fonction de leur proximité de vote aux 6 derniers scrutins publics à l'Assemblée Nationale.

Evidemment c'est complètement illisible, non seulement à cause du nombre élevé de députés, mais aussi du fait que certains ont bizarrement l'étrange idée de voter pareil, ce qui les regroupe tous sur une "grosse" feuille de l'arbre. Vous imaginez aussi qu'un groupe a la fâcheuse tendance de voter tout le contraire de l'autre, d'où deux "grosses" feuilles de part et d'autre d'un arbre qui ressemble plus à une chenille (ou un peigne) qu'à un poirier taillé en U-espaliers.

Il n'empêche qu'ajouter des scrutins, et faire précéder le nom des députés par leur parti permettra certainement d'y voir un peu plus clair (des couleurs, ce serait encore mieux, mais pas facile de façon automatique...). Encore un peu de patience, donc.

On peut féliciter le webmaster du site de l'Assemblée Nationale pour sa clarté et la disponibilité de nombreuses informations. Jean Véronis nous avait déjà parlé des didascalies dans les compte-rendus intégraux des débats, les exclamations diverses de députés sont encore plus savoureuses, par exemple dans les derniers débats sur la DAVDSI. Mais le site propose aussi les relevés des votes des députés lors des scrutins publics, dans des fichiers facilement exploitables de façon automatisée.

Si ces pages peuvent donner l'impression que l'appareil législatif se met à la portée des français, ou des internautes, ce qui est très appréciables, quelques aspects du travail des députés reste un peu obscur.

J'aimerais bien qu'on m'explique exactement ce qui a bien pu se passer avec les députés William Dumas et Jérôme Lambert, "qui étaient présents au moment du scrutin ou qui avaient délégué leur droit de vote ont fait savoir qu'ils avaient voulu voter contre", mais qui sont quand même présents dans la liste des "pour" ! Enfin, tant mieux, ça permet de les différencier dans l'arbre phylogénétique ;).

D'autre part, ce qui concerne le vote de la taxe sur les billets d'avion afin de financer l'achat groupé de médicaments pour les pays pauvres, le projet FIAM/UNITAID, est assez obscur. L'idée a apparemment été lancé par les présidents Lula et Chirac dès 2003, et votée par l'Assemblée Nationale le 22 décembre 2005. Votée ? On va donc trouver sur le site assemblee-nationale.fr une grosse loi définissant précisément l'utilisation de l'argent ainsi récolté, et une journée de débats sur le projet et les détails de sa mise en oeuvre ?

Euh, non. Cette loi est juste un petit article (22 dans la version définitive, 18 dans le texte débattu) de la "loi de finances rectificative pour 2005". En effet, des discussions ont eu lieu sur le sujet avant le vote, mais les débusquer n'est pas chose facile. Il faut tout d'abord identifier l'emplacement du dossier concerné, puis jouer du Ctrl-F pour trouver les emplacements du mot "avion" dans le diverses pages de débats. C'est en fait la première séance du 8 décembre qui a été principalement consacrée au fameux article 18. Les discussions du 22 décembre précédant le vote final des députés y contiennent aussi quelques mentions.

Le projet n'était en tout cas pas clairement défini d'un point de vue pratique, et le projet ne commence à être connu du grand public qu'en juin 2006 (Chronologue, Google Trends). Entre temps, c'est visiblement le Ministère des Affaires Etrangères qui s'est chargé d'exporter cette idée dont certains députés regrettaient lors des débats la restriction au territoire français. De plus, des partenaires sont venus soutenir le projet, aider à le faire connaître au grand public. Parmi eux, la FIFA ou TF1, qui accorde un peu de publicité gratuite sur ses ondes (on apprend grâce à Patrick Fiori que le projet s'appelle phonétiquement "You Night Ed")... voire plus : ils apparaissent comme "registrant" du très officiel unitaid.eu créé le 22 avril 2006 d'après whois.eu.

Ce site contient entre autres une pétition à signer par internet ou SMS. D'après la publicité pleine de stars diffusée sur TF1, plus on sera à signer, plus les gouvernements étrangers seront incités à faire voter une loi similaire pour les taxes sur les billets d'avion dans leur pays. La liste des signataires nous montre que certaines des stars de la pub sont apparemment vraiment convaincues par le message qu'elles y incarnent :
05/06/2006 22:26 Florent PAGNY SMS
05/06/2006 22:27 NADIYA SMS
05/06/2006 22:28 Danny BOON SMS
05/06/2006 22:28 Gad ELMALEH SMS
05/06/2006 22:30 Lara FABIAN SMS

En revanche, pas de trace de Patrick Fiori, Nolwenn Leroy, Elie Semoun, ni Julien Clerc. Heureusement, ces absences sont compensées :

08/07/2006 23:10Zinedine zidane
SMS
11/06/2006 00:41Zinedine zidane
SMS
10/06/2006 20:03Zinedine zidane
SMS
08/07/2006 21:52Jacques Chirac
SMS
01/07/2006 18:37jacques chirac
SMS
11/06/2006 20:24Jacques Chirac
SMS

Enfin s'il faut retenir un point positif de ce projet qui semble encore difficile à définir et cerner, c'est bien que cette agitation un peu chaotique qui est passée dans divers états successifs (idée venant de 2 présidents, article de loi français, promotion d'une idée à l'international, centre d'un partenariat d'entreprises, pétition française...) semble tout de même converger vers une belle réalisation. Est-ce ça que les français attendent de leurs hommes politiques ? Qu'ils s'éloignent des cheminements habituels pour faire preuve d'originalité et finalement d'efficacité dans la réalisation de leurs idées ? L'année qui vient répondra certainement à cette question, tant en ce qui concerne les attentes des français... que de l'évaluation de l'efficacité d'Unitaid.

28 juin 2006

Teaser...

Pour fêter la sortie (le 12 juin) du logiciel de construction d'arbres et réseaux phylogénétiques SplitsTree 4.5 (avec, en écran d'accueil du logiciel, une jolie photo, de la Nouvelle Zélande, j'imagine), bientôt, sur ce blog, un nouvel arbre phylogénétique intéressant...

Ou pas... Vous voyez ce que ça peut être ?
24 mai 2006

Arbres phylogénétiques, le making-of...


Un petit tuto rapide pour construire l'arbre phylogénétique, en supposant que vous avez réussi à obtenir d'une manière ou d'une autre la matrice des distances entre les différentes feuilles de cet arbre.

La première phase, et la plus compliquée, c'est de mettre cette matrice au format NEXUS, dont voici un exemple (tronqué, c'est juste pour comprendre) pour les distances-Eurovision entre les feuilles constituées par les pays européens :

#nexus
BEGIN Taxa;
DIMENSIONS ntax=39;
TAXLABELS
[1] 'Europe'

[2] 'Albania'
...

[39] 'Armenia'
;
END; [Taxa]
BEGIN Distances;
DIMENSIONS ntax=39;
FORMAT labels=left diagonal triangle=both;
MATRIX
[1] 'Europe' 0 8.03446523273329 6.94527480392245 6.08492529025624 6.42978267610967 7.61404519345663 5.99341744182733 6.90728067447675 6.92250335008947 6.7219201517126 6.68265626349283 7.07664803208412 6.71800408960876 6.32663542414134 6.01095491165921 7.08036573532752 7.29275054598743 6.54337752800494 6.95284871559852 6.66293755351196 7.30356798161008 8.31770464286873 7.08408148781478 6.89202437604511 6.01970448643453 6.74926896633998 7.00939219533334 6.99435862906671 6.86907639526596 6.67477576986673 6.60342813696038 6.59146178203287 7.63130671012508 6.75316689827817 6.55944477757074 7.28191704086225 6.89202437604511 6.43796306466572 7.17635004706431
...

[39] 'Armenia' 7.17635004706431 7.68114574786861 8.24621125123532 6.48074069840786 8.36660026534076 8.24621125123532 7.21110255092798 7.74596669241483 8.60232526704263 7.74596669241483 7.74596669241483 6.92820323027551 8.48528137423857 8 8.36660026534076 8.24621125123532 8.94427190999916 7.61577310586391 7.61577310586391 6.78232998312527 7.74596669241483 8.94427190999916 9.16515138991168 8.60232526704263 7.34846922834953 7.21110255092798 7.34846922834953 8.48528137423857 7.48331477354788 7.74596669241483 8.60232526704263 8.12403840463596 8.71779788708135 7.34846922834953 7.87400787401181 8.83176086632785 6.92820323027551 7.34846922834953 0
;
END; [Distances]


Alors certes, si vous l'avez dans un fichier Excel par exemple, vous pourrez vous arranger pour l'exporter en .CSV, puis jouer avec RECHERCHER/REMPLACER pour obtenir des espaces entre les différentes valeurs dans votre matrice... Mais il vaut mieux programmer un outil qui le fasse tout seul. Pour l'instant, je n'ai fait que des utilitaires très spécialisés au code affreusement crade, donc non distribuables en téléchargement direct sur internet...

Une fois ce pénible travail réalisé, passons au miracle Splitstree (4) dont vous aurez téléchargé auparavant la version adaptée à votre système d'exploitation (eh oui, c'est fait en Java, donc multiplateforme...) qui va trivialiser la fin de la construction.

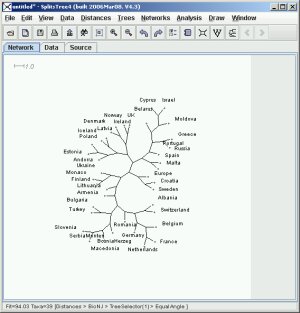
Vous exécutez donc le programme, voilà à quoi ça ressemble :

Cliquez sur le 3° onglet, Source. Copiez-collez le code NEXUS dans cette fenêtre (ou utilisez le menu File, Open...), puis cliquez sur l'onglet Network. On vous avertit que l'entrée a changé et on vous suggère de prendre en compte les modifications (Input has change, execute it?), ce que vous acceptez sans frémir par un Yes assuré. Et là un truc affreux apparaît, un réseau phylogénétique. Affreux parce que pas compréhensible par un oeil non exercé (en fait, le truc permet de visualiser plus d'informations qu'un arbre phylogénétique, mais bon, ne nous étendons pas là-dessus, et tentons plutôt d'obtenir un arbre classique...). Dans le menu Trees, choisissez donc BioNJ si vous êtes chauvin, NJ si vous voulez rédiger l'article Wikipedia qui explique la méthode, et UPGMA si vous vous moquez d'obtenir un mauvais arbre mais que vous tenez à savoir comment il a été construit. Disons que vous prenez BioNJ, cliquez sur le bouton Apply dans la fenêtre qui apparaît.
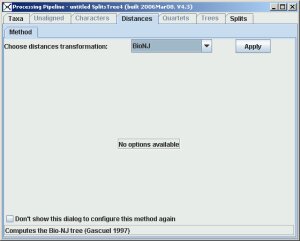
Vous pouvez alors fermer cette fenêtre pour avoir un aperçu du résultat. Vous pouvez tenter d'améliorer la lisibilité de l'arbre en choisissant le menu Draw, Equal Angle. Dans la fenêtre qui apparaît, vous pouvez augmenter le nombre de DaylightIterations, initialement à 0 (genre de 1 à 10). Cet algorithme d'optimisation du dessin de l'arbre tentera de bouger les branches de l'arbre afin de répartir le vide entre les branches de façon équitable. Concluez encore par Apply et en quittant la fenêtre. Si le dessin ne vous semble pas assez expressif, ce qui est le cas quand par exemple toutes les distances de la matrice sont très grandes (c'était le problème de Jean Véronis ici), vous pouvez choisir d'afficher des longueurs identiques pour toutes les arêtes de l'arbre (les portions de branches comprises entre deux noeuds). Pour cela, ça se passe aussi dans la fenêtre de Draw, EqualAngle, il suffit de décocher la case UseWeights.

Vous obtenez alors (après Apply et fermeture de la fenêtre) le joli arbre suivant :

Et voilà, il ne "reste" plus qu'à interpréter le résultat, et en faire profiter les internautes (en citant www.splitstree.org) ou la communauté scientifique (en citant D. H. Huson and D. Bryant, Application of Phylogenetic Networks in Evolutionary Studies, Mol. Biol. Evol., 23(2):254-267, 2006).

D'autre part, Splitstree recèle d'astuces diverses, donc la lecture du manuel d'utilisation sera profitable à tout anglophone qui souhaite les découvrir.

22 mai 2006

Eurovision et géopolitique

Vous aussi vous êtes persuadé que le système de vote à l'Eurovision favorise les pays d'Europe de l'Est ou les pays nordiques qui ne font rien qu'à mettre en place des magouilles pour tous voter pareil et faire gagner le prestigieux concours à un de leurs copains ?

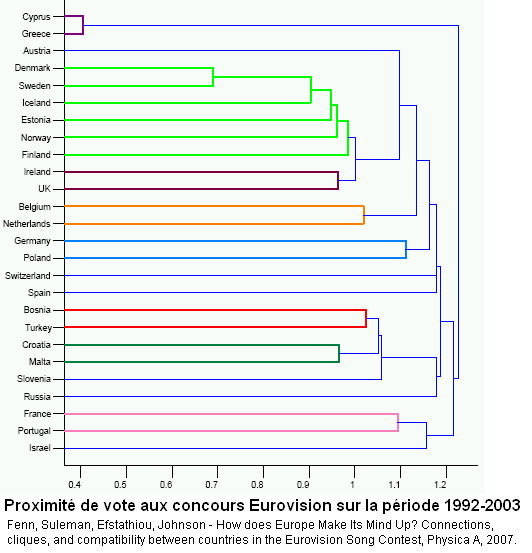
Et bien il est vrai que la proximité géographique transparaît un peu dans les votes attribués par les pays, comme on le voit dans l'arbre phylogénétique ci-dessous qui rapproche dans un même sous-arbre des pays qui ont voté de façon similaire.


Tous les détails sur cet arbre sur cette page de construction de l'arbre phylogénétique selon la "distance Eurovision 2006".