Affichage des articles dont le libellé est SplitsTree. Afficher tous les articles

4 septembre 2009

Bilan du questionnaire fait-ou-pas

Un questionnaire circule depuis plus de deux ans sur la blogosphère française, il consiste à mettre en gras ce qu'on a fait dans sa vie, parmi une liste d'une centaine de propositions. Après l'analyse du mème de la F-list, voilà donc celle du mème "fait-ou-pas".

De nombreuses caractéristiques du mème F-list (dont évidemment celles qui compliquent la récupération et l'analyse des données) se sont retrouvées dans celui-là : origine américaine (j'en trouve une trace dès juin 2004), erreurs de transmission du mème (oubli de questions, modifications d'intitulés), changement des règles du jeu (ajout d'une question à la fin du questionnaire), diffusion communautaire (blogs de gastronomie, puis blogs de loisirs, un passage par les blogs cinéma et les blogs littéraires), transmission virale non arborée (questionnaire repris chez plusieurs sources), formats divers selon la plate-forme de blog. Et ce cas de blogueuse qui répond au questionnaire, puis à une version un peu modifiée l'année suivante...

Malgré ces obstacles, j'ai réussi à identifier une liste globalement conservée de 130 questions chez 163 blogueurs ou de commentateurs de blogs (en recherchant sur Google ou Blogsearch certaines questions du questionnaires). Parmi celles-ci, 127 avaient reçu une réponse de tous ces participants (les questions 50 et 55 ont été omises par certains participants, la 16 a été modifiée...). Ces données sont disponibles ici dans un beau tableau à double entrée de 0 et de 1 (1 si fait, 0 sinon, blogueurs en colonnes, questions en lignes... je vous laisse imaginer le nombre de films que j'ai vu cet été en parallèle de cette ingrate tâche d'acquisition manuelle de données).

Quel est l'intérêt de ces données ? Bah, pour commencer ça a bien une petite valeur de sondage, même si l'échantillon n'est certainement pas représentatif de la blogosphère française. Parmi ceux qui ont répondu en tout cas, 5% ont piloté une Ferrari, 7% ont touché un iceberg, 17% vu des baleines. 42% ont sauté à l'élastique... Euh, comment ça ? La version cour d'école, ou bien l'autre un poil plus vertigineuse ? Eh oui là aussi la polysémie du français vient nous jouer des tours. Certains se permettent aussi d'interpréter les questions de façon assez large pour pouvoir répondre positivement.

Qu'est-ce qui obtient les plus gros pourcentages ? 96% pour "Se sentir vraiment heureux, même un court moment", et "faire une bataille de boules de neige". A l'inverse, personne n'a conduit de gondole à Venise et seuls deux ont visité "tous les" continents : marieestdanssonassiette "par la pensée, la gastronomie, la musique du monde et en lecture" (quand je vous disais que ça triche un peu :)...), et les Fenouillard (dans la version "olympique" à 5 continents). Le reste des pourcentages se trouve dans la troisième colonne de ce tableau.

Et là, vous vous dites que vous aimeriez bien savoir quels blogueurs ont fait les trucs les plus exceptionnels. Comment évaluer ça ? Le nombre d'actions réalisées comme le propose Nostaledonie en commentaire chez les Fenouillard ? Non, certaines sont visiblement plus extraordinaires que d'autres. Une idée est alors de considérer chaque pourcentage comme une probabilité p d'effectuer l'action. Il y a donc aussi probabilité 1-p de ne pas effectuer cette action. Et finalement, la probabilité d'effectuer une certaine liste de ces 130 actions est le produit des probabilités correspondantes pour chaque action. Bon, certes, en faisant une simple multiplication, je considère que ces probabilités sont indépendantes, ce qui est peu raisonnable (répondre oui à "élever des enfants" n'est pas indépendant de répondre oui à "changer la couche d'un bébé" par exemple). On supposera toutefois qu'elles le sont pour simplifier le calcul. Pour simplifier la lisibilité également, on prendra le log du résultat (c'est plus facile de lire "-10" que "0.0000000001", voir la troisième ligne de ce tableau). Voici donc la liste des 5 blogueurs (blogueuses ?) ayant la vie la plus extraordinaire, parmi ceux qui ont répondu :

  1. la famille Fenouillard (loin devant)
  2. Marie est dans son assiette ! (citée plus haut...)
  3. Tout Silo
  4. Poppyrose
  5. Leeloolène

Vous remarquez la présence de la fameuse n°2 du top Wikio, et de la 149. Tiens tiens, et si les blogueurs à la vie la plus exceptionnelle étaient aussi les plus lus et cités ? Eh bien non, après vérification, pas de corrélation. La récupération de données Wikio fournit en revanche d'autres conclusions. Déjà, que leur liste de blogs référencés est loin d'être complète. Elimination des blogs inactifs, refus d'indexation de la part des blogueurs ? Ceci n'explique pas que plus de 55% des blogs recensés dans cette étude ici échappent à Wikio. Leur catégorisation, bien qu'imparfaite (1/4 des blogs catégorisés ici le sont par "divers"), permet de constater que le mème s'est répandu de façon impressionnante sur la communauté gastronomie au printemps 2007. Puis, en novembre 2007 et février 2008, passage dans la communauté loisirs (remarquez qu'au même moment que la croissance de la courbe "loisirs", "divers" et "non catégorisés" augmentent également très fort, voilà un vivier de blogs loisirs à ajouter à Wikio !). Littérature et cinéma en août 2008. En tout cas ces courbes en paliers me semblent décrire très joliment une diffusion virale par communautés successives, et je rêve d'une visualisation interactive de la diffusion sur la wikiopole...

Il reste une dernière visualisation à extraire de ces données, les lecteurs fidèles de ce blog se doutent bien que je n'allais pas garder une belle matrice de 0 et de 1 sous la main sans la transformer en arbre. Eh oui, tentons de rapprocher les questions qui ont obtenu des réponses similaires :
L'ACP donnait un résultat assez moche, alors que là quelques jolis sous-arbres apparaissent (la correspondance entre les étiquettes de l'arbre et les questions précises se trouve dans la 2° colonne de ce tableau). J'ai ajouté des couleurs pour améliorer la lisibilité : quand des feuilles sont proches et ont la même couleur, elles sont dans le même sous-arbre, et constituent donc un cluster de questions auxquelles les gens ont répondu de manière similaire. Quelques clusters pas très étonnants qui permettent de valider cette classification : {se marier, acheter une maison, élever des enfants} {avoir un piercing, un tatouage} {sauter à l'élastique, faire de l'escalade} {danser sans se soucier de qui regarde, danser avec un inconnu} {manger du kangourou, manger du requin} {marcher sur le Golden Gate, visiter Las Vegas} ou encore {porter un agneau, aider un animal à donner naissance, traire une vache}. Pour certains regroupements, on soupçonne une histoire cachée derrière : {faire un art martial, se casser un os, passer à la télé} {avoir un accident, maigrir fortement, dormir 30 heures, jeûner 5 jours}. Mais pour préciser tout ça, et surtout comprendre les étonnants {manger des sushis, faire une balade nocturne sur la plage} ou {vendre ses créations, utiliser une arme à feu}, je cherche à utiliser d'autres techniques de fouilles de données ou classification. Les règles d'association me paraissent prometteuses, notamment, et si j'arrive à en tirer quelque chose vous en aurez des nouvelles sur ce blog.

31 mars 2009

Traduction d'xkcd et loi de Pareto

Le projet de traduction d'xkcd, conçu en un week-end et lancé début décembre, a plutôt bien démarré : 2/3 des planches de Randall Munroe sont maintenant traduites en français ! C'est plus que les versions russe (299/562) et espagnole (150/562)... pour une raison simple : le projet est collaboratif ! (Bon, et on traduit en dessous, et pas sur les images, aussi, hein, il faut reconnaître que c'est plus rapide). Une trentaine de personnes a participé : quelques amis, et une majorité d'internautes que je ne connais pas (vous pouvez vous signaler en commentaire de ce post afin que j'ajoute un petit lien sous votre pseudo dans la liste des traducteurs ;)).

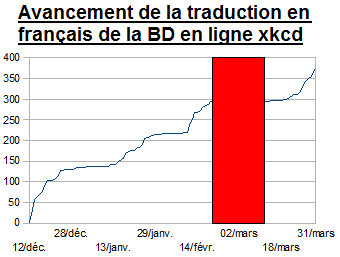
Voici quelques données sur l'avancement du projet, au cas où vous voudriez vous lancer dans une aventure similaire. Tout d'abord, la chronologie de l'avancement du projet. J'ai indiqué par une bande rouge une période d'indisponibilité de l'interface de traduction (du 21 février au 13 mars) qui avait échappé à mon attention, le reste du site étant fonctionnel. La forme de la courbe en escaliers correspond à l'arrivée de participants motivés, qui se lassent au bout d'un moment, ou ont fini de traduire tout ce qui les intéressait (ou pensent que le site est cassé, à partir du 21 février :s).

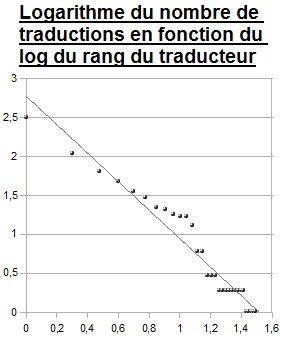
Passons justement à la distribution des contributions. Pour la Wikipedia anglaise, Aaron Swartz nous apprenait en 2006 que 2% des contributeurs font presque 75% des modifications de l'encyclopédie. Pour la traduction d'xkcd, les pourcentages de participation des divers traducteurs se trouvent ici (quand plusieurs collaborateurs ont contribué à la traduction d'une planche, je leur attribue naturellement l'inverse du nombre de contributeurs et je divise finalement ces scores par le nombre total de planches en anglais pour obtenir les pourcentages). Notons que ces pourcentages ne prennent pas en compte la longueur des traductions réalisées (tout comme l'étude d'Aaron Swartz d'ailleurs), ce qui ne rend pas vraiment compte, par exemple, du travail de Kith sur la série à propos du Ministre de l'Internet. Toujours est-il que ces données font apparaître une loi classique : la loi de Pareto ! 20% des utilisateurs (les 6 plus gros collaborateurs) ont réalisé 80% des traductions. Ce soir, le nombre précis est même 79.62%, ce qui semblerait donc moins "élitiste" que la Wikipedia !

En fait, on voit même apparaître une distribution de Pareto (une loi de puissance qui vérifie la règle des 80-20), comme nous le montre la courbe log-log ci-contre.

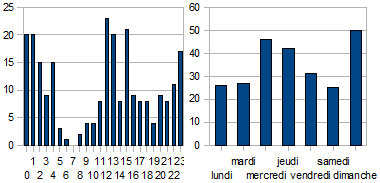
On peut aussi avoir un aperçu des horaires et des jours de la semaine où les traducteurs montrent le plus d'activité (j'ai exclu les valeurs me concernant) : valeurs anormalement élevées le dimanche, à midi, et en pleine nuit, tout ça rappelle les habitudes de surf des étudiants.
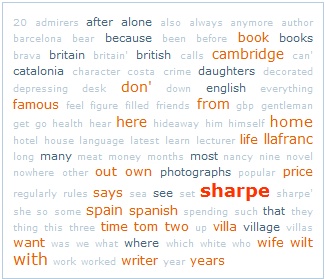
Un petit aperçu de ces traductions, maintenant, avec le nuage arboré des mots apparaissant plus de 10 fois, ci-dessous. Je ne l'ai pas annoncé en grande pompe, j'attends une jolie interface web pour ça, mais ça y est (enfin), un outil pour créer des nuages arborés avec plein de paramètres personnalisés est disponible sur www.treecloud.fr (ou treecloud.org pour les anglophones). Attention, c'est un outil en ligne de commande, qui nécessite un détour par le manuel d'utilisation, en anglais. Mais ça en vaut la peine : le programme permet d'obtenir de jolis résultats, en particulier grâce à la coloration "chronologique" : les mots du nuage arboré ci-dessous apparaissent plutôt rouge s'ils se trouvaient dans les premières planches de xkcd, plutôt bleu s'ils sont beaucoup présents dans les planches récentes. On est en train, avec Jean, de tenter d'ajouter à ça des informations sur la dispersion des mots : plus de nouvelles quand ce sera prêt !
Et si ce nuage arboré vous intrigue, allez jeter un oeil à ces traductions de xkcd, ou abonnez-vous au flux RSS pour recevoir les dernières traductions dès qu'elles sont validées ! A propos, petit aparté sur le spam : les robots n'ont pas tardé à trouver le site et envoyer des traductions bien peu fiables, incitant plutôt à l'achat de petites pilules bleues, mais le flux reste faible (un spam par jour en moyenne) et la procédure de modération manuelle permet d'éviter de les laisser passer.

Pour finir, un grand merci à tous les participants à la traduction ! Internet est de plus en plus collaboratif, alors si vous avez un peu de temps, profitez-en pour vous lancer dans quelques aventures. C'est l'occasion de faire un peu de pub pour les JeuxDeMots, et Pti Clic, qui, dans le genre de Google Image Labeler ou VideoTagName, sont en train de construire petit à petit un magnifique réseau sémantique, à faire pâlir Wordnet. Les données récoltées sont en plus mises à disposition en format brut, ou consultables par des interfaces web, qui peuvent déjà être utilisées pour retrouver, par association d'idées, ces mots qu'on a sur le bout de la langue. Le premier jeu permet d'aider le système à apprendre des relations sémantiques entre mots (synonyme, contenu/contenant, lieu d'une action, etc), et le second (dont on devient vite accro, même en jouant au touchpad...) de renforcer ou préciser ces relations. Le meilleur moyen pour comprendre le principe est de tester en mode invité, et le meilleur moyen pour comprendre l'utilité des données produites est de les utiliser dans des applications diverses... ce qui ne manquera pas d'être fait bientôt sur ce blog !


Comme toujours, les données liées à ce billet sont disponibles : dans ce fichier tableur Open Office. Et le nuage arboré à ouvrir avec SplitsTree pour pouvoir zoomer, etc. Il a été construit par SplitsTree et TreeCloud avec une stoplist française, et les options distance=hyperlex minnb=11 window=100 unit=1 color=chronology.

Episodes précédent et suivant.

6 août 2008

L'agence de presse des spammeurs

"Google accusé d'espionnage par l'Union Européenne",
"La Wii Fit utilisée pour entraîner les troupes américaines",
"Bush évite un soulèvement albanais en envahissant l'Alabama",
"Al Pacino soupçonné de financer la mafia"...
Vous en avez loupé des choses cet été, vous dites-vous en consultant votre boîte mail au retour des vacances !

En fait, ce que vous avez surtout loupé, c'est un mois de juillet marqué par des spammeurs farceurs et originaux dans leur choix de sujet de mail constitué d'un faux-titre d'article de journal. Dommage, ça n'allait pas plus loin que le titre, et ces courriels contenaient généralement seulement une autre phrase du même tabac suivie d'un lien vers un site douteux. Le phénomène s'est apparemment arrêté depuis quelques jours. Je n'ai pas résisté au plaisir de compiler tout ça, puisque la période du 6 juillet au 3 août a été très productive pour le Monsieur Titres à l'origine de ces trouvailles, qui pourrait sans problème envoyer son CV à France Dimanche ou trouver des titres encore plus racoleurs aux articles du Post.

Quelques détails techniques sur la cueillette de ces titres : récupération manuelle sur quatre adresses mails, puis recherche Google de certains d'entre eux, pour tomber sur un splog qui a doublé ma récolte (titres récupérés par mail, sur le splog, listes concaténées en éliminant les doublons). Le fichier obtenu m'a permis de tester ma dernière version (0.5) de TreeCloud (ça y est, elle est utilisable sans devoir installer SplitsTree, on en reparlera, informations et téléchargement ici). Bref, voici un petit nuage arboré qui permet de voir quelques thèmes forts qui doivent éveiller la curiosité de l'anglophone moyen :

Et comme l'arbre ne semble finalement pas si louche (à part peut-être le sous-arbre des sex-tapes d'Obama et MacCain), un petit best-of - que je n'oserai pas traduire - pour voir à quel point les nouvelles annoncées étaient bidon :
Statue of liberty to return to France
Ex-Google engineers debut 'Cuil' way to search
(décidément, cette non-information est partout !)
Angry man shoots lawnmower
Prada gives fake bags to charity
Release Of The Nancy Pelosi Sex Dvd Causes Mass Mass Erectile Dysfunction In US
Tupac Shakur Speaks Out From Beyond The Grave: "Stop Releasing My Stanky Old Songs"
Bush And Mccain Dance Ballet
Jesus Christ To Star In Next Series Of Batman
Madonnas Former Home Destroyed By Jesus
Jesus Christ To Star In Next Series Of Big Brother
The truth about ghosts revealed
Mermaid discovered off NZ coast
Yahoo search shuts down for good
Swedish princess slaps town florist
Danish princess slaps town grocer
Black Panthers Sue White Guys For Stealing Copyrighted Gesture
Bush 'Troubled' by Gay Marriages. Declares San Francisco Part of 'Axis of Evil'
Beijing Olympics cancelled, moved to Atlanta
Living proof that the earth is flat available
Angelina Jolie gives birth to triplets

Et que s'est-il passé le 3 août ? Ces spams ont été remplacés par un nouveau format : de faux mails d'alerte de CNN. Certes, on a une vingtaine de titres pour le prix d'un, mais ça sent le recyclage : pas mal d'entre eux sont déjà présents dans la liste que j'ai compilée. Et surtout il faut cliquer une première fois pour accéder au corps du message, contrairement au titre dans le champ Sujet du mail qui sautait tout de suite aux yeux. Bah, en attendant qu'ils reviennent à la version précédente, je me contenterai du RSS du Monde.

1 janvier 2008

tag cloud + tag tree = nuage arboré (2) Les voeux présidentiels pour 2008

De quoi nous a parlé notre Président dans ses voeux hier soir ? On avait eu droit l'an dernier aux nuages de mots des voeux des présidentiables pour nous en donner de jolies synthèses ; cette année, évolution technologique oblige, on va faire le nuage arboré de ce discours de 9 minutes. Pour ceux qui n'auraient pas suivi l'épisode précédent, ou le billet initial sur Aixtal, un nuage arboré, c'est le pouvoir de visualisation du nuage de mots, associé à celui de la classification hiérarchique en un arbre binaire non orienté !

La preuve en images pour tous les mots prononcés plus de deux fois :
nous donne :


La bonne nouvelle, c'est que si vous aussi vous souhaitez créer vous-même de tels nuages arborés, c'est possible en utilisant la nouvelle version 0.2 de TreeCloud Builder, associée au logiciel SplitsTree (introduction rapide à SplitsTree ici en français). La meilleure nouvelle, c'est que la prochaine version, actuellement en cours de codage et qui sera publiée en même temps que la troisième partie de ce billet, ne nécessitera plus d'utiliser SplitsTree.

La mauvaise nouvelle, c'est que dans la forme actuelle du logiciel (non documenté, fourni "tel quel" avec ses sources), l'arbre construit, même s'il reflète en un sens une certaine proximité entre les mots rapprochés dans ses sous-arbres, reste à prendre avec précaution. En effet l'enchaînement des algorithmes actuels ne me convainc pas. Je rentre dans les détails techniques, vous pouvez donc sauter la fin de ce paragraphe si ça ne vous passionne pas. Il y a actuellement plusieurs gros points faibles dans la construction de l'arbre. Tout d'abord le choix de la distance entre mots. TreeCloud Builder implémente la distance proposée dans le billet précédent, ainsi qu'une formule dérivée d'une formule de cooccurence classique : d1(a,b) = 1 - max(p(a|b),p(b|a)), où p(a|b) est la probabilité qu'une fenêtre de 20 mots autour du mot b contienne le mot a. Le problème avec cette distance d1 est qu'elle n'a rien d'arboré : tout arbre construit par des méthodes classiques en phylogénie ressemble très fortement à une étoile avec de longues branches menant aux feuilles, et des branches internes très courtes. Pour éviter ce problème je l'ai bricolée afin d'augmenter artificiellement la taille des branches internes du résultat obtenu (pour l'instant je ne comprends pas tout à fait comment ça marche, théoriquement, mais en pratique, ça marche) : d2(a,b) = log(101)-log(1+max(100p(a|b),100p(b|a))). Comme la matrice de distances obtenue contient beaucoup de log(101), les distances entre feuilles éloignées sont peu significatives, j'applique donc plutôt la méthode UPGMA (et voilà pourquoi ce billet n'est pas tagué phylogénie mais plutôt clustering) qui agglomère successivement dans l'arbre les mots les plus proches selon cette distance d2.

Revenons tout de même au nuage arboré créé. Même s'il est à prendre avec des pincettes, des phénomènes intéressants y apparaissent. Tout d'abord, l'urgence, vous n'avez pas pu louper l'anaphore alla Guaino. La figure de style apparaît dans l'arbre, puisqu'anaphore est accompagné dans "son sous-arbre" par des mots peu fréquents. Pas vraiment de grand concept-clé accolé à l'urgence, donc, mais une série de mesures. En revanche, le rôle de la France dans le monde, ça occupe un bon sous-arbre, et la représentation arborée permet notamment de désambiguïser le sens du mot vieux : Sarkozy ne parlait pas de nos chers aînés, mais bien de notre vieux pays. Remarquez aussi le sous-arbre des participes passés (voulu, pris, faite), organisés autour de l'ouverture, signes d'une promesse tenue. Même s'il est rigolo, le rapprochement de souci et coeur est artificiel, dû à la faible fréquence des deux mots, dommage pour les psychanalystes en arbre. Autres sous-arbres intéressants, celui des considérations présidentielles sur les valeurs de la vie (famille et travail), et celui plus grave sur la société et son avenir, pour lequel nous devons faire confiance à l'action du gouvernement...

Rendez-vous j'espère avant fin février pour une version aboutie et robuste théoriquement d'un TreeCloud Builder qui vous ferait vite et bien vos nuages arborés. En attendant, ce blog accueillera sous peu un nouvel utilitaire libre, qui permettra de récupérer d'une image les valeurs d'une courbe qu'elle contient. Fans des comparaisons Google Trends, Technorati Chart, Sous-marin Jaune, faites chauffer vos tableurs, c'est pour très bientôt !

Le programme TreeCloud.

12 décembre 2007

tag cloud + tag tree = nuage arboré (1)

Vous avez déjà travaillé avec deux objets, pour vous rendre compte que combinés ils fonctionnaient vachement mieux ? C'est la vraie révélation du dernier article de Jean Véronis sur Aixtal !
Après lecture de son blog ou du mien, vous êtes convaincus qu'un nuage de mots dont la taille (et la couleur, j'apprécie beaucoup les teintes rouges, oranges, et bleues du Nébuloscope, introduites en partie chez TagCloud) reflète la fréquence, c'est très utile pour donner un aperçu rapide d'un texte ou d'un corpus. Vous êtes tout autant convaincus qu'un arbre phylogénétique peut donner un aperçu rapide de relations entre des mots-clés. Et quand on mixe les deux ? Je cite : "c'est marrant les arbres... ils peuvent nous raconter des histoires". Et voilà, un nouvel outil de visualisation d'histoires !

Dans l'exemple dédié à Laurence Ferrari, ce sont les résultats Wikio qui sont "passsés à la moulinette". Mais de la même façon qu'on peut effectuer un nuage de mots depuis un simple texte (avec TagCloudBuilder et une échelle de coloriage logarithmique bien sûr !), j'ai l'impression qu'un nuage arboré (tree-cloud pour nos amis anglophones) est encore un meilleur moyen d'avoir un aperçu rapide d'un texte. L'ordre alphabétique complètement artificiel des tags dans le nuage est remplacé par une disposition hiérarchique intuitive et informatrice !

Alors maintenant, quelle distance entre mots choisir pour reconstituer l'arbre, sur un simple texte ? J'ai fait l'essai suivant : pour chaque paire de mots, leur distance mutuelle est égale au log du nombre de mots minimal qui les sépare. J'avais déjà tenté de commencer à justifier théoriquement l'introduction du log pour certaines reconstructions "phylogénétiques" (la seconde partie du billet est toujours dans les cartons), là je l'introduis a priori seulement pour éviter quelques trop longues branches. J'ai prévu de tester quelques améliorations de cette idée : nombre de mots moyen séparant la paire de mots, éventuellement seulement sur les occurences les plus rapprochées de la paire...

Je garde ces préoccupations pour un éventuel billet suivant, et je livre un exemple d'application de ce principe, tiré du premier texte de longueur convenable que j'avais sous la main, une interview en anglais de Tom Sharpe. L'heure tardive ne me permet pas de mixer arbre et nuage de mots, les voici donc, à mixer mentalement (pour le moment) :
Pour la construction de l'arbre, j'ai gardé seulement les mots présents plus de 3 fois, et contrairement au nuage de mots, n'ai pas enlevé les mots très présents peu porteurs de sens (I, the, to, l'antidico quoi...), qui ne gènent pourtant pas vraiment dans l'arbre (is, of, in, the, he arrivent au niveau du centre).

Le choix de la distance conduit à certains rapprochement un peu artificiels, toutefois la plupart des sous-arbres ont un sens. Soit constitués justement de mots de l'antidico, donc à négliger, soit reflétant les principaux thèmes de l'article. En particulier le sujet général apparaît dans le sous-arbre {village,where,Tom,Sharpe}. Afficher le contexte au passage de la souris sur une feuille ou un sous-arbre serait donc particulièrement intéressant.

Du travail en perspective, donc. A suivre sur ce blog... et sur treecloud.org !

Les fichiers sources des images ci-dessus : fichier Nexus de l'arbre phylogénétique, mots et occurences, mots et occurences avec anti-dico manuel, nuage de mots de TagCloudBuilder, programme de construction de la matrice de distance format Nexus et source Delphi peu commenté pour l'instant.

25 janvier 2007

Blanc bleuté plus qu'orangé

Le député apparenté UDF Christian Blanc a annoncé hier qu'il soutient Nicolas Sarkozy pour la présidentielle. Pas vraiment une surprise. Au cours de ma construction de l'arbre phylogénétique des députés, j'avais été étonné de le voir apparaître carrément à l'intérieur du groupe UMP. Puis, au fur et à mesure que j'intégrais des votes plus anciens, il migrait vers la frontière entre l'UDF et l'UMP, où il avait finalement abouti dans le bilan des 43 derniers scrutins publics. J'ai donc refait proprement l'arbre obtenu par la proximité de vote aux 15 derniers scrutins publics (avec de nouveau l'UMP en bleu, l'UDF en orange, le PS en rose, l'extrême gauche en rouge, et les apparentés en couleurs plus pâles), la feuille correspondant à Christian Blanc a été entourée en gris, et la scission de Nicolas Dupont-Aignan apparaît tout aussi prévisible :

4 janvier 2007

Arbre phylogénétique des députés

Bonne année 2007 ! 2007, qui sera l'année des élections présidentielles, même le Nébuloscope est au courant. Mais c'est aussi l'année des élections législatives, et donc l'occasion de revenir un peu sur les députés et leurs votes à l'Assemblée Nationale.

Je l'avais promis en juin, le voilà enfin après plusieurs jours d'efforts pour colorier ses feuilles : l'arbre phylogénétique des députés qui rapproche ceux qui votent de façon similaire.


Construit à partir des votes des députés qui se sont exprimés aux 43 derniers scrutins publics, soit depuis octobre 2004, l'arbre offre une jolie synthèse de ces votes.

On remarque tout d'abord que cet arbre a une forme assez linéaire, séparant parfaitement les groupes socialistes (en rose) et UMP (en bleu), avec l'UDF (en orange) qui s'égrène entre les deux. On peut aussi noter la présence de gros noeuds regroupant des députés qui votent de manière identique (vous trouverez la légende de ces noeuds ici). Sur plus de 500 députés, on n'obtient finalement que 69 feuilles dans l'arbre : assez déprimant, cette logique de vote très partisane, non ? Heureusement certains députés réputés pour ne pas suivre les mouvements généraux du parti apportent un peu de fantaisie en créant de nouvelles branches, comme Dupont-Aignan et Boutin à l'UMP. Les députés "apparentés" à certains partis se retrouvent aussi intégrés à la bonne place. Et les députés non inscrits (et donc sans couleur spécifique dans l'arbre) n'auraient pas trop de mal à trouver chez qui adhérer, à part peut-être Philippe Edmond-Mariette et Alfred Marie-Jeanne qui ont visiblement trouvé la position d'équilibre gauche-droite.

L'arbre a été construit à partir de SplitsTree et d'un programme maison pour le pré et post-traitement, comme détaillé (avec les données sources si vous voulez vous amuser) ici. L'idée de construire des arbres phylogénétiques d'hommes politiques n'est pas nouvelle, vous pourrez en trouver ici et là. Et pour les phylogénies construites à partir de distances de vote, j'ai vu ça pour la première fois par David Bryant avec les votes de pays à l'ONU.

28 juin 2006

Teaser...

Pour fêter la sortie (le 12 juin) du logiciel de construction d'arbres et réseaux phylogénétiques SplitsTree 4.5 (avec, en écran d'accueil du logiciel, une jolie photo, de la Nouvelle Zélande, j'imagine), bientôt, sur ce blog, un nouvel arbre phylogénétique intéressant...

Ou pas... Vous voyez ce que ça peut être ?
24 mai 2006

Arbres phylogénétiques, le making-of...


Un petit tuto rapide pour construire l'arbre phylogénétique, en supposant que vous avez réussi à obtenir d'une manière ou d'une autre la matrice des distances entre les différentes feuilles de cet arbre.

La première phase, et la plus compliquée, c'est de mettre cette matrice au format NEXUS, dont voici un exemple (tronqué, c'est juste pour comprendre) pour les distances-Eurovision entre les feuilles constituées par les pays européens :

#nexus
BEGIN Taxa;
DIMENSIONS ntax=39;
TAXLABELS
[1] 'Europe'

[2] 'Albania'
...

[39] 'Armenia'
;
END; [Taxa]
BEGIN Distances;
DIMENSIONS ntax=39;
FORMAT labels=left diagonal triangle=both;
MATRIX
[1] 'Europe' 0 8.03446523273329 6.94527480392245 6.08492529025624 6.42978267610967 7.61404519345663 5.99341744182733 6.90728067447675 6.92250335008947 6.7219201517126 6.68265626349283 7.07664803208412 6.71800408960876 6.32663542414134 6.01095491165921 7.08036573532752 7.29275054598743 6.54337752800494 6.95284871559852 6.66293755351196 7.30356798161008 8.31770464286873 7.08408148781478 6.89202437604511 6.01970448643453 6.74926896633998 7.00939219533334 6.99435862906671 6.86907639526596 6.67477576986673 6.60342813696038 6.59146178203287 7.63130671012508 6.75316689827817 6.55944477757074 7.28191704086225 6.89202437604511 6.43796306466572 7.17635004706431
...

[39] 'Armenia' 7.17635004706431 7.68114574786861 8.24621125123532 6.48074069840786 8.36660026534076 8.24621125123532 7.21110255092798 7.74596669241483 8.60232526704263 7.74596669241483 7.74596669241483 6.92820323027551 8.48528137423857 8 8.36660026534076 8.24621125123532 8.94427190999916 7.61577310586391 7.61577310586391 6.78232998312527 7.74596669241483 8.94427190999916 9.16515138991168 8.60232526704263 7.34846922834953 7.21110255092798 7.34846922834953 8.48528137423857 7.48331477354788 7.74596669241483 8.60232526704263 8.12403840463596 8.71779788708135 7.34846922834953 7.87400787401181 8.83176086632785 6.92820323027551 7.34846922834953 0
;
END; [Distances]


Alors certes, si vous l'avez dans un fichier Excel par exemple, vous pourrez vous arranger pour l'exporter en .CSV, puis jouer avec RECHERCHER/REMPLACER pour obtenir des espaces entre les différentes valeurs dans votre matrice... Mais il vaut mieux programmer un outil qui le fasse tout seul. Pour l'instant, je n'ai fait que des utilitaires très spécialisés au code affreusement crade, donc non distribuables en téléchargement direct sur internet...

Une fois ce pénible travail réalisé, passons au miracle Splitstree (4) dont vous aurez téléchargé auparavant la version adaptée à votre système d'exploitation (eh oui, c'est fait en Java, donc multiplateforme...) qui va trivialiser la fin de la construction.

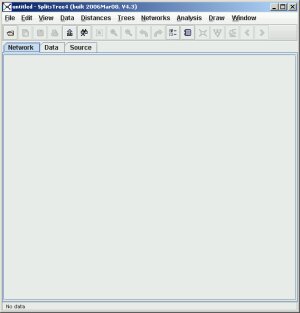
Vous exécutez donc le programme, voilà à quoi ça ressemble :

Cliquez sur le 3° onglet, Source. Copiez-collez le code NEXUS dans cette fenêtre (ou utilisez le menu File, Open...), puis cliquez sur l'onglet Network. On vous avertit que l'entrée a changé et on vous suggère de prendre en compte les modifications (Input has change, execute it?), ce que vous acceptez sans frémir par un Yes assuré. Et là un truc affreux apparaît, un réseau phylogénétique. Affreux parce que pas compréhensible par un oeil non exercé (en fait, le truc permet de visualiser plus d'informations qu'un arbre phylogénétique, mais bon, ne nous étendons pas là-dessus, et tentons plutôt d'obtenir un arbre classique...). Dans le menu Trees, choisissez donc BioNJ si vous êtes chauvin, NJ si vous voulez rédiger l'article Wikipedia qui explique la méthode, et UPGMA si vous vous moquez d'obtenir un mauvais arbre mais que vous tenez à savoir comment il a été construit. Disons que vous prenez BioNJ, cliquez sur le bouton Apply dans la fenêtre qui apparaît.
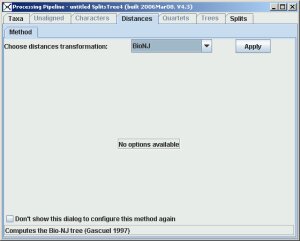
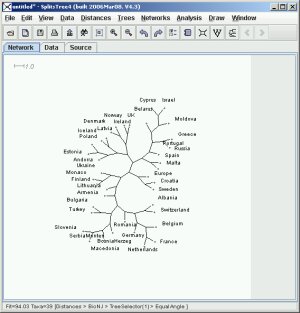
Vous pouvez alors fermer cette fenêtre pour avoir un aperçu du résultat. Vous pouvez tenter d'améliorer la lisibilité de l'arbre en choisissant le menu Draw, Equal Angle. Dans la fenêtre qui apparaît, vous pouvez augmenter le nombre de DaylightIterations, initialement à 0 (genre de 1 à 10). Cet algorithme d'optimisation du dessin de l'arbre tentera de bouger les branches de l'arbre afin de répartir le vide entre les branches de façon équitable. Concluez encore par Apply et en quittant la fenêtre. Si le dessin ne vous semble pas assez expressif, ce qui est le cas quand par exemple toutes les distances de la matrice sont très grandes (c'était le problème de Jean Véronis ici), vous pouvez choisir d'afficher des longueurs identiques pour toutes les arêtes de l'arbre (les portions de branches comprises entre deux noeuds). Pour cela, ça se passe aussi dans la fenêtre de Draw, EqualAngle, il suffit de décocher la case UseWeights.

Vous obtenez alors (après Apply et fermeture de la fenêtre) le joli arbre suivant :

Et voilà, il ne "reste" plus qu'à interpréter le résultat, et en faire profiter les internautes (en citant www.splitstree.org) ou la communauté scientifique (en citant D. H. Huson and D. Bryant, Application of Phylogenetic Networks in Evolutionary Studies, Mol. Biol. Evol., 23(2):254-267, 2006).

D'autre part, Splitstree recèle d'astuces diverses, donc la lecture du manuel d'utilisation sera profitable à tout anglophone qui souhaite les découvrir.

22 mai 2006

Eurovision et géopolitique

Vous aussi vous êtes persuadé que le système de vote à l'Eurovision favorise les pays d'Europe de l'Est ou les pays nordiques qui ne font rien qu'à mettre en place des magouilles pour tous voter pareil et faire gagner le prestigieux concours à un de leurs copains ?

Et bien il est vrai que la proximité géographique transparaît un peu dans les votes attribués par les pays, comme on le voit dans l'arbre phylogénétique ci-dessous qui rapproche dans un même sous-arbre des pays qui ont voté de façon similaire.


Tous les détails sur cet arbre sur cette page de construction de l'arbre phylogénétique selon la "distance Eurovision 2006".