Affichage des articles dont le libellé est corrélation. Afficher tous les articles

30 juin 2010

Densité des idées

La rencontre de doctorants Osidmesh (évoquée précédemment sur ce blog) a débouché sur un joli projet qui a déjà donné ses premiers résultats, que mes coautrices vont présenter cette semaine et le mois prochain. Petit coup de projecteur, donc, sur ces travaux liés à la thèse d'Hyeran sur le langage des malades d'Alzheimer.

En octobre dernier, elle m'avait parlé du logiciel CPIDR qui permet d'estimer, pour un texte en anglais, sa "densité des idées". Le concept de ce score linguistique, qui correspond au nombre d'idées exprimées en 10 mots, nous vient de la psycholinguistique. La densité des idées représente une certaine qualité informative des phrases d'un texte, et les psycholinguistes soupçonnent que sa dégradation est liée à un déclin de l'activité cognitive. Ainsi, Hyeran cherchait à vérifier que les malades d'Alzheimer avaient généralement une densité des idées inférieure aux personnes non atteintes, première étape avant d'utiliser ce critère pour des applications plus poussées comme le diagnostic de la maladie, ou l'analyse précise des dégradations de la capacité langagière en vue de proposer des exercices de rééducation adaptés.

Nous avons donc réutilisé la méthode du logiciel CPIDR pour le calcul de la densité des idées d'un texte : on détermine la nature grammaticale de tous les mots (par exemple de façon automatique avec TreeTagger), et on utilise cette information comme base pour déterminer si le mot peut être considéré comme représentant une idée ou non. En fait, les mots comptant pour une idée sont principalement les verbes, les adverbes et adjectifs, ainsi que les prépositions et conjonctions. Des règles linguistiques permettent d'ajuster ce principe de base et de traiter certains cas particuliers, éventuellement spécifiques au discours oral.

Nous avons donc codé dans un logiciel libre en Python, Densidées, ce principe de base et quelques premières règles grammaticales, qui nous ont permis d'obtenir assez rapidement une approximation intéressante des valeurs de densité des idées trouvées manuellement. Et par un prompt renfort de deux étudiantes lyonnaises en orthophonie, Constance et Elsa, un joli corpus étiqueté manuellement (le rêve de tout TALeux !) a été constitué, permettant d'améliorer le logiciel en comparant les résultats de l'analyse automatique et manuelle, pour trouver les nouvelles règles à ajouter pour réduire le taux d'erreur. Nous arrivons finalement à de très bons résultats, comme détaillé dans cet article à RECITAL 2010 et montré dans le graphique de corrélation entre analyse manuelle et automatique ci-contre.

Deuxième étape, vérifier que la densité des idées, en particulier celle calculée par Densidées, est effectivement plus faible chez les malades d'Alzheimer. Les résultats du mémoire d'Elsa et Constance pour un groupe de 22 personnes (dont 11 malades), sont confirmés dans notre poster à CEDIL 2010 pour un groupe de 40 personnes.

Hyeran va poursuivre la constitution de son corpus, et elle a d'autres pistes de critères linguistiques pouvant jouer le rôle d'indices de la maladie d'Alzheimer, mais la partie de son travail à laquelle j'ai eu la chance de participer a précisé de manière très concrète l'image que j'esquissais dans le billet précédent de recherches en sciences humaines d'une grande qualité malgré la faiblesse, ou l'absence, des financements. La motivation et le travail d'une doctorante, en lien avec une équipe d'étudiantes énergiques et passionnées, et un bon encadrement de thèse, sont visiblement des clés pour compenser la faiblesse des moyens pour la recherche en sciences humaines. Mais jusqu'à quand si les financements n'arrivent pas à la suite des bons résultats obtenus ? Le minimum vital est de pouvoir les présenter, afin de recueillir l'avis et les suggestions de la communauté scientifique. Pour l'article de RECITAL (à Montréal cette année avec TALN), nous remercions le laboratoire Praxiling et l'école doctorale 58, ainsi que l'ATALA et l'école doctorale I2S pour leur soutien financier.

A très vite pour évoquer un autre logiciel libre et une autre collaboration à l'interface avec les sciences humaines...

24 février 2010

Miss Google 2010

Avez-vous déjà invité une brésilienne à votre soirée d'anniversaire ? Paola me raconte que ça suffit à obséder certains jeunes hommes que j'imagine charmés par les sonorités de l'accent brésilien ou de la langue portugaise. A moins que la brésilienne ait un statut particulier dans l'imaginaire collectif français...

C'est l'hypothèse que j'ai testée en allant récupérer le nombre de réponses Google de "belle brésilienne", "jolie brésilienne", et en faisant de même pour un total de 152 nationalités. Je suis fan de ce genre de tests, tout comme xkcd. Et mon petit FuryPopularity fonctionne toujours aussi bien pour effectuer des requêtes Google en masse (contrairement aux requêtes Yahoo, qui a encore changé d'apparence récemment)... en imposant un délai d'une vingtaine de secondes entre deux requêtes, pour éviter d'être détecté comme robot (il y a quelques mois 8 secondes suffisaient, argh).

Les résultats sont dans ce document tableur partagé.

Top 10 des belles : françaises, japonaises, marocaines, brésiliennes, chinoises, roumaines, mexicaines, allemandes, italiennes, américaines.
Top 10 des jolies : françaises, thaïlandaises, russes, indiennes, anglaises, italiennes, américaines, brésiliennes, espagnoles, allemandes.

Première remarque en se penchant un peu plus sur les résultats chiffrés : en les passant au logarithme on obtient une droite, excepté une irrégularité pour les nombres de résultats compris entre 10 et 40. Je ne serais pas étonné que ce soit le palier au delà duquel Google ne fournit pas les nombres exacts de résultats, mais seulement des approximations. En revanche je suis un peu étonné de ne pas tomber sur une loi de puissance comme ça a si souvent été le cas sur ce blog.

Deuxième remarque, il y a une forte corrélation entre les résultats pour "belle" et ceux pour "jolie" (coefficient de corrélation 0.88), qui tendrait à indiquer qu'effectivement ces résultats correspondent à une tendance commune, et qu'on pourrait donc les interpréter comme un inconscient collectif (ou médiatique ?) d'association de la beauté féminine avec certaines nationalités.

Mais j'entends déjà poindre les premières critiques : belles françaises, italiennes, allemandes et américaines... Google Images nous confirme qu'on ne parle pas là que des habitantes de ces pays, mais aussi de leurs voitures. Les allemands ont semble-t-il un peu moins tendance à personnifier leurs voitures (encore que, les motos peut-être un peu), j'ai donc également lancé l'expérience également avec "schöne" et "hübsche", avec les gentilés allemands trouvés ici.

Les résultats sont différents, mais tout de même un peu corrélés aux français (0.72 et 0.75). Voilà le top 10 pour "schön" : sud-africaines, russes, allemandes, italiennes, suédoises, danoises, françaises, indiennes, polonaises, autrichiennes ; et pour "hübsch" : japonaises, brésiliennes, allemandes, polonaises, françaises, chinoises, suédoises, italiennes, américaines, norvégiennes. Avec toujours une bonne corrélation entre les deux listes de résultats (0.86).

Vous remarquez le point à droite, très "schön" mais moyennement "hübsch" ? Il s'agit de l'Afrique du Sud, représentée, pour les allemands, par Charlize Théron qui truste les résultats de la requête. Elle me permet de remarquer une fois de plus combien les nombres de résultats Google sont variables du jour au lendemain, car il y a aujourd'hui beaucoup moins de résultats qu'hier soir quand j'ai récupéré les données.

N'hésitez pas à réutiliser le protocole pour obtenir des résultats plus solides (en réitérant les requêtes sur plusieurs jours pour éviter les résultats fantaisistes parfois fournis par Google), ou bien dans d'autres langues, ou sur les hommes plutôt que les femmes. Et peut-être, en testant assez de langues, pourrez-vous trouver le pays où français et française sont les mieux cotés ! Ou bien tout cela vous donnera envie de voyager un peu dans les pays du milieu et du bas du classement pour constater l'absurdité de ces stéréotypes.

31 janvier 2010

Prénom et profession

Ca fait un certain temps que traînent sur mon ordinateur les données des prénoms et professions de plus de 100 000 signataires d'une pétition que j'évoquais dans des billets précédents. Alors que je me suis récemment plongé dans la passionnante Initiation aux méthodes de la statistique linguistique de Charles Muller (sur un conseil avisé) pour un autre projet dont je parlerai bientôt ici, j'en profite pour appliquer ce que je viens d'y apprendre sur les écarts réduits. Les commentaires de vrais statisticiens sont les bienvenus...


J'ai donc à disposition un tableau de 294 prénoms qui apparaissent plus de 40 fois chacun parmi les signataires, et pour chacun la répartition en 15 professions (étudiant, informaticien, ingénieur, employé, chercheur, auteur, cadre, enseignant, lycéen, retraité, profession, libérale, chômeur, fonctionnaire, bibliothécaire, journaliste). J'aimerais alors pour chaque profession savoir quels prénoms sont sous-représentés et sur-représentés. Une première approche consisterait à calculer simplement le pourcentage de représentation de chaque prénom. Par exemple, sur 1304 Philippe, il y a 33 étudiants (soit 2,5%), alors que sur 103312 signataires, il y a 14881 étudiants (soit 14,4%). Ainsi, parmi les Philippe, les étudiants seraient sous-représentés ?

Malheureusement, ce raisonnement ne conduit qu'à une intuition et n'est pas encore confirmé statistiquement. Pour évaluer si cette sous-représentation est statistiquement significative, il faut calculer les écarts réduits, et pour cela abandonner les pourcentages pour revenir aux valeurs théoriques et valeurs observées. Comme il y a 14881 étudiants, 1304 Philippe et un total de 103312 personnes, le nombre théorique d'étudiants qui s'appellent Philippe est 14881/103312*1304 = 188 (environ). Le critère pour évaluer si cet écart absolu de -155 (=33-188) est bien significatif s'appelle l'écart réduit, il consiste à diviser l'écart absolu par l'écart-type.

Là, j'ai cru comprendre qu'on prend l'hypothèse d'une loi normale pour calculer l'écart-type théorique comme la racine du nombre d'individus considérés (de Philippe, soit 1304) multiplié par la probabilité qu'ils soient étudiants (soit p=14881/103312=0,144) multiplié par la probabilité qu'ils ne le soient pas (1-0,144=0,856). Pour l'instant tout ça m'a l'air un peu magique, mais ça semble avoir un rapport avec le théorème de Moivre-Laplace (qui demande que n soit suffisamment grand, d'où ma restriction initiale à des prénoms représentés plus de 40 fois, j'espère que c'est suffisant).

Enfin bref, on trouve donc un écart réduit de -12,21 ce qui est statistiquement significatif, car la probabilité qu'un tirage au hasard (d'étudiants tirés à probabilité 0,144 avec 1304 tirages) conduise à un tel écart type est tellement faible qu'elle n'est même pas dans la table de référence des écarts réduits du bouquin de Muller page 175 (qui s'arrête à un écart réduit de 4,5 qui est atteint ou dépassé avec proba 0,000006. Cette opération peut être répétée pour tous les prénoms et conduit à ce fichier tableur OpenOffice (les écarts réduits sont sur la feuille 2, si vous avez la chance de trouver votre prénom parmi les 294 sélectionnés...), et en particulier cet histogramme des écarts réduits pour Philippe (on considère que les écarts réduits sont significatifs en dessous de -2 et au-dessus de 2) :
On peut aussi faire un Top 10 des prénoms significativement sur-représentés dans diverses professions, en appliquant des calculs similaires (en feuille 3 du document tableur). Je les dispose ci-dessous sous forme de nuages construits avec TagCloudBuilder (il y a visiblement encore des progrès à faire vis à vis de la parité, regardez les nuages des ingénieurs, chercheurs, cadres, et employés... Notez aussi les excès de Jean-Quelquechose chez les ingénieurs et les cadres.).
Etudiants :
Informaticiens :
Ingénieurs :
Employés :
Chercheurs :
Cadres :
Enseignants:
Lycéens :
Retraités :
Professions libérales :
Chômeurs :
Fonctionnaires :
Bibliothécaires :
Journalistes :
A vous de les utiliser pour nommer vos enfants (je sens que je vais me reconvertir en consultant en prénoms). Toutefois, pas de chance, vous noterez qu'aucun prénom n'est significativement sous-représenté dans le groupe des chômeurs...

Edit du 2 février : pour amoindrir l'effet de l'âge, Vincent me propose de refaire les calculs en enlevant des données les étudiants, lycées et retraités. Résultats ce soir ou demain soir... Mise à jour du 4 février : en fait ça méritera un billet séparé un peu plus long, car ces nouveaux résultats m'inspirent de nouvelles hypothèses et tests, pour les impatients les nouveaux nuages se trouvent ici et les données là...

Des lectures sur le même thème :

4 septembre 2009

Bilan du questionnaire fait-ou-pas

Un questionnaire circule depuis plus de deux ans sur la blogosphère française, il consiste à mettre en gras ce qu'on a fait dans sa vie, parmi une liste d'une centaine de propositions. Après l'analyse du mème de la F-list, voilà donc celle du mème "fait-ou-pas".

De nombreuses caractéristiques du mème F-list (dont évidemment celles qui compliquent la récupération et l'analyse des données) se sont retrouvées dans celui-là : origine américaine (j'en trouve une trace dès juin 2004), erreurs de transmission du mème (oubli de questions, modifications d'intitulés), changement des règles du jeu (ajout d'une question à la fin du questionnaire), diffusion communautaire (blogs de gastronomie, puis blogs de loisirs, un passage par les blogs cinéma et les blogs littéraires), transmission virale non arborée (questionnaire repris chez plusieurs sources), formats divers selon la plate-forme de blog. Et ce cas de blogueuse qui répond au questionnaire, puis à une version un peu modifiée l'année suivante...

Malgré ces obstacles, j'ai réussi à identifier une liste globalement conservée de 130 questions chez 163 blogueurs ou de commentateurs de blogs (en recherchant sur Google ou Blogsearch certaines questions du questionnaires). Parmi celles-ci, 127 avaient reçu une réponse de tous ces participants (les questions 50 et 55 ont été omises par certains participants, la 16 a été modifiée...). Ces données sont disponibles ici dans un beau tableau à double entrée de 0 et de 1 (1 si fait, 0 sinon, blogueurs en colonnes, questions en lignes... je vous laisse imaginer le nombre de films que j'ai vu cet été en parallèle de cette ingrate tâche d'acquisition manuelle de données).

Quel est l'intérêt de ces données ? Bah, pour commencer ça a bien une petite valeur de sondage, même si l'échantillon n'est certainement pas représentatif de la blogosphère française. Parmi ceux qui ont répondu en tout cas, 5% ont piloté une Ferrari, 7% ont touché un iceberg, 17% vu des baleines. 42% ont sauté à l'élastique... Euh, comment ça ? La version cour d'école, ou bien l'autre un poil plus vertigineuse ? Eh oui là aussi la polysémie du français vient nous jouer des tours. Certains se permettent aussi d'interpréter les questions de façon assez large pour pouvoir répondre positivement.

Qu'est-ce qui obtient les plus gros pourcentages ? 96% pour "Se sentir vraiment heureux, même un court moment", et "faire une bataille de boules de neige". A l'inverse, personne n'a conduit de gondole à Venise et seuls deux ont visité "tous les" continents : marieestdanssonassiette "par la pensée, la gastronomie, la musique du monde et en lecture" (quand je vous disais que ça triche un peu :)...), et les Fenouillard (dans la version "olympique" à 5 continents). Le reste des pourcentages se trouve dans la troisième colonne de ce tableau.

Et là, vous vous dites que vous aimeriez bien savoir quels blogueurs ont fait les trucs les plus exceptionnels. Comment évaluer ça ? Le nombre d'actions réalisées comme le propose Nostaledonie en commentaire chez les Fenouillard ? Non, certaines sont visiblement plus extraordinaires que d'autres. Une idée est alors de considérer chaque pourcentage comme une probabilité p d'effectuer l'action. Il y a donc aussi probabilité 1-p de ne pas effectuer cette action. Et finalement, la probabilité d'effectuer une certaine liste de ces 130 actions est le produit des probabilités correspondantes pour chaque action. Bon, certes, en faisant une simple multiplication, je considère que ces probabilités sont indépendantes, ce qui est peu raisonnable (répondre oui à "élever des enfants" n'est pas indépendant de répondre oui à "changer la couche d'un bébé" par exemple). On supposera toutefois qu'elles le sont pour simplifier le calcul. Pour simplifier la lisibilité également, on prendra le log du résultat (c'est plus facile de lire "-10" que "0.0000000001", voir la troisième ligne de ce tableau). Voici donc la liste des 5 blogueurs (blogueuses ?) ayant la vie la plus extraordinaire, parmi ceux qui ont répondu :

  1. la famille Fenouillard (loin devant)
  2. Marie est dans son assiette ! (citée plus haut...)
  3. Tout Silo
  4. Poppyrose
  5. Leeloolène

Vous remarquez la présence de la fameuse n°2 du top Wikio, et de la 149. Tiens tiens, et si les blogueurs à la vie la plus exceptionnelle étaient aussi les plus lus et cités ? Eh bien non, après vérification, pas de corrélation. La récupération de données Wikio fournit en revanche d'autres conclusions. Déjà, que leur liste de blogs référencés est loin d'être complète. Elimination des blogs inactifs, refus d'indexation de la part des blogueurs ? Ceci n'explique pas que plus de 55% des blogs recensés dans cette étude ici échappent à Wikio. Leur catégorisation, bien qu'imparfaite (1/4 des blogs catégorisés ici le sont par "divers"), permet de constater que le mème s'est répandu de façon impressionnante sur la communauté gastronomie au printemps 2007. Puis, en novembre 2007 et février 2008, passage dans la communauté loisirs (remarquez qu'au même moment que la croissance de la courbe "loisirs", "divers" et "non catégorisés" augmentent également très fort, voilà un vivier de blogs loisirs à ajouter à Wikio !). Littérature et cinéma en août 2008. En tout cas ces courbes en paliers me semblent décrire très joliment une diffusion virale par communautés successives, et je rêve d'une visualisation interactive de la diffusion sur la wikiopole...

Il reste une dernière visualisation à extraire de ces données, les lecteurs fidèles de ce blog se doutent bien que je n'allais pas garder une belle matrice de 0 et de 1 sous la main sans la transformer en arbre. Eh oui, tentons de rapprocher les questions qui ont obtenu des réponses similaires :
L'ACP donnait un résultat assez moche, alors que là quelques jolis sous-arbres apparaissent (la correspondance entre les étiquettes de l'arbre et les questions précises se trouve dans la 2° colonne de ce tableau). J'ai ajouté des couleurs pour améliorer la lisibilité : quand des feuilles sont proches et ont la même couleur, elles sont dans le même sous-arbre, et constituent donc un cluster de questions auxquelles les gens ont répondu de manière similaire. Quelques clusters pas très étonnants qui permettent de valider cette classification : {se marier, acheter une maison, élever des enfants} {avoir un piercing, un tatouage} {sauter à l'élastique, faire de l'escalade} {danser sans se soucier de qui regarde, danser avec un inconnu} {manger du kangourou, manger du requin} {marcher sur le Golden Gate, visiter Las Vegas} ou encore {porter un agneau, aider un animal à donner naissance, traire une vache}. Pour certains regroupements, on soupçonne une histoire cachée derrière : {faire un art martial, se casser un os, passer à la télé} {avoir un accident, maigrir fortement, dormir 30 heures, jeûner 5 jours}. Mais pour préciser tout ça, et surtout comprendre les étonnants {manger des sushis, faire une balade nocturne sur la plage} ou {vendre ses créations, utiliser une arme à feu}, je cherche à utiliser d'autres techniques de fouilles de données ou classification. Les règles d'association me paraissent prometteuses, notamment, et si j'arrive à en tirer quelque chose vous en aurez des nouvelles sur ce blog.

17 avril 2009

Cartographie au Figaro

Hier soir, le Figaro a "révélé" le "le palmarès 2008 des violences, sur la base des données officielles de l'Observatoire national de la délinquance (OND)", et choisit de l'illustrer avec la carte des atteintes volontaires à l'intégrité physique en titrant "La nouvelle carte de France de l'insécurité". Buzz assuré, une centaine de commentaires en quelques heures...


Mais que nous apprend la carte ? Comparons-la avec celle des densités par département :

Elles se ressemblent, hein ? On peut le vérifier précisément en faisant un graphique du taux d'atteintes volontaires à l'intégrité physique en fonction du log de la densité :La corrélation est assez claire, on a un coefficient de 0.67 (et 0.81 en omettant la Guyane). Bref, la carte n'est pas très utile, et servirait au mieux à illustrer le principe bien connu par les chimistes que des concentrations élevées favorisent les chocs... L'auteur de l'article aurait pu au moins mentionner cette remarque basique et concentrer son analyse sur les exceptions à cette règle, ou bien choisir une autre carte un peu plus riche en informations, par exemple celle des atteintes aux biens, accessible par un clic sur la carte interactive des atteintes à l'intégrité physique.

Données liées à ce billet : fichier tableur OpenOffice.

Edit de midi : tiens, je lis sur Twitter qu'en plus ils ont confondu Martinique et Guadeloupe sur la carte.

13 décembre 2008

Xkcd en français

xkcd est une mine d'illustrations pour les enseignants en informatique, et j'ai décidé cette année d'illustrer chaque séance des TP de système/réseau que j'assure en L2 avec un dessin traduit pour l'occasion.

Les difficultés sont multiples : choisir le dessin tout d'abord. Car parmi les quelques centaines de l'auteur, Randall Munroe, il faut en trouver qui ont un rapport plus ou moins direct avec la séance du jour, et je remercie Arnaud de m'avoir fait profiter de sa mémoire et de sa connaissance pointue de xkcd pour m'éviter d'être bloqué sur la fin.

Autre problème, la traduction. Ces courtes vignettes faisant appel à un vocabulaire spécialisé sont assez difficiles à traduire en restant aussi concis. Quand il faut en plus gérer des problèmes de culture geek dont l'équivalent français n'existe pas, ça devient mission impossible. Quant au texte alternatif, c'est souvent difficile même d'y comprendre la blague.

Encore un obstacle, la réalisation. Retrouver une police de caractères qui ressemble à l'écriture - en majuscules - de Randall Munroe n'est pas évident. On trouve quelques essais ici ou là. La police International Playboy, qui contient même la plupart des majuscules accentuées, donne un résultat convenable.

Enfin, dernier problème : la publication et les droits d'auteurs. Eh bien ce n'en est pas un, puisque xkcd est publié sous licence Creative Commons autorisant justement les modifications !

Alors, qu'attendent tous les geeks de France pour lancer une vraie interface collaborative de traduction d'xkcd ?

Il y a eu quelques essais, mais la plupart n'ont pas survécu à quelques dizaines de dessins. Le total, recensé ci-dessous, permet tout de même d'arriver à 11% de la BD. Mais attention, la qualité de traduction n'est pas toujours au rendez-vous :
21 45 77 86 86' 123 129 132 148 156 163 169 171 185 191 195 198 202 208 208' 218 221 224 227 231 232 233 242 244 247 275 275' 287 290 302 302' 303 307 323 327 327' 329 341 342 343 344 345 349 350 353 374 377 378 378' 385 385' 386 397 399 400 405 411 411' 414 425 425' 426 427 428 429 432 433 434 435 436 441 444 445 447 448 451 453 456 456' 469 479 488 488' 530

Si l'on veut lancer une traduction massive, l'idée serait de permettre une collaboration. Difficile si l'on travaille directement sur les images. J'ai donc préparé une interface de traduction d'xkcd en français qui fonctionne seulement en ajoutant le texte sous l'image. Ceux qui le voudront pourront ensuite créer les images, en y insérant ces textes. Pour arriver à une bonne qualité, je propose le système suivant :

  • n'importe qui peut envoyer une traduction
  • des modérateurs (moi pour l'instant, mais si je peux vous faire confiance, j'accepterai certainement de vous ajouter à la liste) se chargent de la valider pour qu'elle apparaisse sur le site, et de choisir la meilleure (et donc bye bye les robots spammeurs !).
Le système est réalisé en PHP/MySql, sur une structure très proche de celle utilisée pour le guide de Pessoa sur Lisbonne. L'adaptation à d'autres langues sera donc très facile (contactez-moi si vous êtes intéressé par les sources). Et bien sûr, je compte sur vous pour proposer des traductions ! Il suffit de cliquer sur l'image voulue, puis compléter le formulaire, en utilisant éventuellement le lien vers l'image originale pour l'avoir sous les yeux pendant la traduction. Et surtout n'oubliez pas l'infobulle, qui apparaît quand on laisse traîner la souris sur l'image !


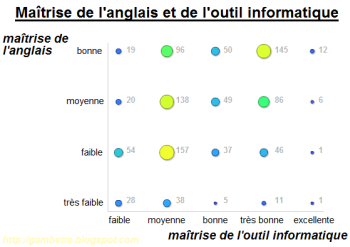
Alors bien sûr, vous allez me dire que la traduction des xkcd est un peu inutile, vu que la connaissance de l'anglais fait partie de la culture geek. Ce n'est pas complètement faux. Un sondage a été organisé cette année pour évaluer la familiarité avec l'outil informatique de tous les entrants en licence de la Faculté des Sciences de l'Université Montpellier 2, dans le cadre d'une UE préparant à l'examen du C2I (Certificat Informatique et Internet). Un millier d'étudiants a répondu, et voici les résultats des deux questions suivantes :

Si, sur internet, vous arrivez sur une page écrite en anglais :
  • vous n'y comprenez rien
  • vous y déchiffrez quelques mots
  • vous pourriez la comprendre en cherchant le sens de quelques expressions
  • vous la lisez en comprenant la plupart des phrases
À propos du contenu de cette unité FLIN102, vous pensez :
  • que vous aurez du mal, qu'il y aura beaucoup (trop ?) de choses à découvrir,
  • que ça ira en suivant les TP, et en les travaillant en plus chez vous,
  • que suivre les TP vous suffira pour apprendre des choses et les retenir,
  • que vous connaissez déjà une bonne partie des choses enseignées en TP, mais que vous en découvrez quelques unes,
  • que suivre les TP est pour vous complètement inutile, vous savez déjà tout ou presque.

Comme vous pouvez le constater, la maîtrise de l'anglais augmente en même temps que la maîtrise de l'outil informatique. Alors peut-être que les fous d'ordinateurs continueront à se précipiter sur la version originale de la BD, et que la traduction leur servira seulement en cas de problème. Peut-être qu'ils profiteront de leur maîtrise de la langue pour faire profiter d'xkcd aux allergiques à l'informatique pour lesquels quelques planches sont tout à fait accessibles.


Episodes suivants : traduction d'xkcd et loi de Pareto (31 mars 2009), sous-titrage xkcd : 100% ! (20 avril 2010)

18 novembre 2008

Claviers espions : usure et fréquence de lettres

Dur dur de poster après une période silencieuse sur son blog... Reprendre un billet vaguement réveillé par un autre d'un blog influent ? Ficeler un rapport peu concluant sur l'influence de la plateforme sur le classement d'un blog ? Non, il faut un nouveau résultat fort, mêlant une idée théoriquement ingénieuse et calculable en pratique, un vrai projet de longue haleine qui montre qu'on n'a pas chômé...

Tout est parti de deux touches de clavier défaillantes. Delphine, déjà à l'origine de quelques posts sur ce blog, notait que les deux touches qui s'étaient détachées de son clavier faisaient partie du mot-clé principal de sa thèse. Il n'en fallait pas plus pour me faire envisager une forte corrélation entre l'usure des touches et leur fréquence d'utilisation (aussi remarquée ici par exemple), et rechercher les moyens de mesurer tout ça... et d'en déduire des choses.


Par chance, mon clavier Dell reflète assez bien son utilisation (ceux de certains Mac aussi apparemment, voire les claviers NMB Technologies), au bout d'un an. Mon "S" est par exemple presque complètement effacé. Mais surtout, si on regarde de plus près, les touches fréquemment utilisées sont vraiment usées, le plastique y est plus lisse, et elles réfléchissent beaucoup mieux la lumière. Je ne sais pas ce que ce polissage implique sur l'absorption de matières toxiques du bout des doigts, mais en tout cas il permet de faire des mesures : en éclairant le clavier par dessus et en prenant la photo de travers, les zones très réfléchissantes apparaissent plus sombres que le reste.

Il faut alors quantifier l'usure à partir de la photo. Si l'on veut des résultats très précis, on peut s'amuser à faire du traitement d'image et mesurer l'intensité sur les portions de photo qui correspondent aux touches. Ca demande un gros travail, surtout de normalisation de l'image... alors qu'on peut procéder plus simplement : construire un quadrillage 5x5, le coller sur chaque touche, et compter les carreaux, parmi ces 25, qui sont sombres. En fait, pour les premières lettres, on compte les carreaux pour préparer quelques étalons, après, on compare avec les lettres dont l'usure a déjà été évaluée.

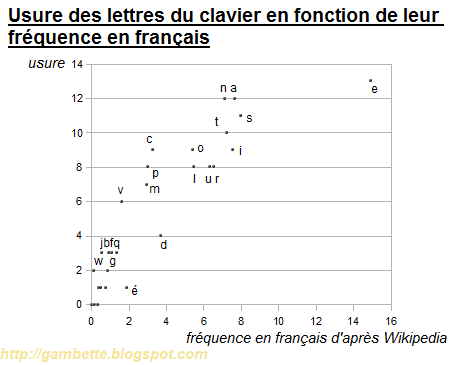
Une fois ces quantités d'usure obtenues, on peut les comparer avec les fréquences de lettres en français. Pour cela, on me l'a confirmé dans mon cours de biostats cette année, rien ne vaut un joli diagramme XY :

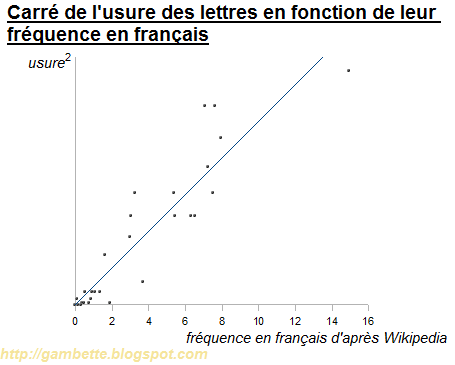
La corrélation est nette (coefficient 0,89), toutefois la relation entre les deux variables semble n'être pas exactement linéaire. Essayons d'élever l'usure au carré, ça semble mieux fonctionner (coefficient de corrélation 0,92), même si ce n'est pas parfait :

Qu'est-ce qui pourrait expliquer ces variations par rapport à la distribution moyenne des lettres en français ? Les gros joueurs de jeux vidéos ont apparemment leurs touches fétiches, je pense que ma forte usure de C et V vient de mon abus de raccourcis pour le copier coller, pour W c'est sûrement les adresses web. De plus, j'utilise mon ordinateur pour écrire à la fois en français et en anglais. Tiens tiens, et si j'utilisais l'usure des touches pour évaluer à quelle fréquence je tape en anglais ou en français ?

L'idée est donc que la distribution de l'usure n'est pas semblable à celle du français, mais à une combinaison linéaire de celle du français et de l'anglais. J'appelle U(l) ma fréquence d'utilisation de la lettre l, F(l) (respectivement A(l)) sa fréquence d'utilisation en français (resp. en anglais), et j'appelle x le ratio de ce que je tape en français par rapport à tout ce que j'écris avec mon ordinateur. U est donc une loi mélange de F et A : U(l) = x F(l) + (1-x) A(l). J'essaie de trouver x en connaissant une approximation de U, de F et de A pour toute lettre. Pour cela, je vais calculer le membre de droite pour toutes les valeurs de x entre 0 et 1, et évaluer la corrélation avec U. Tout peut se faire avec un tableur, ça se passe ici.

J'en profite pour une petite digression sur le coefficient de corrélation de Pearson, implémenté par COEFFICIENT.CORRELATION dans tout tableur digne de ce nom, que j'avais utilisé dans certains posts précédents sans comprendre sa formule magique. En fait, la formule est tout à fait naturelle une fois qu'on a compris que pour normaliser des distributions, classiquement, on divise les valeurs par l'écart type, avant de soustraire la moyenne (merci encore au cours de biostats, décidément ces modules doctoraux ont du bon quand on les choisit soi-même...).

Bref, passons aux résultats. J'utilise trois distributions de fréquences de lettres en français trouvées sur internet pour F, deux pour l'anglais et la distribution A. A chaque fois je calcule la valeur optimale de x. Je termine par une moyenne de ces valeurs de x : 0.81 (avec selon la distribution une variation inférieure à 10%). Bref, environ 1/5 de ce que je tape est en anglais.

A quel point la méthode présentée ici est fiable ? D'une part, il est connu que les fréquences de lettres varient selon le corpus utilisé. D'autre part, le coefficient de corrélation que je tente de maximiser afin de trouver le ratio x est peut-être trop sensible à de petites variations sur les fréquences de lettres. Pour tester ça, j'ai collé un bout de texte anglais à un bout de texte français (en connaissant le ratio x, donc) et j'ai essayé de le retrouver par la méthode de maximisation du coefficient de corrélation. Pour une étude plus sérieuse, j'aurais peut-être essayé un corpus de textes variés, là au vu des résultats je me suis contenté de mon premier essai.

J'ai utilisé cet outil en ligne de calcul de fréquence de lettres, qui fournit des pourcentages de fréquences arrondis à l'entier près (pas très précis, donc, à peu près autant que mes mesures sur le clavier). J'ai copié le premier article du Monde que j'ai eu sous les yeux dans mon flux RSS, concaténé au texte de la page d'accueil de l'outil, en anglais donc (remarquez que ces deux textes sont très courts). Puis appliqué la méthode, avec les deux distributions de fréquences pour l'anglais et les trois pour le français. En faisant la moyenne des coefficients trouvés, j'obtiens 0,79 alors que la valeur réelle était 0,81 (8327 octets pour le texte français, 1904 pour l'anglais), soit à peine 3% d'erreur (et pour chaque couple de distributions de fréquences anglais/français, moins de 10% d'erreur).

Bref, je suis assez confiant pour placer une marge d'erreur de 10%, et affirmer qu'il est possible de deviner par cette technique la langue d'un utilisateur d'ordinateur Dell qui use raisonnablement son clavier. Pas mal sans utiliser de vrai clavier espion !

16 janvier 2008

Britney-Amy : duel mortel

Découverts grâce au Petit Journal de Canal + la semaine dernière, les sites WhenWillAmyWinehouseDie.com et WhenIsBritneyGoingToDie.com proposent un concept intéressant : pronostiquer la date de décès des deux divas, le plus proche gagnera qui un iPod Touch, qui une PS3. Buzz énorme, bien sûr, des milliers d'internautes se sont rués pour participer, laissant un petit messages de pré-condoléances au passage. Les deux sites sont évidemment optimisés pour récupérer des revenus publicitaires (contrairement à l'initiative plus confidentielle mais tout aussi "sympathique" du TopMort), et communiquent seulement les données brutes entrées par les signataires.

Il manquait donc un peu d'analyse de tous ces pronostics. Grâce à la formidable assistance de Matthieu Muffato, expert en domptage de Python, quelques lignes (de code) et quelques heures (d'exécution du programme) après que je lui aie parlé du problème, il m'envoyait son source avec les données récupérées.

La question que je m'étais initialement posé sur les pronostics était simple : quel est l'intervalle de temps le plus grand qui est encore libre, et permettant donc de maximiser a priori les chances de gagner ? A priori, c'est à dire en considérant que tout intervalle de temps d'une même durée est uniformément dangereux pour Amy et Britney, et uniformément choisi par les autres internautes.

Pas de chance, ces conditions idéales sont loin d'être vérifiées en pratique, pour une raison finalement toute simple : l'internaute veut gagner son iPod ou sa PS3 maintenant, et pas dans 30 ans ! Donc si vous voulez cibler pour le décès de votre Britney préférée un mois qui n'a encore pas été choisi par les autres visiteurs, il faudra attendre février 2023 ! Pour Amy, il y a eu moins de participants, donc si rien n'a changé depuis la récupération des données, novembre 2016 est encore libre, ou alors tenter l'année 2031, dont seul le mois d'octobre a été choisi. Je dois aussi préciser, comme Matthieu me l'a fait remarquer, qu'aucune date n'est enregistrée sur ces sites après janvier 2038, à cause probablement du codage des dates. Bref, passons aux choses "sérieuses", voilà un petit aperçu du nombre de pronostic par mois (avec simple renormalisation verticale pour Amy qui a reçu moins de votes) :
J'imagine que vous êtes aussi ahuris que je le fus quand les courbes sont apparues : elles sont quasiment identiques ! Coefficient de corrélation de 0.98, on obtient la même loi de puissance. Alors c'est l'occasion de faire un petit intermède mathématique. Pour détecter ce type de loi, on fait un tracé log/log des valeurs (c'est à dire on applique une fonction logarithmique aux abscisses, et aux ordonnées, pour afficher les points de coordonnées (log x,log y)) et on doit obtenir une droite. A vue d'oeil elle a à peu près pour équation Y=4-3X, c'est à dire quand on quitte le repère log/log et qu'on revient au linéaire : log10 y = 4-4/3 log10 x, et enfin y = 10 000 - x^(4/3), ce qui est l'équation de la courbe bleue.

En fait les lois de puissances arrivent très régulièrement dans les analyses de données réelles (en particulier de nombreux graphes petit monde ont une distribution des degrés en loi de puissance). Ce qui est remarquable est qu'ici les deux lois ont à peu près les mêmes paramètres. En regardant en détail on se rend quand même compte que les internautes ont plutôt privilégié 2008 pour Britney (qui semblait vraiment être au plus bas en ce début d'année) et 2009 pour Amy.

En regardant précisément les courbes, ont peut aussi noter une apparente périodicité. En tout cas elles ne sont pas monotones, et une représentation des proportions de pronostics de chaque mois dans l'année pour Miss Winehouse donne la courbe des pourcentages à gauche. Les variations sont étonnantes, entre novembre et août, on passe du simple au double ! Je n'ai pas d'explication a priori sur les choix réduits des mois de novembre, décembre, et février, peut-être que c'est un mécanisme similaire à celui que décrit Knuth dans un de ses premiers exos du tome 2 : demandez à un ami (ou un ennemi) un chiffre aléatoire, vous obtiendez plus souvent le nombre 7.

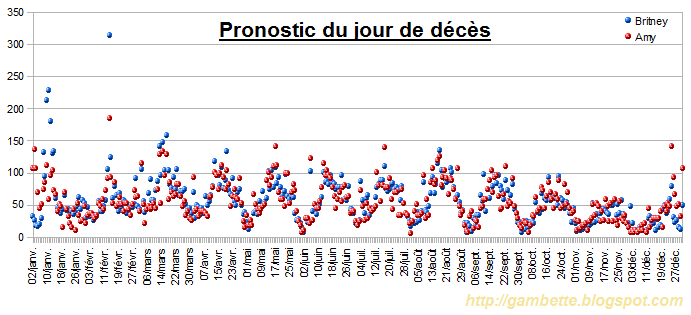
Pour en finir avec les chiffres, la représentation des pronostics par jour, toutes années confondues. J'ai enlevé le premier janvier qui était artificiellement haut à cause du problème du codage des années, qui a donné énormément de 01/07/1970.
Là à nouveau un phénomène de périodicité étonnant, les joueurs préfèrent visiblement les milieux de mois. Notez l'esprit retors qui fait apparaître aussi haut le 14 février, surtout pour la pauvre Britney. Même le point de son anniversaire le 2 décembre apparaît anormalement haut par rapport à ses voisins...

Alors pour oublier tout ça terminons sur une note de recueillement, d'émotion et de poésie, avec les nuages de mots des pré-condoléances pour les deux stars.
This post is translated to English: Britney-Amy, Celebrity Deathmatch.
Fichier tableur des pronostics par jour, par mois, autres fichiers source fournis sur demande, à moins que je les mette ici un jour.

19 octobre 2007

Dissection d'une pétition (1)

De retour après avoir passé du temps à l'Inathèque, déménagé, commencé ma thèse, et préparé mes premiers enseignements, me voilà prêt à décortiquer un nouveau phénomène viral, après la F-list, la pétition "Touche pas à mon ADN".

Là malheureusement, on n'a pas autant d'informations sur la transmission du phénomène que pour les F-lists, mais on va essayer de tirer quelques conclusions à partir de la jolie base de plus de 200 000 signataires disponibles sur le site TouchePasAMonAdn.com. Première difficulté, récupérer la base de données, qui est répartie en plusieurs feuilles de 400 noms. Pour ça j'ai mon "aspirateur" personnel, qui visite les pages voulues en extrayant les informations utiles du code HTML des pages. Une petite difficulté supplémentaire : la liste se met à jour pendant l'aspiration, il a donc fallu mettre en place a posteriori une détection automatique des signataires qui avaient été enregistrés deux fois : en fin de page et en début de page suivante. Ca paraît relativement simple, hein ? Sauf que la tâche se complique quand les organisateurs décident de nettoyer leur base de signataires d'avant le 11 octobre, en réorganisant au passage de façon apparemment aléatoire (rangée ni dans l'ordre alphabétique, ni chronologique) la liste des signatures avant cette date.

Alors pourquoi une telle réorganisation ? Tout d'abord, à cause des signataires qui cliquent mal : beaucoup de doublons apparaissent dans la liste brute. Ensuite, à cause des petits rigolos qui font des blagues. En voilà un petit florilège (vous vous rappelez des Zidane et Chirac d'Unitaid ?), attention la finesse n'est pas toujours au rendez-vous...

04 octobre 2007, 02:15;nicolas sarkozy;nabot présidentiel (république bananière);
04 octobre 2007, 12:29;Nicolas Sarkozy;;
04 octobre 2007, 13:01;Nicolas Sarkozy;Président de rien du tout;
04 octobre 2007, 14:54;NICOLAS SARKOZY;président (france);
04 octobre 2007, 17:43;Nicolas Sarkozy;Président (aucune);
04 octobre 2007, 18:38;nicolas sarkozy;président;
04 octobre 2007, 20:52;Nicolas Sarkozy de Nagy Bocsa;Président, enfin... je crois;
16 octobre 2007, 08:36;nicolas sarkozy;président des francais;
03 octobre 2007, 11:00;brice hortefeux;schizophrène (Dictature Sarkozyenne);
03 octobre 2007, 11:52;BRICE Hortefeux;Fuhrer (République Francaise);
03 octobre 2007, 13:41;hortefeux brice;raciste 2nd;
03 octobre 2007, 17:12;Brice HORTEFEUX;;
03 octobre 2007, 17:28;Brice Hortefeux;Face de pet;
03 octobre 2007, 21:47;BRICE HORTEFEUX;ministre de la betise;
03 octobre 2007, 22:50;Brice Hortefeux;futur ex-Ministre;
03 octobre 2007, 23:13;Brice Hortefeux;;
04 octobre 2007, 16:12;brice hortefeux;;
04 octobre 2007, 16:13;Brice HORTEFEUX;Ministre (SARKOLAND);
16 octobre 2007, 12:16;brice hortefeux;;
03 octobre 2007, 21:59;Thierry Mariani;Député cocu;
03 octobre 2007, 18:48;thierry mariani;député (bientôt chômeur);
12 octobre 2007, 15:04;Thierry Mariani;député;
13 octobre 2007, 21:04;THIERRY MARIANI;MINISTRE : vous êtes tous des rigolos !;
03 octobre 2007, 10:53;GEORGES BUSH;u want2fukme;
03 octobre 2007, 22:22;jorge bush;rongeur (otan);
04 octobre 2007, 15:37;georges bush;;
04 octobre 2007, 23:30;GEORGES BUSH;USA;
13 octobre 2007, 22:54;Debeuliou Bush;President of the United-States of America;
16 octobre 2007, 06:33;georges bush;;
12 octobre 2007, 18:49;François Mitterrand;Illusionniste;
13 octobre 2007, 17:41;Chirac Bernadette;Pute des routes;
16 octobre 2007, 10:57;Jacques Chirac;ancien Président de la République;
03 octobre 2007, 11:35;zidane zinedine;retraité;
03 octobre 2007, 18:05;Zinedine Zidane;ancien footballeur;
03 octobre 2007, 22:50;zidane zinedine;footballeur;
03 octobre 2007, 23:23;zinedine zidane;footballer (OM);
04 octobre 2007, 23:27;Zinédine Zidane;Footballeur retraité;
15 octobre 2007, 18:38;Zinedine Zidane;retraitée du sport (les pervers);
15 octobre 2007, 19:06;Bernard Kouchner;National Socio-traitre (Nazie) (Heil Hitler !);
04 octobre 2007, 23:32;KOUCHNER Bernard;Extérieur du Ministère;
16 octobre 2007, 09:26;Francois Bayrou;Clown;
04 octobre 2007, 10:35;fadela amara;traitre (ump);
17 octobre 2007, 07:20;test test;test (test);
17 octobre 2007, 07:17;Kipeutebattre croustibat;poisson pané (findus);
16 octobre 2007, 02:02;Kylie Minogue;Chanteuse;


Depuis, certains de ces noms ont disparu : les Sarkozy et Hortefeux d'avant le 11 octobre. Il reste les Zidane. J'imagine donc qu'une certaine partie du tri a été faite manuellement (pour automatiser un peu tout ça je suggérerais de classer les signataires par ordre alphabétique et vérifier les groupes de personnes qui ont le même nom et prénom, ou encore d'utiliser FuryPopularity sur les noms de tous les signataires pour identifier les noms connus... et donc suspects). La partie automatique de suppression des répétitions a visiblement été efficace, puisqu'elle a fait passer le nombre de signataires du 4 octobre de 41000 à 33000 environ, pour le 3 octobre de 30000 à 28000. L'ordre de grandeur est toutefois respecté, ce qui peut rassurer les quelques visiteurs étonnés par ces doublons.

Bref, même si la récupération de la base n'est pas immédiate, elle est possible, et je l'ai bien vite enregistrée en supprimant les données nominatives, gardant seulement l'heure et la profession pour chaque signataire. La profession, je la garde en réserve pour la deuxième et la troisième partie de ce billet, regardons seulement l'évolution des signatures pendant la première quinzaine de la pétition :
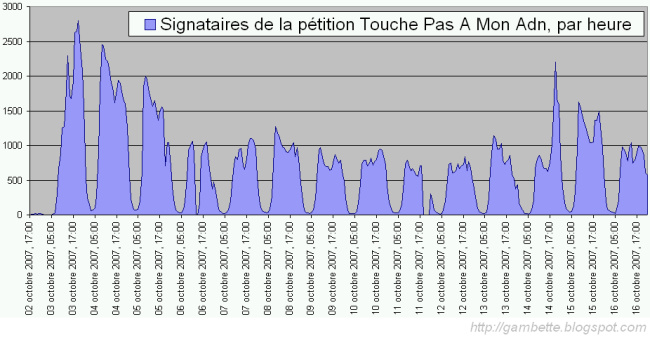
Remarquons d'abord le joli démarrage, qui doit laisser rêveur tout adepte de marketing sur internet... Est-ce que la "qualité du produit" a suffi à attirer une telle foule ? Quels ont été les relais publicitaires pour faire connaître le site aussi vite ? Médias traditionnels, bouche à oreille, blogs, mails ? S'il n'est pas évident de le déterminer (le décollage commence à 8h du matin !), on peut en revanche remarquer une forte corrélation entre le nombre de billets de blogs citant la pétition, ou son adresse, et le nombre de signataires :
Notre tableur préféré nous donne un coefficient de corrélation de 0.80 entre le nombre de signataires et le nombre de billets quotidiens contenant "Touche pas à mon ADN" d'après Blogsearch, 0.76 avec le nombre de ceux qui contiennent le lien vers touchepasamonadn.com. Remarquons aussi que les deux courbes Blogsearch très proches avant le 13 octobre divergent ensuite. Pourquoi ?

La clé de l'énigme, c'est le meeting concert Touche pas à mon ADN, dont les gens ont visiblement parlé sur leur blog sans donner l'adresse de la pétition. Toutefois l'événement a eu un retentissement médiatique qui se visualise très bien le 14 octobre au soir avec deux pics de signatures vers 19h50 et 20h20, et qui redonne de l'énergie au nombre de signatures par heure.

Enfin vous aurez noté sur le graphique de l'évolution des signatures deux interruptions du site, le 11 octobre au soir, et le 6 octobre avant 17h. Il semble tout de même avoir tenu le coup aux moments les plus critiques.

Pas encore efficace, cette pétition montre toutefois quelques conditions nécessaires pour un succès. Un relai médiatique, une solide structure technique pour accueillir les signatures voire vérifier leur authenticité. Où s'arrête l'initiative populaire et où commence le lobbying super organisé et forcément bien financé ? En attendant de telles initiatives permettent au moins de maintenir une certaine vigilance... et nous donner des indications sur les horaires de surf des étudiants, des enseignants, des retraités, des chercheurs, des ingénieurs. A suivre très bientôt, dans le prochain billet !

1 octobre 2006

Quand la loi de Zipf atteint le nombre des années...

J'ai étudié le nombre de résultats Yahoo (parce qu'on sait bien que Google pour faire des stats c'est mââl) pour tous les nombres à 4 chiffres entre 1901 et 2006, et la loi de Zipf semble pointer le bout de son nez. En effet le nombre de résultats n(x) semble inversement proportionnel au nombre x recherché. Pour visualiser cela un peu mieux, je trace non pas la courbe de n(x), mais celle de 1 000 000 000/n(x), en pensant obtenir à peu de choses près une droite. Au passage, je ne représente pas les valeurs pour x divisible par 10, puisque ces nombres sont généralement beaucoup plus présents sur le web que leurs voisins, et créent donc du bruit dans les données obtenues (du bruit, étant donné l'utilisation qu'on veut en faire, cf ci-dessous). Voilà le résultat obtenu, avec en violet la droite de régression linéaire de ces points (merci OpenOffice Calc) :

On peut remarquer que globalement, les points sont bien proches de cette droite, à part après 2006. Mais en zoomant un peu plus, on voit que le comportement diffère entre 1995 et 2006. C'est donc plutôt deux segments de droite qui semblent décrire le mieux les valeurs obtenues, entre 1901 et 2006.

Je m'attendais à visualiser plus clairement certaines "années clé", comme 1914, 1918, 1939, 1945... C'est en effet le cas pour 1945 qu'on voit plus bas que prévu (étant plus cité sur le net que 1944 ou 1946), ou 1901 (vive la loi sur les associations !).

Bon, et maintenant, quelle utilité à cette remarque ? Eh bien justement à évaluer la pertinence des résultats chiffrés des moteurs de recherche pour faire des statistiques. Il s'agira tout d'abord de déterminer expérimentalement quelle loi semble la plus correcte (par exemple : il y a forte corrélation entre 1/x et le nombre de pages sur internet contenant le nombre x pour x allant de 1901 à 1994, avec x non divisible par 10). Si ça semble effectivement être le cas sur tous les moteurs, le coefficient de corrélation trouvé permettrait d'évaluer la qualité du moteur pour une utilisation statistique (notamment de calcul de la NGD).