Affichage des articles dont le libellé est presse. Afficher tous les articles

17 avril 2009

Cartographie au Figaro

Hier soir, le Figaro a "révélé" le "le palmarès 2008 des violences, sur la base des données officielles de l'Observatoire national de la délinquance (OND)", et choisit de l'illustrer avec la carte des atteintes volontaires à l'intégrité physique en titrant "La nouvelle carte de France de l'insécurité". Buzz assuré, une centaine de commentaires en quelques heures...


Mais que nous apprend la carte ? Comparons-la avec celle des densités par département :

Elles se ressemblent, hein ? On peut le vérifier précisément en faisant un graphique du taux d'atteintes volontaires à l'intégrité physique en fonction du log de la densité :La corrélation est assez claire, on a un coefficient de 0.67 (et 0.81 en omettant la Guyane). Bref, la carte n'est pas très utile, et servirait au mieux à illustrer le principe bien connu par les chimistes que des concentrations élevées favorisent les chocs... L'auteur de l'article aurait pu au moins mentionner cette remarque basique et concentrer son analyse sur les exceptions à cette règle, ou bien choisir une autre carte un peu plus riche en informations, par exemple celle des atteintes aux biens, accessible par un clic sur la carte interactive des atteintes à l'intégrité physique.

Données liées à ce billet : fichier tableur OpenOffice.

Edit de midi : tiens, je lis sur Twitter qu'en plus ils ont confondu Martinique et Guadeloupe sur la carte.

7 avril 2009

Candidats en 2012 : courbes Google et revue de presse

Depuis juillet dernier, je suis régulièrement la progression de plusieurs candidats potentiels aux présidentielles de 2012 d'après Google (ma liste initiale s'est complétée avec les "candidats possibles" listés sur le site d'Alain Mourguy). Les "nombres Google" sont peu généralement peu fiables, mais un suivi régulier permet malgré tout d'identifier quelques tendances. Voici les courbes récupérées pour quelques figures majeures à gauche et à droite, où l'on peut remarquer le pic récent de Villepin qui refait parler de lui :

Certains pics semblent correspondre à du bruit (ou des secousses annonciatrices ?), mais la plupart des variations significatives des courbes peuvent être mises en relation avec l'actualité de ces diverses personnalités politiques et leurs interventions médiatiques, ou des articles sur leur possible candidature en 2012 (certaines ne sont pas dans les graphiques ci-dessus mais apparaissent dans mes données) :
Cette mini-revue de presse s'ajoute à celle, plus fournie, du site presidentielle2012.net. En fait, elle la complète, en y ajoutant des éléments, notamment des vidéos ou des articles publiés seulement sur internet (vidéos Dailymotion, articles de blogs ou du Post...). De plus, elle précise le type de lien avec une possible candidature en 2012 : question quand l'intéressé n'y répond pas clairement, possibilité s'il se déclare intéressé, contexte s'il est seulement pressenti par les observateurs, ou canular si c'est dans un cadre humoristique. Et surtout, elle ne représente que les informations qui ont eu un effet sur le web assez fort pour être détecté par Google.

Et pour ceux qui s'intéressent déjà à 2017, quelques ambitions se dessinent, et les courbes commencent aussi à se construire...

6 août 2008

L'agence de presse des spammeurs

"Google accusé d'espionnage par l'Union Européenne",
"La Wii Fit utilisée pour entraîner les troupes américaines",
"Bush évite un soulèvement albanais en envahissant l'Alabama",
"Al Pacino soupçonné de financer la mafia"...
Vous en avez loupé des choses cet été, vous dites-vous en consultant votre boîte mail au retour des vacances !

En fait, ce que vous avez surtout loupé, c'est un mois de juillet marqué par des spammeurs farceurs et originaux dans leur choix de sujet de mail constitué d'un faux-titre d'article de journal. Dommage, ça n'allait pas plus loin que le titre, et ces courriels contenaient généralement seulement une autre phrase du même tabac suivie d'un lien vers un site douteux. Le phénomène s'est apparemment arrêté depuis quelques jours. Je n'ai pas résisté au plaisir de compiler tout ça, puisque la période du 6 juillet au 3 août a été très productive pour le Monsieur Titres à l'origine de ces trouvailles, qui pourrait sans problème envoyer son CV à France Dimanche ou trouver des titres encore plus racoleurs aux articles du Post.

Quelques détails techniques sur la cueillette de ces titres : récupération manuelle sur quatre adresses mails, puis recherche Google de certains d'entre eux, pour tomber sur un splog qui a doublé ma récolte (titres récupérés par mail, sur le splog, listes concaténées en éliminant les doublons). Le fichier obtenu m'a permis de tester ma dernière version (0.5) de TreeCloud (ça y est, elle est utilisable sans devoir installer SplitsTree, on en reparlera, informations et téléchargement ici). Bref, voici un petit nuage arboré qui permet de voir quelques thèmes forts qui doivent éveiller la curiosité de l'anglophone moyen :

Et comme l'arbre ne semble finalement pas si louche (à part peut-être le sous-arbre des sex-tapes d'Obama et MacCain), un petit best-of - que je n'oserai pas traduire - pour voir à quel point les nouvelles annoncées étaient bidon :
Statue of liberty to return to France
Ex-Google engineers debut 'Cuil' way to search
(décidément, cette non-information est partout !)
Angry man shoots lawnmower
Prada gives fake bags to charity
Release Of The Nancy Pelosi Sex Dvd Causes Mass Mass Erectile Dysfunction In US
Tupac Shakur Speaks Out From Beyond The Grave: "Stop Releasing My Stanky Old Songs"
Bush And Mccain Dance Ballet
Jesus Christ To Star In Next Series Of Batman
Madonnas Former Home Destroyed By Jesus
Jesus Christ To Star In Next Series Of Big Brother
The truth about ghosts revealed
Mermaid discovered off NZ coast
Yahoo search shuts down for good
Swedish princess slaps town florist
Danish princess slaps town grocer
Black Panthers Sue White Guys For Stealing Copyrighted Gesture
Bush 'Troubled' by Gay Marriages. Declares San Francisco Part of 'Axis of Evil'
Beijing Olympics cancelled, moved to Atlanta
Living proof that the earth is flat available
Angelina Jolie gives birth to triplets

Et que s'est-il passé le 3 août ? Ces spams ont été remplacés par un nouveau format : de faux mails d'alerte de CNN. Certes, on a une vingtaine de titres pour le prix d'un, mais ça sent le recyclage : pas mal d'entre eux sont déjà présents dans la liste que j'ai compilée. Et surtout il faut cliquer une première fois pour accéder au corps du message, contrairement au titre dans le champ Sujet du mail qui sautait tout de suite aux yeux. Bah, en attendant qu'ils reviennent à la version précédente, je me contenterai du RSS du Monde.

2 mars 2008

Suivi en direct de la naissance d'un buzz

Je rêve depuis quelques articles de pouvoir suivre en direct la naissance d'un buzz sur internet, et évaluer la performance des divers outils dédiés à leur analyse et détection. J'aurais préféré un sujet plus léger, mais c'est la tragédie de la Northern Illinois University qui m'en a donné l'occasion il y a deux semaines.

L'identité du tireur n'était pas été dévoilée le soir du drame. Mais dans la nuit (10 heures après), le Chicago Tribune fournissait sur son site internet assez d'éléments pour lever l'anonymat, tout en précisant de façon plutôt hypocrite :

The Tribune is not naming the gunman because police have not officially completed the identification of his body.
Une simple recherche d'articles co-signés par Jim Thomas et avec les mots clés "self-injury" et "prison" permettait d'identifier le suspect : Steve Kazmierczak. A 8h10, un visiteur de la Wikipedia modifie l'article concernant la fusillade pour y indiquer ce nom. Une trentaine de minutes plus tard, premier article de blog qui le cite, son auteur le met à jour plusieurs fois pour y ajouter d'autres informations trouvées sur internet. Le nom apparaît alors sur un blog et un forum, et à 10h33, est cité par le Daily Mail (l'article a été mis à jour depuis). Les internautes commencent alors à le soumettre aux moteurs de recherche, et il se retrouve en tête de la liste des "hot trends" de Google. Il est donc immédiatement repris par quelques splogs, qui semblent faire leur beurre en citant les tendances du moment éventuellement accompagnées de quelques extraits de pages web les concernant, récupérées automatiquement. A 14h42, l'agence Associated Press annonce que la police a rendu public le nom de Steven Kazmierczak. Mon suivi du buzz s'est arrêté là, puisque les articles ou pages web sur le sujet ont alors utilisé les prénoms "Steve", "Steven" ou "Stephen".

Quoi qu'il en soit, suivre les premières heures m'a permis de noter la réactivité des divers moteurs de recherche et outils de suivi de la blogosphère ou plus généralement du web. Comme je l'ai mentionné ci-dessus, c'est la Wikipedia qui a dévoilé l'identité en premier. Une occasion de plus d'en noter les possibles dérives, mais aussi de s'incliner devant la puissance de cette formidable machine à scoops. C'est dans l'encyclopédie que j'avais trouvé le premier compte-rendu clair de l'affaire Kerviel, après plusieurs jours d'évocation de "fraude" sans plus de détails dans les articles de presse que j'avais parcourus. On peut aussi s'y informer sur les décès de personnalités, en utilisant l'outil Wikirage qui par exemple montrait en tête le 13 février : Henri Salvador, Imad Mougniyah, et Badri Patarkatsishvili.

A propos des outils de suivi de la blogosphère, on peut noter que BlogPulse n'est pas très réactif. Evidemment Google Blogsearch est le premier à détecter le premier billet de blog sur le sujet, hébergé par... Blogspot. Dans l'ensemble il paraît toutefois faire jeu égal avec Technorati, dont la courbe un peu plus élevée à partir de 14h s'explique par quelques splogs non répertoriés (de façon volontaire ou non ?) par Google.

La réaction des moteurs de recherche sur la requête "Steve Kazmierczak" est aussi assez intéressante. Le buzz leur échappe complètement pendant ces premières heures... à part Google. Pour ce dernier, même si ça n'est pas clair sur le graphique, le nombre de résultats pertinents augmente bien, passant de 61 à 10h30 à 68 à 16h (les nouvelles pages proposées en résultat sont effectivement liées à l'affaire). L'explosion du nombre de résultats sans filtre de pertinence est en revanche tout à fait étonnant, et renforce le mystère sur les "nombres Google" : le nombre de pages pour cette requête a-t-il réellement doublé en 5h, ou bien n'est-ce qu'une approximation douteuse ?

Mais le plus important, c'est peut-être les courbes de Google Trends qui nous l'apprennent. Avant que la presse ose dévoiler le nom du tireur, avant que Wikipedia l'apprenne, Google était déjà au courant, avec les premières recherches sur ce nom moins de 3h après les faits. Leur domination sur le marché des moteurs de recherche leur donne aussi un accès direct à l'information, et leurs outils sont apparemment prêts pour l'exploiter au maximum. Avec la géolocalisation notamment, qui permet de cibler la provenance des requêtes et donc d'un éventuel buzz local. Alors à quand une agence de presse ou un tabloid Google, qui dévoilera ses scoops et rumeurs des heures avant le DailyMail ? Et qui a aujourd'hui accès aux données brutes de Google Trends en direct ? Sur le site, actuellement, les courbes sont actualisées au moins après 48h, ne sont pas fournies pour les termes pas assez recherchés, l'échelle horizontale n'est pas tout à fait précisée (j'interprète, peut-être à tort, que le point au-dessus de 4AM représente le nombre de recherches de 3AM à 4AM), sans parler de l'échelle verticale inexistante ! Bientôt une API Google Trends permettra peut-être d'accéder à ces données, et de rendre aux internautes la "connaissance" acquise grâce à eux...


This post is translated to English: The birth of a buzz, live.
Données brutes ayant servi à la réalisation des graphiques (fichier tableur OpenOffice)

1 février 2008

Traquer les mots moches

Las d'écorcher les yeux et les oreilles de mes proches, après 4 journées de stage de technesthésie pour améliorer mon expression orale (merci le CIES !), j'ai décidé de m'attaquer à mes erreurs et tics lexicaux. Anglicismes, complexifications inutiles, abus de langage, tout cela est recensé dans le Dicomoche. Encore faut-il repérer qu'on en utilise !

J'ai commencé à construire un site dédié à cela. Pour l'instant c'est tout à fait basique, le "Démocheur" (version beta) se contente de colorer certains mots moches ou potentiellement moches. Quand je dis basique, ça signifie aucune analyse lexicale, un simple fonctionnement par rechercher/remplacer. La liste actuelle de mots moches est très réduite, elle est destinée à s'enrichir au moins par le contenu du dicomoche, mais tout visiteur du Démocheur peut y proposer ses mots moches. Je mettrai certainement en place un système de vote pour laisser aux visiteurs la possibilité d'évaluer la laideur de chaque expression, dans un esprit de démocratie tout à fait web2.0. Reste à voir, une fois que les problèmes sont identifiés, comment les corriger, et là c'est au visiteur de se casser la tête, en suivant éventuellement les liens vers le dicomoche.

Résultat du démocheur

9 janvier 2008

Sarkozy l'Orateur (1) : version prévue et prononcée du discours de la conférence de presse

Devinette : du sketch de quel humoriste engagé sont tirées les lignes qui suivent ?

« Le G8, mais enfin qu'est-ce que c'est ? On se réunit deux jours et demi, sans la Chine, sans l'Inde, sans le Brésil, sans le Mexique, sans l'Afrique du Sud. Simplement, deux milliards et demi de gens qu'on oublie. Ah, alors évidemment, on les invite pour le déjeuner du troisième jour. Le plus extraordinaire c'est qu'ils viennent. »
Non, pas Bedos. Non, pas Dieudonné... Mais bien notre Président, dans la version prononcée de son discours de conférence de presse d'hier, que vous ne trouverez pas en PDF sur le site de l'Elysée.Un petit aperçu de la réaction du public, avec Morin et Kouchner, et un troisième que je ne reconnais pas, qui se bidonnent. Bon, en fait tout le discours n'était pas prononcé sur un style aussi décontracté, qui apparaissait seulement dans les impros de Nico sur le texte original.

Alors évidemment, c'est le texte original qui m'avait attiré tout d'abord, pour en faire le nuage arboré. Contrairement au discours de voeux, la version PDF sur le site de l'Elysée a un codage étrange qui m'empêche d'en récupérer le texte (si vous comprenez ce qui se passe, ou savez comment le récupérer quand même, ça m'intéresse beaucoup !), heureusement que Linternaute (je n'ai jamais dit tout le bien que je pense de ce site où on trouve absolument tout et n'importe quoi) est là pour me fournir un document exploitable. Malheureusement les différences avec le discours réellement prononcé sont importantes ! Ni une, ni deux, me voilà parti dans la transcription. Mon temps de sommeil en a un peu pâti, mais le résultat est là. Non seulement vous avez le texte, mais aussi une intuition sur sa prononciation, puisque je suis allé à la ligne à chaque pause. Les sauts de ligne indiquent seulement une différence thématique, ils correspondent à peu près aux sauts de paragraphe du discours prévu. Evidemment j'ai pu y glisser des erreurs ou omissions, n'hésitez pas à me les signaler...

Bon, et maintenant, jouons aux 7 différences entre les deux versions. Pour comparer deux fichiers j'utilise habituellement CompareIt qui essaie d'identifier des lignes entre fichiers (fichier du texte originalement prévu), et présente une visualisation plutôt bien faite de l'alignement effectué, la bande verticale sur la gauche. Pour un meilleur contraste, j'ai mis les lignes identiques en noir, celles ajoutées en vert, celles supprimées en rouge, et celles modifiées en bleu. CompareIt permet aussi d'exporter un rapport des différences avec les textes sur deux colonnes, que vous trouverez ici.

Peut être trouvez-vous plus lisible de voir sur un seul texte les deux versions, comme Jean Véronis l'avait fait pour le discours de Ségolène Royal à Villepinte. Pour cela j'ai utilisé Diff'Doc, qui est gratuit, voilà donc la synthèse des textes prévu et prononcé.

Evidemment ce document est une mine d'informations pour qui veut analyser le style oratoire de Sarkozy, puisqu'on y trouve à la fois ses longs passage d'improvisation, mais aussi ses petites corrections de détail, ou encore les passages qu'il a finalement décidé d'oublier. Il est flagrant sur la bande-image de gauche qu'il se lâche au fur et à mesure, et finit son discours en oubliant complètement le dernier paragraphe initialement prévu.

Au programme de la seconde partie de ce billet, bien sûr les nuages arborés des deux textes : est-ce que les modifications lors de la prononciation du discours changent radicalement les arbres ? Et peut-être aussi une analyse plus en profondeur des différences (le verbe épouser a été ajouté oralement par deux fois par rapport au texte original ;))...


Pour ceux qui ont lu en diagonale : le discours prévu, le discours prononcé, le diff Diff'Doc sur 1 colonne de texte, le diff CompareIt sur deux colonnes de texte, mon billet suivant sur le sujet.

27 avril 2007

Postures et énigme politicombinatoire

Avec les débats Royal-Bayrou demain et Royal-Sarkozy la semaine prochaine, on peut espérer que la campagne va toucher au fond des discours de chacun, après avoir plutôt touché le fond. La campagne du premier tour a été une succession de postures (et d'impostures ?).

Les trois candidats arrivés en tête ont tenu à incarner le politique nouveau, avec en particulier une liberté de ton rafraîchissante, à laquelle chacun a ajouté ses spécificités. Ségolène Royal s'est définie comme l'incarnation de l'ordre juste, de la femme, de la mère, du vote utile anti-Le Pen. Pour Nicolas Sarkozy, c'était la fermeté, la réforme ou rupture, et plus récemment le rassemblement. François Bayrou a commencé par être l'opposant aux puissances médiatiques, pour devenir le centriste en lutte contre le bipartisme, ou encore le vote utile anti-sarkozy.

Ces postures ont l'avantage d'être très faciles à médiatiser. Elles créent la polémique et peuvent facilement être démontées par les adversaires : les qualités mises en avant par le candidat sont retournées contre lui, ou tout simplement niées preuve à l'appui ou presque. Royal a donc subi le machisme et les accusations d'incompétence. Sarkozy est devenu un facho, ou l'héritier du bilan du gouvernement sortant. Bayrou, un utopiste sans majorité à l'assemblée profondément ancré à droite.

Le débat "proposition contre proposition" sur des questions précises n'a jamais été mis en avant à la télévision ou dans la presse écrite. Ce que j'aurais aimé avoir, ce n'est pas le catalogue de propositions de chacun des candidats, mais plutôt, sur chaque thème, les différents points de vue et les convergences. Des tentatives de synthèse ont été entreprises, mais elles ne faisaient pas apparaître clairement les consensus et les incompatibilités. C'est une démarche que j'aurais attendu de la part des centristes : combien de points du pacte présidentiel de Ségolène Royal seraient acceptés aussi par Nicolas Sarkozy ? On en a vu défiler, des pactes ou questionnaires (celui de Nicolas Hulot, du collectif AC Le Feu, des langues, le questionnaire sur les logiciels libres...) : ce sont devenus des packs de propositions ne donnant lieu à aucun débat contradictoire, aucun résumé synthétique.

Et les sites qui prétendaient avec une série d'une vingtaine de questions calculer votre similarité avec tous les candidats ? Où sont les tableaux des réponses des candidats à ces questions ? Pour une fois qu'on aurait pu avoir un avis clair (voire binaire) à des questions censées nous déterminer politiquement de la part de tous les prétendants...

On a préféré la politique spectacle, plus facile à "vendre", et plus ludique. Attention, je ne le critique pas totalement : déjà, ça a permis d'atteindre presque 85% de participation au premier tour. Je vais même plus loin, c'est l'appréciable, voire nécessaire, première étape d'une démarche qui me plaît : commencer par des légèretés pour motiver à "mettre les mains dans le cambouis". Exprimé par Stefan Zweig dans La Confusion des Sentiments : "celui qui n'est pas passionné devient tout au plus un pédagogue ; c'est toujours par l'intérieur qu'il faut aller aux choses, toujours, toujours en partant de la passion." Et si on a droit à de vrais débats de fond calmes et intéressants dans les jours qui viennent, après la passion de l'avant premier-tour, la campagne présidentielle de 2007 sera réussie !

Et maintenant à moi d'illustrer cette démarche, en motivant un problème combinatoire par une petite histoire de politique d'image et de posture : le Problème du Club de Réflexion, que j'appellerais presque le problème du siècle (issu d'une discussion initiée avec Nergal)...

F.B. affirme n'avoir pas parlé à N.S. depuis 3 ans. Ces deux hommes appartiennent à un même club de réflexion, qui se réunit tous les mois de la façon suivante : parmi tous ses n membres, un certain nombre est invité à venir manger à l'Automobile Club de France. Ils peuvent alors discuter autour de tables de k personnes. Disons qu'il y a t tables. En pratique il paraît que k=7, qu'environ 300 personnes participent à chaque dîner soit t=43, et que le club a environ n=700 membres. La première question, facile, consiste à déterminer quelle est la probabilité que F.B. n'ait en effet jamais dîné à la même table que N.S. depuis 3 ans, en supposant que les organisateurs des soirées invitent et placent leurs membres aléatoirement à chaque fois.

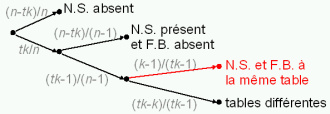
Calculons la probabilité à chaque réunion que F.B. ne soit pas à la même table que N.S. Est-ce que N.S. est là ? Il y a seulement tk invités, donc il n'est pas là avec proba (n-tk)/n. S'il est là, alors F.B. n'est pas là avec proba (n-tk)/(n-1), et il est là avec proba (tk-1)/(n-1). Si les deux sont là, alors une fois que N.S. est placé il y a k-1 chaises vides autour de lui, et il reste à placer tk-1 convives donc F.B. n'est pas à sa table avec proba (tk-k)/(tk-1). Comme on le voit avec l'arbre de toutes les possibilités ci dessous, on obtient la probabilité que F.B. ne soit pas à la table de N.S. à une réunion par la formule :

P=(n-tk)/n + tk/n ((n-tk)/(n-1) + (tk-1)/(n-1).(tk-k)/(tk-1))


Soit pour les valeurs de n, t et k données une probabilité de 99,6309% que F.B. et N.S. ne se rencontrent pas à une certaine réunion. On élève à la puissance 36 pour chacune des 36 réunions en 3 ans : il y a 87,5% de chances qu'ils n'aient effectivement pas mangé à la même table pendant tout ce temps...

La deuxième question, beaucoup plus compliquée, consiste à trouver la stratégie de placement des organisateurs. On considère raisonnablement qu'ils veulent que tout le monde parle avec tout le monde. Quel est donc le nombre minimum de réunions à effectuer pour qu'en effet tout le monde ait mangé au moins une fois avec tout le monde ? Et comment inviter et placer les membres pour atteindre ce minimum ? En déduire le nombre maximal de réunions consécutives où N.S. et F.B. ne mangent pas à la même table.

Si on prend la restriction de ce problème avec n=tk et k=2, ça revient à un problème d'organisation de tournoi d'échecs : on a n participants, et on fait jouer en parallèle t parties, en cherchant à minimiser le nombre de parties permettant que tout le monde ait joué contre tout le monde. Cela nous permet d'introduire de la théorie des graphes : on considère le graphe complet, c'est à dire qu'on relie un ensemble de 2k sommets (les joueurs) par toutes les arêtes possibles, chaque arête correspondant à une partie d'un joueur contre l'autre. On va colorier les arêtes de telle sorte que les couleurs correspondent à des parties qui peuvent se dérouler en parallèle, c'est à dire que deux arêtes partageant un même sommet n'auront pas la même couleur. On cherche à minimiser le nombre de couleurs, c'est à dire l'indice chromatique du graphe complet à 2k sommets. Le problème, classique ("promenade des demoiselles"), est résolu ici : 2k-1 couleurs (donc 2k-1 parties) suffisent, vous avez même la configuration des parties !

Pour le cas général je cherche encore, quelques variantes du problème sont réunies sur cette page...

23 avril 2007

Bilan des sondages du premier tour

SarkolèneLe premier tour des élections présidentielles hier a marqué un succès, celui des sondeurs, dont les estimations se sont révélées assez correctes.

Le journal Le Monde proposait une formidable visualisation en Flash de tous les sondages d'intentions de vote pour la présidentielle française parus depuis octobre 2006. Bon, Flash, c'est pas le meilleur format pour récupérer automatiquement les données... mais l'ergonomie permettait quand même une bonne récupération manuelle. Toutes ces données sont donc disponibles dans ce fichier Excel (ou OpenOffice), voici quelques graphiques qu'on peut en extraire et analyser, maintenant que des résultats définitifs ont été publiés.

L'interface du Monde permet de visualiser pour chaque institut l'ensemble des sondages qu'il a publiés : résultat, on obtient des courbes assez irrégulières dont les tendances générales n'apparaissent pas vraiment. Superposer tous les résultats donne un nuage de points beaucoup plus parlant (regardez ce que ça donne pour Bush chez le "Professor Pollkatz") :

Ceci dit, tout ça n'est pas vraiment parlant si on veut visualiser les 12 candidats (ou comparer plusieurs indices), pour cela il vaut mieux effectuer une moyenne, qui aura pour effet de fournir une courbe un peu plus lissée. C'est donc ce que j'ai fait, en calculant pour chaque jour la moyenne obtenue d'après le dernier sondage paru pour chaque institut (ça se fait très bien avec les formules Excel/OpenOffice, et franchement, c'est plus joli/lisible/rigoureux que les courbes du CEVIPOF, non ?).

Présidentielles sondages premier tourEvidemment l'extrémité droite de la courbe correspond aux résultats réels. On remarque que les trois principaux candidats avaient été généralement sous-évalués, et Jean-Marie Le Pen sur-évalué, et supposé assez haut par les électeurs pour motiver un vote "utile" pour Ségolène Royal au premier tour visiblement. La montée de François Bayrou commence à la mi-janvier, mais il décroît un mois avant la date fatidique. Tiens, ce serait intéressant de les superposer précisément avec sa courbe de Presse2007, j'ai l'impression à l'oeil nu que celle des sondages précède légèrement la popularité dans la presse (sachant que la courbe des sondages présente un retard intrinsèque lié au délai de publication, et à une sorte de délai d'harmonisation des 6 instituts puisque c'est une moyenne...).

Au passage, on peut s'amuser des approximations faites par les différents instituts, dont la somme des intentions de votes publiées n'atteint pas toujours 100%. Puisque les nombres ne sont pas "bruts" et sont issus d'une petite cuisine secrète, ils pourraient quand même s'arranger pour les arrondir dans ce sens. Ceci dit, ce cas arrive assez rarement, et ceux qui mettaient à jour le document Flash du site du Monde auraient pu tester à chaque fois la somme, pour vérifier leurs chiffres (qui font apparaître quelques petites erreurs... bah, au moins, ils les corrigent rapidement).

Et maintenant voyons quels instituts avaient le mieux deviné les résultats. Pour ça, on peut calculer une distance (je n'indique pas l'échelle qui ne veut pas dire grand chose, il suffit de retenir que plus c'est haut, plus l'erreur est grande, voir le fichier Excel pour les détails ou essayer d'autres distances) entre les résultats prévus (dernier sondage paru vendredi dernier ou avant), et ceux réellement obtenus : bravo à Ipsos (labosonic m'alerte en commentaires sur le fait qu'il existait des données pour vendredi pour BVA aussi, qui fait alors mieux que Ipsos) ! J'ai ajouté aussi la moyenne des sondages des 6 instituts et le dernier sondage du site Votez2007.com. Avec ce dernier, on se rend compte que publier des sondages sérieux nécessite une expérience que ces professionnels revendiquent et détaillent quand ils sont mis en cause. Il peut sembler contre-intuitif que la moyenne donne de moins bons résultats que 4 sondages parmi 6. En fait on découvre en apprentissage automatique que combiner de bons outils pour en faire un meilleur ne se fait pas vraiment naïvement (par une moyenne), mais avec des techniques un peu sophistiquées.
Voir aussi : une excellente analyse, plus détaillée, des taux d'erreur des sondeurs.

On peut donc faire totalement confiance à nos chers sondeurs pour nous prévoir le résultat du second tour... Ou pas. Vous avez entendu les sondages à la sortie des urnes ? Pour ça il ne fallait pas lire les blogs, mais écouter la radio suisse romande : vers 18h30, on apprenait que Royal et Sarkozy étaient à 26%, Le Pen à 17 et Bayrou à 16 ! Quelques minutes plus tard heureusement, les premières estimations tombaient, un peu plus conformes à la réalité.

La suite ici (bilan des sondages de 2002)...

28 février 2007

Correction de contenu en ligne et archivage

Hier au bureau, circulait la thèse de Bill Cunningham, chercheur canadien en théorie des graphes. Un pavé de pages tapées à la machine en 1973, du temps où le logiciel référence pour écrire proprement articles et thèses, TeX, n'existait pas (la première version date de 1977), et où il fallait encore remercier son épouse pour avoir écrit à la main les lettres cursives inexistantes sur la machine à écrire... Maintenant qu'existent de formidables moyens techniques pour non seulement corriger facilement un document numérique, mais en plus le faire modifier par plusieurs personnes situées à divers endroits de la Terre, il est difficile d'imaginer comment le système était gérable à l'époque.

Enfin même si les moyens techniques facilitant le travail de correction existent, tous ne le mettent pas en place. De ce point de vue le journal Le Monde fait un travail impressionnant sur son édition en ligne. Il est très facile de les contacter par une adresse mail destinée au courrier des lecteurs. Ils sont alors très réactifs pour corriger l'édition en ligne de l'article. Et pas seulement pour l'orthographe !

J'ai remarqué hier une correction du titre d'un article qui faisait apparaître une ambiguïté, classique, entre points et pourcents. Titre original (capturé par le flux RSS de Presse 2007 présent sur ma page d'accueil Google personnalisée) : "Il y a 8% de voix de gauche dans les intentions de vote de François Bayrou". Titre modifié : "Près de la moitié des électeurs de François Bayrou sont issus de la gauche". On remarque comme sur tous les articles la présence de la date de publication, mais aussi de dernière modification, et on peut ainsi constater la réactivité des correcteurs.

Quel dommage toutefois que toute cette réactivité soit finalement annulée dans les archives d'articles ! En effet, l'archivage a lieu dès la première publication sur le site et les modifications ultérieures ne sont pas prises en compte. C'est malheureux, mais c'est souvent le cas : on impose une date limite à partir de laquelle toute modification est impossible. En ce qui concerne les articles scientifiques, on peut toujours publier après coup un erratum concernant une éventuelle erreur de raisonnement, mais rien n'est prévu pour corriger ces ennuyeuses coquilles, erreurs de variables, ou d'indices, qui échappent lors des relectures successives, mais qui sont si gênantes pour le lecteur qui s'intéresse à une preuve en détails. Même chose sur le site de l'Assemblée Nationale, dont j'avais contacté les webmasters lors de ma construction de l'arbre des députés. Les analyses des scrutins publics présentes sur le site web sont l'exacte copie de ce qui est publié au journal officiel, ce qui explique que les noms des députés (ou les prénoms : Luc-Marie Chatel est devenu Luc Chatel entre le 20 mars et le 17 mai 2006) ne soient pas mis à jour. Finalement, c'est peut-être là un avantage important du blog sur les autres moyens d'information : il est toujours possible, et facile, d'y modifier un article pour le corriger, le mettre à jour, ou simplement ajouter un pointeur vers un article ultérieur sur le même sujet.

Et puisque j'ai évoqué le journal Le Monde, un joli exemple de propos tronqués à propos de l'intervention de Ségolène Royal sur France Inter lundi matin :
"J'observe que nulle part les élus de l'UDF ne viennent en appui des politiques de gauche lorsqu'elles sont conduites dans l'intérêt général" ; ils "votent toujours avec la droite et font des campagnes de droite", a-t-elle affirmé. La fin de la phrase semblait en effet complètement fausse dans le cas des députés UDF. Et en effet, après vérification sur le site de France Inter, la phrase commence par : "Je suis présidente d'une région, vous le savez. Il y a beaucoup de chefs de l'exécutif que ce soit dans les départements, les communes, et les régions, et j'observe que nulle part...".

14 janvier 2007

Chiffres douteux

On a assisté à deux batailles de chiffres dans la presse cette semaine : à propos de délinquance et du taux d'élucidation d'une part, du nombre de français gagnant plus de 4000 euros par mois d'autre part. Dans les deux cas, la plupart des médias se sont contentés de transmettre des informations brutes sans aucune vérification des chiffres fournis. Il est vrai que dans les deux cas, les chiffres cités ne semblaient pas tout à fait absurdes, et donc pas nécessairement suspects.

J'avais en revanche remarqué au mois de décembre pendant le Zapping de Canal Plus une série de statistiques complètement incohérentes qui n'avait visiblement choqué personne à Euronews :
"Selon les recherches d'Amnesty International, une femme meurt toutes les heures entre les mains d'un parent, d'un compagnon, ou d'un ancien compagnon. En Grande-Bretagne, les services d'urgence reçoivent eux un appel toutes les minutes concernant un incident violent dans la famille. Enfin, en France, de récents chiffres du gouvernement ont révélé qu'une femme meurt toutes les quatre heures sous les coups de son partenaire." (extrait audio, émission en vidéo, Europeans, le 14 décembre 2006 sur Euronews)

D'après cet extrait, la France contribuerait donc pour au moins un quart des violences contre les femmes dans le monde ! Ce n'est évidemment pas le cas, et une recherche Google permet de déterminer les vraies infos et l'origine des erreurs. En ce qui concerne la première phrase, un rapport d'Amnesty International mentionne ces statistiques pour la Russie seulement : le chiffre mondial est donc encore pire ! En France en revanche, les seuls chiffres que j'ai trouvés sont les suivants :
- une femme meurt tous les deux jours des suites de violences conjugales, d'après des chiffres d'octobre 2006, alors qu'en 2004 on parlait d'une femme tous les quatre jours.
- une femme meurt tous les trois jours sous les coups de son compagnon, chiffre annoncé le 22 novembre 2006.
On est en tout cas bien loin d'une toutes les quatre heures (ce qui évidemment ne change rien à la gravité du problème). Et comme dirait un journaliste : "Euronews n'a pas souhaité commenter ces constatations" (traduction : je n'ai pas reçu de réponse au mail de demande de précisions sur ces chiffres envoyé à l'aide de leur interface de contact qui semblait légèrement buggée.)

De telles erreurs (j'avais déjà évoqué certaines approximations inquiétantes faites par la presse) mettent en cause la crédibilité des médias d'informations qui les véhiculent. Dans ce cas, pourquoi leur faire plus confiance qu'à notre blogueur préféré, qui, lui, a peut-être retenu de ses cours de physique qu'on vérifie toujours qu'un résultat numérique est plausible, et que l'unité est correcte.

Peut-être Gilles de Robien devrait-il inclure ces détails dans les programmes de mathématiques dès les petites classes, avec éventuellement aussi quelques rudiments de logique, afin d'éviter que nos jeunes élèves fassent des erreurs aussi grossières que leurs aînés journalistes, ou que ces chers américains qui confondent cents et dollars.

EDIT : tiens, une autre erreur d'unité à propos des violences faites aux femmes : "Une femme sur trois meurt sous les coups de son conjoint".

12 novembre 2006

Approximations et information

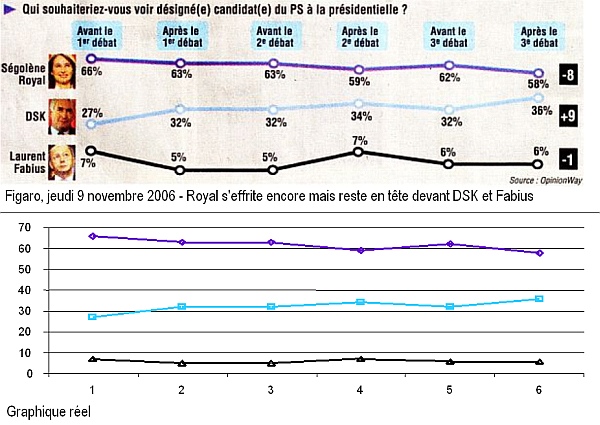
Je suis tombé sur un graphique intéressant dans un Figaro trouvé dans le train en rentrant d'Orléans : l'évolution des réponses des sympathisants socialistes à la question "Qui souhaiteriez-vous voir désigné(e) candidat(e) du PS à la présidentielle". Il accompagnait un article en première page intitulé "Royal s'effrite encore mais reste en tête devant DSK et Fabius". Sur le graphique en effet, on constate cet effritement, mais ce qui choque surtout c'est la remontée de popularité de Dominique Strauss-Kahn. Un examen des pourcentages montre que cette seconde impression est fausse : les trois courbes n'ont pas été mises sur la même échelle, mais dilatées (beaucoup pour Fabius, un peu moins pour DSK) et translatées, comme on peut le voir en comparant avec le vrai graphique pour ces valeurs :


On remarque aussi que le vrai graphique montrait bien la tendance d'effritement, et la remontée, visible mais toujours pas inquiétante pour les ségolistes, de DSK : ainsi il était tout à fait possible d'utiliser la visualisation des vraies valeurs plutôt que celle qui semble un peu truquée. Pourquoi le Figaro ne l'a pas fait et a préféré effectuer des changements qui donnent de fausses impressions ? Mystère.

Un autre exemple d'approximations qui m'amusent, celles qui font qu'un total arrive au dessus de 100%, c'est le cas par exemple de ce délicieux sandwich Poulet Tandoori de marque Leader Price avec 101% d'ingrédients, sans compter le soja, les crustacés et les poissons !


Dans ces cas-là il est vrai que ces bizarreries d'approximation sont tout à fait compréhensibles, j'arrive moins à m'expliquer en revanche pourquoi les gens en général et des journalistes en particulier prétendent qu'ils citent des phrases de façon exacte, en les déformant.

J'avais déjà évoqué les méfaits des copier-coller de dépêches d'agences de presse, eh bien là c'est un effet inverse. Notre exemple : une petite phrase de Ségolène Royal extraite de son intervention de janvier qui a agité la blogosphère cette semaine. Je m'étonne d'ailleurs que cette phrase n'ait pas fait plus réagir que le contenu général du discours. En effet, on a eu droit à un débat sur les 35h de présence des enseignants, sur le soutien gratuit, sur le fait que les propos avaient été coupés pour nuire à Ségolène Royale (la partie finale où justement elle explique que le soutien gratuit pour les élèves donnerait lieu à des compensations pour les professeurs). Bref, tout cela peut être débattu, on peut être pour ou contre. En revanche, si l'on prononce la question suivante "Donc comment se fait-il que des enseignants du secteur public aient le temps d'aller faire du soutien individualisé payant et ils n'ont pas le temps de faire du soutien individualisé gratuit dans les établissements scolaires ?", on émet incontestablement des suspicions sur le sérieux et la rigueur morale des enseignants. Travailler 35 heures par semaine laisse bien évidemment le temps d'effectuer d'autres activités rémunérées, sous les conditions fixées par la loi.

Des doutes formulés aussi clairement devraient être cités de façon exacte, mais ce n'est pas toujours le cas. Sur les blogs, on s'en doute, mais dans Le Monde non plus, qui négligemment remplace "des enseignants" par "les profs". On peut visualiser les différentes formes qui apparaissent sur le net grâce aux logiciels de bioinformatique qui font de l'alignement de séquences multiples, notamment GeneDoc qui est facile à installer sous Windows et à prendre en main pour obtenir le résultat suivant :


Les 7 versions de la phrase proviennent des sites suivants :
1 - Vidéo originale, Reuters, Nouvel Obs.
2 - Article du Monde
3 - Site de LCI
4 - Un blog
5 - Site Neteco
6 - ZeScoop
7 - Un forumeur sur le forum France 2

On peut alors donner à chaque mot de la phrase originale une taille proportionnelle à sa fréquence parmi les 6 variantes :


Et ceci nous permet de chercher toutes les variantes possibles sur les moteurs de recherche, en remarquant en particulier que les groupes de mots "le temps" et "faire du soutien" sont toujours conservés.

23 mai 2006

GoogleFight pour l'orthographe

C'est super utile, Google, comme correcteur d'orthographe. Mais attention à ne pas se laisser piéger !

D'accord, c'est pas la faute à Google mais plutôt à l'AFP, mais bon... En tout cas, mieux vaut utiliser GoogleFight que Google pour l'orthographe, il ne faut pas, par exemple, se laisser induire en erreur par les 34 400 000 résultats pour "seperate" et bien écrire "separate".