14 septembre 2010

Mathématiques des papillotes (2/2) Carambars

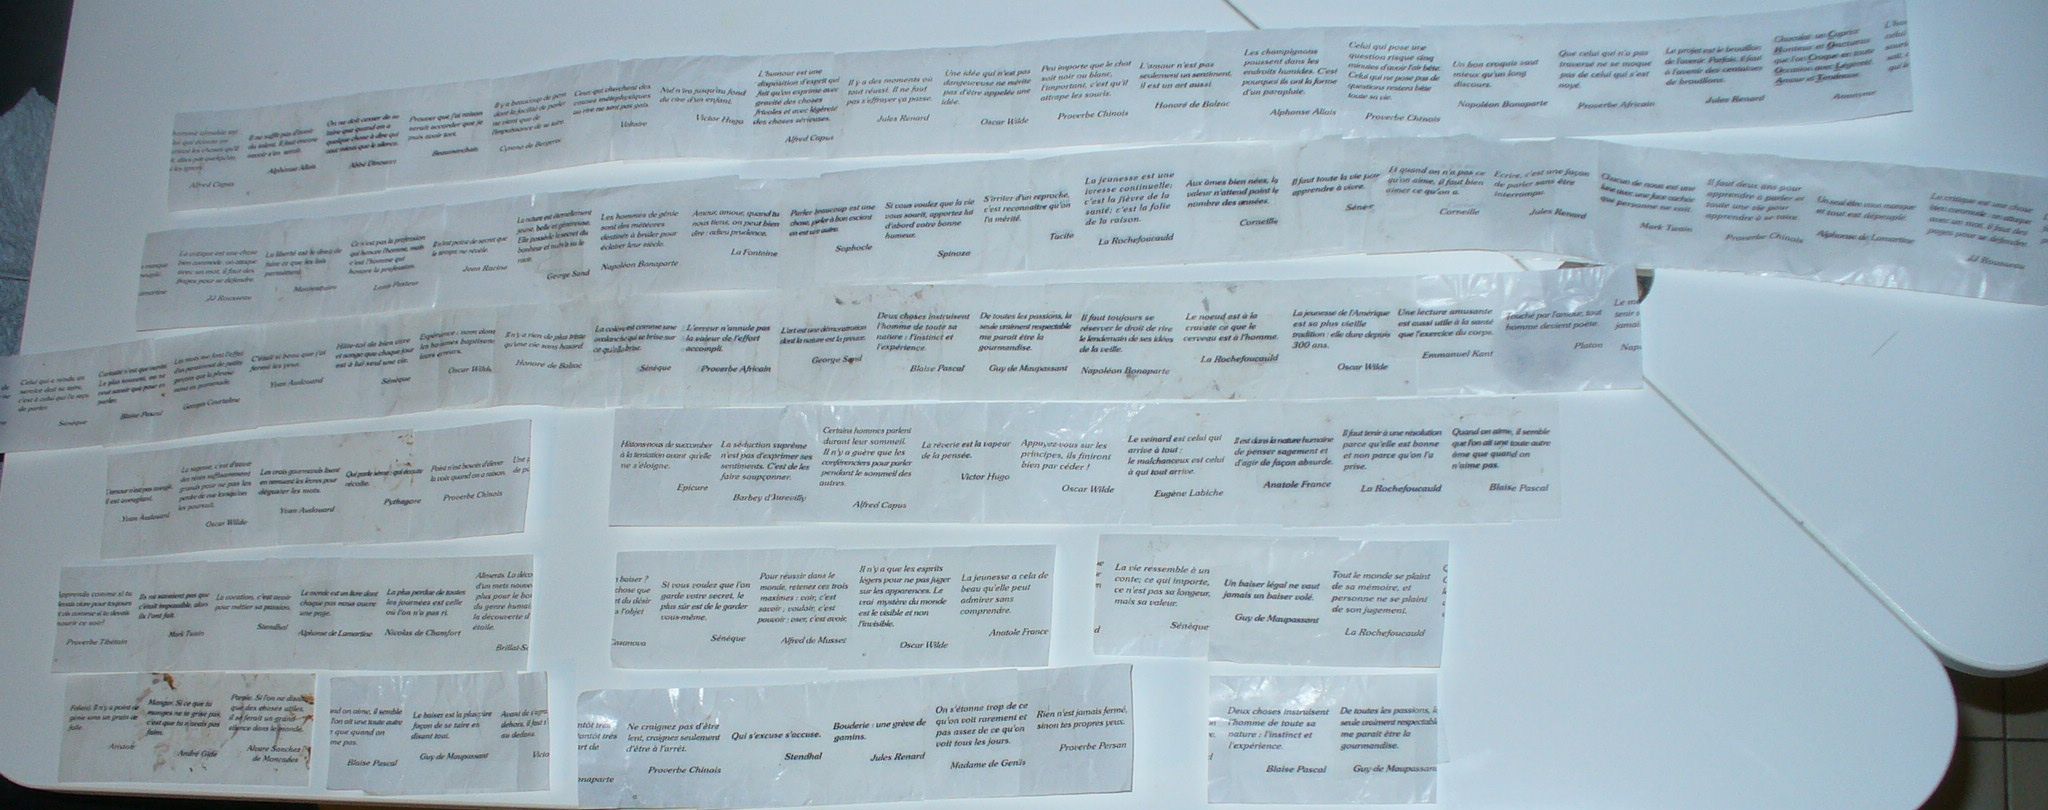
La question du nombre de blagues Carambar était restée sans réponse à la fin de l'épisode 1 de mon étude du nombre de citations de papillotes. El Jj s'y est collé sur son blog Choux romanesco, vache qui rit et intégrales curvilignes. De mon côté j'ai également fini de recueillir les blagues (séquences reconstituées ci-contre) de 3 paquets de Carambar qui traînaient depuis un an (j'en suis visiblement moins friand que des papillotes...), qui me permettent d'apporter quelques nouvelles précisions sur les obstacles à l'application de la "méthodologie-papillotes" à l'estimation du nombre de blagues Carambars, et de proposer des méthodes alternatives. J'avais évoqué ces deux problèmes, et El Jj mentionne également dans son billet, en les négligeant toutefois pour le calcul :
  • certaines blagues sont plus longues que d'autres
  • certaines blagues sont présentes avec des doublons, c'est-à-dire qu'elles apparaissent à plusieurs endroits dans la "chaîne de blagues" (entourées de blagues voisines différentes)
A cause de ces deux phénomènes, toutes les blagues ne sont pas équiprobables. Une remarque sur les données permet de se débarrasser du second problème : en regardant attentivement les emballages, on se rend compte que le recto coïncide toujours avec le verso. Je m'explique : si l'on tombe deux fois sur la même blague au recto, le verso, visible par transparence, est toujours calé au même niveau vertical... sauf quand la blague apparaît en doublon (avec un voisinage différent) ! Ainsi, si l'on trouve une blague en double avec un calage vertical différent pour les motifs au verso, on peut les considérer comme des blagues différentes lors du calcul. Ces doublons sont indiqués par les cadres de couleur dans le scan des séquences de blagues.

Quant aux autres méthodes d'estimation de tailles d'une population (de blagues), je les dois à Cécile qui m'a indiqué celle de la capture-recapture, aussi appelée mark-recapture en anglais (comme quoi une mi-temps d'Uruguay-Allemagne peut aussi être scientifiquement enrichissante). Elle est basée sur l'indice de Lincoln-Petersen, le second l'ayant utilisée en 1894 sur des poissons, et le premier en 1930 sur des oiseaux. Elle consiste à capturer M animaux, à les marquer puis à les relâcher. S'il y a un total de N animaux dans le périmètre choisi, et que chaque animal a la même probabilité d'être capturé, on a une probabilité de M/N de recapturer un animal marqué. Ainsi, si l'on effectue une seconde capture de n animaux, on s'attend à en obtenir nM/N marqués. En appelant m le nombre d'animaux marqués effectivement recapturés, on s'attend donc à avoir m=nM/N, et donc on estime le nombre total d'animaux à nM/m (indice de Lincoln-Petersen).

Appliquons la méthode sur les blagues Carambar, en prenant par exemple M=10. Mangez assez de Carambar pour trouver 10 blagues différentes. Mangez alors n Carambars et comptez ceux dont la blague associée faisait partie des 10 choisies au départ. Vous vous attendez à obtenir m=nx10/N, et donc le nombre estimé de blagues différentes est 10n/m.

Ce cours sur la biodiversité évoque également, page 6, une estimation du nombre d'espèces par une détermination graphique de l'asymptote de la courbe qui indique le nombre total d'espèces observées en fonction du temps d'observation. L'avantage est que pour cette méthode il n'y a pas besoin de faire d'hypothèse sur l'équiprobabilité d'observer chaque espèce, contrairement à celles présentées précédemment. Toutefois elle semble peu précise, et très dépendante du modèle de régression choisi. Quant à l'application aux Carambars, il suffit de l'utiliser sur la courbe du nombre total de blagues trouvées en fonction du nombre de Carambars mangés (en rouge sur la diapo 17 ici).

Vous voilà prêts à faire vos estimations avec ces méthodes, en évaluer la fiabilité (m'indiquer de la littérature sur le sujet ?), ou en proposer d'autres... A vous de jouer !


Le billet d'El Jj : ¡ Ay, Carambar !
Le premier billet de la série : Mathématiques des papillotes (1/2)
Un article du Monde suite à la blague du retrait des blagues Carambar : Nos petites madeleines

31 août 2010

Nuages arborés en ligne

Vous avez vu le concept apparaître sur le blog de Jean, et quelques exemples sur ce blog, mais ça fait quelque temps que je n'en ai pas parlé ici, des nuages arborés de mots. Après quelques semaines de test d'une interface web de construction de ces outils de visualisation, il est temps de dévoiler le nouveau site web de TreeCloud : treecloud.org !


Grâce à Jean-Charles, étudiant en licence d'informatique à la Faculté des Sciences de l'Université de Montpellier 2, qui a programmé tout ça sur son temps libre, cette méthode de visualisation qui n'était alors disponible que sous forme d'un logiciel libre un peu contraignant à installer (il y a encore des problèmes sous Mac pour cette version en développement référencée par le Projet Plume), est maintenant offerte sous forme d'une interface web que vous pouvez installer sur votre site web, sous le nom NuageArboré. Ce que j'ai fait pour treecloud.org, après des petites modifications pour adapter les paramètres par défaut, et voilà le tout prêt à utiliser en un clic !

Alors quelle utilité pour ces nuages de mots grimpés aux arbres ? Simple aperçus esthétiques du contenu d'un texte ? Eh bien pas seulement, comme nous l'avons montré avec Delphine, ma co-autrice dans notre article présenté en juin aux JADT 2010 à Rome. C'est maintenant dans la foire aux questions de TreeCloud, ces visualisations peuvent également servir à analyser des textes dans le cadre d'une démarche assistée par ordinateur :
  • en suscitant, en formalisant et en étayant des hypothèses de travail,
  • en comparant des textes selon leur représentation arborée,
  • en hiérarchisant l'utilisation d'autres outils textométriques,
  • en représentant les résultats de l'analyse.
Je vous laisse lire notre article ou découvrir notre présentation aux JADT pour en savoir plus.


Et maintenant, à vous de jouer, pour trouver d'autres usages ! Contactez-moi si ça vous donne des idées, ou suscite des questions. En tout cas ces nouvelles visualisations sous forme de nuages de mots sont à la mode, et des chercheurs d'IBM et de Microsoft qui ont évoqué les nuages arborés dans des articles à InfoVis l'an dernier et cette année planchent sur de nouvelles améliorations et de nouveaux usages des nuages de mots.

Je terminerai en remerciant le projet ANR PhylAriane qui a financé la présentation des travaux sur les nuages arborés à IFCS l'an dernier et aux JADT cette année. En effet, cet outil de visualisation construit grâce à des méthodes issues de la bioinformatique, conçu pour des problématiques de sciences humaines, va bientôt trouver des applications en bioinformatique. Plus de détails à venir, dans un certain Chapitre 4...

30 juin 2010

Densité des idées

La rencontre de doctorants Osidmesh (évoquée précédemment sur ce blog) a débouché sur un joli projet qui a déjà donné ses premiers résultats, que mes coautrices vont présenter cette semaine et le mois prochain. Petit coup de projecteur, donc, sur ces travaux liés à la thèse d'Hyeran sur le langage des malades d'Alzheimer.

En octobre dernier, elle m'avait parlé du logiciel CPIDR qui permet d'estimer, pour un texte en anglais, sa "densité des idées". Le concept de ce score linguistique, qui correspond au nombre d'idées exprimées en 10 mots, nous vient de la psycholinguistique. La densité des idées représente une certaine qualité informative des phrases d'un texte, et les psycholinguistes soupçonnent que sa dégradation est liée à un déclin de l'activité cognitive. Ainsi, Hyeran cherchait à vérifier que les malades d'Alzheimer avaient généralement une densité des idées inférieure aux personnes non atteintes, première étape avant d'utiliser ce critère pour des applications plus poussées comme le diagnostic de la maladie, ou l'analyse précise des dégradations de la capacité langagière en vue de proposer des exercices de rééducation adaptés.

Nous avons donc réutilisé la méthode du logiciel CPIDR pour le calcul de la densité des idées d'un texte : on détermine la nature grammaticale de tous les mots (par exemple de façon automatique avec TreeTagger), et on utilise cette information comme base pour déterminer si le mot peut être considéré comme représentant une idée ou non. En fait, les mots comptant pour une idée sont principalement les verbes, les adverbes et adjectifs, ainsi que les prépositions et conjonctions. Des règles linguistiques permettent d'ajuster ce principe de base et de traiter certains cas particuliers, éventuellement spécifiques au discours oral.

Nous avons donc codé dans un logiciel libre en Python, Densidées, ce principe de base et quelques premières règles grammaticales, qui nous ont permis d'obtenir assez rapidement une approximation intéressante des valeurs de densité des idées trouvées manuellement. Et par un prompt renfort de deux étudiantes lyonnaises en orthophonie, Constance et Elsa, un joli corpus étiqueté manuellement (le rêve de tout TALeux !) a été constitué, permettant d'améliorer le logiciel en comparant les résultats de l'analyse automatique et manuelle, pour trouver les nouvelles règles à ajouter pour réduire le taux d'erreur. Nous arrivons finalement à de très bons résultats, comme détaillé dans cet article à RECITAL 2010 et montré dans le graphique de corrélation entre analyse manuelle et automatique ci-contre.

Deuxième étape, vérifier que la densité des idées, en particulier celle calculée par Densidées, est effectivement plus faible chez les malades d'Alzheimer. Les résultats du mémoire d'Elsa et Constance pour un groupe de 22 personnes (dont 11 malades), sont confirmés dans notre poster à CEDIL 2010 pour un groupe de 40 personnes.

Hyeran va poursuivre la constitution de son corpus, et elle a d'autres pistes de critères linguistiques pouvant jouer le rôle d'indices de la maladie d'Alzheimer, mais la partie de son travail à laquelle j'ai eu la chance de participer a précisé de manière très concrète l'image que j'esquissais dans le billet précédent de recherches en sciences humaines d'une grande qualité malgré la faiblesse, ou l'absence, des financements. La motivation et le travail d'une doctorante, en lien avec une équipe d'étudiantes énergiques et passionnées, et un bon encadrement de thèse, sont visiblement des clés pour compenser la faiblesse des moyens pour la recherche en sciences humaines. Mais jusqu'à quand si les financements n'arrivent pas à la suite des bons résultats obtenus ? Le minimum vital est de pouvoir les présenter, afin de recueillir l'avis et les suggestions de la communauté scientifique. Pour l'article de RECITAL (à Montréal cette année avec TALN), nous remercions le laboratoire Praxiling et l'école doctorale 58, ainsi que l'ATALA et l'école doctorale I2S pour leur soutien financier.

A très vite pour évoquer un autre logiciel libre et une autre collaboration à l'interface avec les sciences humaines...

31 mai 2010

Graphe orienté et politique : le cercle vertueux

Les graphes apparaissent rarement sur ce blog, alors qu'ils constituent l'une de mes thématiques de recherche. Une utilisation dans le cadre du débat politique me donne l'occasion d'en parler aujourd'hui.


Combats de chiffres parfois, d'égos souvent, de mots toujours, les débats politiques s'enlisent bien souvent sans faire apparaître clairement le fond du problème, sorte de plus petit commun désaccord. Des outils informatiques de brainstorming et de web-débat commencent à voir le jour pour structurer les discussions et les confrontations. Mais ceux que je connaissais ne me satisfaisaient pas au moment où nous avons commencé avec d'autres doctorants des universités montpelliéraines à débattre sur la future charte des thèses.

Un peu d'éléments de contexte avant d'aborder l'outil proposé. La charte des thèses existe dans les établissements d'enseignement supérieur pour donner un cadre à la préparation du doctorat. Ces chartes détaillent de façon plus ou moins poussée les droits et devoir des doctorants, de leurs encadrants, et des structures liées au doctorat. Selon les universités et les domaines de recherche, elles assurent aux doctorants un statut clair de professionnel de la recherche recruté sur un projet précis (en affirmant par exemple que tout doctorant doit être rémunéré) ou bien restent plus vagues, pour diverses raisons. Raisons historiques, contextuelles, et scientifiques se mélangent bien souvent dans les explications, il est difficile de faire le tri. Face à cette confusion, la Confédération des Jeunes Chercheurs tient un discours clair, argumenté et documenté sur le sujet.

J'ai donc essayé de regrouper l'ensemble de ces arguments dans une synthèse qui ferait apparaître la cohérence d'ensemble de ce discours, et permettrait rapidement de mettre le doigt sur les points de désaccord. Les arguments étant souvent liés les uns les autres, il semblait apparaître une sorte de cercle vertueux, et c'est cet aspect que j'ai essayé de mettre en valeur dans un graphe orienté (un ensemble de points reliés par des flèches), à l'occasion d'une pause MacDo par un sombre dimanche d'hiver. Les flèches s'interprètent comme des implications logiques, mais comme tout modèle mathématique, il s'agit d'une simplification de la réalité, où les flèches doivent plutôt être interprétées comme "conduisent à" ou "favorisent".

Il fallait ensuite passer de l'ébauche sur carnet Moleskine au document clair et utilisable, ça a été fait grâce à l'outil de dessin de Google Docs (afin de laisser la possibilité à d'autres participants de notre groupe de réflexion de modifier la figure), et aux conseils esthétiques de Paola et Alban pour mieux faire ressortir le cercle vertueux, et faire apparaître la charte des thèses, et ses effets sur le cercle, en position centrale :


Etape suivante, rendre la figure entièrement cliquable pour expliquer les flèches et les cases dans une interface très navigable. L'outil de création de maps HTML d'OpenOffice a permis de faire ça très rapidement, le résultat se trouve ici.

Résultat sur les discussions et le débat ? On y gagne une vision d'ensemble assez claire : ce cercle fonctionne bien actuellement pour les doctorants en sciences exactes, en revanche c'est moins le cas pour les doctorants en sciences humaines. La clé du débat est alors de savoir comment l'amorcer : en imposant de nouvelles contraintes sur les doctorants (obligation de financement pour s'inscrire en thèse, durée limitée de façon stricte à 3 ans), ou bien en améliorant les conditions d'encadrement et de travail en équipe ? La réponse est vite trouvée, et correspond à l'évolution en cours dans les écoles doctorales montpelliéraines en sciences humaines : EDEG, 58 et 60. Pour Droit et sciences sociales, le chemin à parcourir semble plus important...

C'est justement dans cette école doctorale qu'on nous dit que le "cercle vertueux" est inadapté, en ciblant les cases et les flèches qui ne sont pas correctes. L'insertion professionnelle dans le privé aurait peu de lien avec le bon déroulement de la thèse, en droit, et serait même à l'origine d'un grand nombre d'abandons de thèse. De plus, le rapport personnel et subjectif du doctorant à son sujet de thèse et aux textes de sa bibliographie, ainsi que la maturation de la réflexion nécessaire à produire un résultat de recherche intéressant, seraient à l'origine d'une impossibilité de borner une thèse à une durée maximale de trois ans. Là, toute la question est de savoir s'il s'agit d'un principe qui fait consensus en droit voire dans d'autres domaines scientifiques (philosophie ? littérature ?), ou si elle concerne seulement certains sujets de thèse exceptionnels qui demandent des durées adaptées en conséquence... auquel cas une simple exception à la règle, bien encadrée dans la charte des thèses, suffirait.

Verdict attendu suite aux discussions dans les écoles doctorales et les conseils scientifiques... En tout cas la phase de réflexion des doctorants est en train d'aboutir, grâce à une consultation de l'ensemble des doctorants montpelliérains, et ce graphe orienté aura contribué à faciliter le débat et sa synthèse.

20 avril 2010

Sous-titrage xkcd : 100% !

J'ai eu le plaisir de valider ce matin la 729ème traduction en français d'une vignette xkcd, qui a permis d'atteindre les 100% dans la petite barre de progression d'xkcd.free.fr !

En à peine moins de 500 jours, avec un total de 100 participants (dont les 20 plus actifs ont réalisé 90% des traductions), toutes les vignettes de xkcd ont été sous-titrées en français. Merci donc à useless, Djool, Antoine, justt, Manutaust, I5, pascal, Zuiter, Kith, Yun-Kang, PH TRIVIER, Jmfork, Mutte, Lolouf, François, Quark, Arnaud R, Eniotna, Anouck, Anonyme, Di@bl@l, Nicomm, Tejgad, Malta, relaurelius, Nitrec, LS, cwoodin, Romain, Lagierl, anonyme, Iain, Pierre Ligot, brazzmonkey, Jules.LT, Xavier, Phersv, Kasui, Oaz, iuchiban, GG, neurone, Christophe, Alice, Carrot, Le pti yo, Fanch, crox, Romu, Takhiarel, Sioc, CaptainDangeax, egogramme, azerwhite, ianux, Thieums, Yves, Alexis, P., Nightgeek, DVLish, DenisQC, Bab, Niaatan, J. Ruaud, irqy, Cynoid, Baudelaire, Bernard Tribot, PL, wed, cerca, Wen, Philippe MacKay, Yves Roumazeilles, Arnaud, Johngeek, medard, AmideLanval, Delphine, Padreik, RJL, Egogramme, Guilac, seb, Ozh, oDn, Aelfgar, Nic, Em, Christophe Thill, Fractal, raph, dgryski, Ha3, Christophe S., mrlargo, Krom et kercoz.


Le graphique ci-dessous montre l'évolution de la traduction. J'ai indiqué pour les 14 plus gros contributeurs le moment où ils avaient particulièrement participé :

Je précise tout de même que ce graphique n'indique pas la difficulté de la contribution. En participant dès le début, j'ai pu traiter les plus simples et donc participer sur une grosse quantité. Au contraire, ceux arrivés plus récemment ont eu le courage de s'attaquer à quelques gros morceaux (je pense par exemple à Nicomm pour le 24, Manutaust pour la Blogofractale, ou encore brazzmonkey pour le 472).

Merci également à ceux qui ont fait connaître ce projet, en particulier Astrid Girardeau dont l'article dans Libération/Ecrans a bien augmenté le nombre de visiteurs, ou encore MacGeneration et CommentCaMarche.

Le projet peut maintenant passer dans une autre phase. Outre bien sûr la traduction au jour le jour, il faut désormais améliorer les traductions existantes (j'ai un gros mois de retard sur la modération de ces améliorations), et passer de cette version sous-titrée à une version "en VF", traduite directement sur l'image. Heureusement, Phiip a commencé ce travail sur xkcd.lapin.org de façon indépendante il y a quelques semaines, il avance vite et bien, et pourra utiliser ou améliorer les traductions d'xkcd.free.fr.

Deux flux RSS à ajouter donc : celui d'xkcd.free.fr pour continuer à recevoir les textes des traductions le jour de leur sortie, et celui d'xkcd.lapin.org pour recevoir les images au fur et à mesure de leur traduction !

Encore une fois bravo et merci à tous, l'aboutissement (relatif) de ce projet d'équipe constitue une excellente motivation pour en terminer un autre, qui m'occupe depuis près de 3 ans... Et bon courage pour les traducteurs allemands (145/729), espagnols (204/729) et russes (422/729) !

Episodes précédents : traduction d'xkcd et loi de Pareto (31 mars 2009), xkcd en français (13 décembre 2008)

31 mars 2010

Comment translater les titres de films (2)

J'avais proposé dans un billet précédent une petite typologie de la traduction des titres de films, et je vois ressortir ce sujet un peu partout, en particulier au début du mois dans un article de Julien Jouanneau pour Le Post. Il y notait en particulier une utilisation assez importante du mot "enfer" dans les traductions de titres anglais et américains.

Dès 2007, je m'étais lancé dans la récupération d'un corpus de titres et leur étiquetage selon cette typologie. Il est temps de mettre à disposition mes données et mes premiers résultats, même si leur quantité et leur qualité est améliorable, je pense qu'il y a des choses intéressantes à en tirer.

Quelques infos sur ces données pour commencer (n'hésitez pas à me demander le droit d'édition du fichier en commentaires si vous voulez participer à l'étiquetage !). Elles ont été récupérées automatiquement sur le site Allociné, ce qui est à l'origine de quelques erreurs sur la date de sortie : celle mentionnée est la date de dernière sortie cinéma en France, ce qui peut être une date de reprise. J'ai donc le projet de corriger cela un de ces jours...

Les films ont alors été étiquetés de la manière suivante :
- F pour un titre français,
- O pour un titre anglais gardé en français,
- D pour une traduction littérale de l'anglais,
- T pour une traduction un peu plus subtile voire complètement différente,
- A pour une traduction "fashion", de l'anglais vers autre chose en anglais,
- N pour une traduction "note du traducteur", où le titre anglais est gardé mais complété par des mots en français,
- C pour une traduction "censure", où le titre anglais est tronqué,
- S pour une traduction "sans the", où le titre anglais est gardé mais en enlevant le premier "the" (Da Vinci Code, Last Kiss, etc.).
- la lettre ci-dessus doublée quand il s'agit du même phénomène avec une autre langue que l'anglais.

Bref, j'arrive à une base étiquetée de plus de 1600 titres traduits de films dont la dernière sortie a eu lieu dans les années 1967-1974, 1982-1984, 1994, ou 2002-2006 : vous devinez que j'ai recherché des évolutions dans les habitudes de traduction... Et effectivement il semble avoir des variations, avec de plus en plus de titres gardés sous leur forme originale et de moins en moins de traductions littérales, et peut-être également un engouement ces dernières années pour les traductions "fashion" et "sans the". A confirmer quand la qualité et la quantité des données sera améliorée bien sûr.

Pour voir si d'autres mots comme "enfer" étaient particulièrement choisis dans les traductions subtiles, on peut extraire toutes les traductions subtiles d'une part (549 dans la colonne F), toutes les traductions littérales d'autre part (283 dans la colonne G), et comparer le vocabulaire qu'elles utilisent.

J'extrais donc la liste des mots les plus fréquents dans chacune de ces deux catégories avec Dico, puis je les compare en les explorant avec un multinuage de mots (les tailles des mots en bleu reflètent le nombre d'occurrences dans le corpus des traductions littérales, en rouge dans celui des traductions subtiles) :
Attention toutefois un corpus a une taille deux fois plus importante que l'autre, il faut donc visualiser les fréquences, avec Lexico3 par exemple, voici les mots du nuage avec les différences de fréquences les plus significatives :


Le mot "roi" est donc moins utilisé dans les traductions subtiles, alors que "mort", "enfer", "affaire" et "secret" y sont plus souvent employés. Attention toutefois : si l'on calcule les spécificités avec Lexico3, aucun de ces mots n'apparaît comme statistiquement sur-représenté dans un des deux corpus. Le fait qu'"enfer" ne soit pas présent dans les traductions littérales et 6 fois dans les traductions subtiles peut donc être dû au hasard. Plus de données permettra peut-être de conclure... avis aux amateurs qui voudraient participer à l'étiquetage du reste de la base !

En tout cas voilà les titres à traduction subtile contenant le mot "mort" : Side Street (La rue de la mort), I'll Sleep When I'm Dead (Seule la mort peut m'arrêter), The Bourne Supremacy (La mort dans la peau), Touching the Void (La mort suspendue), Kiss of Death (Le carrefour de la mort), Double Indemnity (Assurance sur la mort), Stepping Razor - Red X (La vie et la mort de Peter Tosh), Battletruck (Le camion de la mort), Still of the Night (La mort aux enchères).

D'ailleurs, le mot avait bien été gardé pour la traduction officielle du titre du film Deathproof de Tarantino. A sa sortie, TFM Distribution avait lancé un concours de traduction, je ne sais pas quel titre avait finalement gagné, mais le titre officiel "Boulevard de la mort" fait bien apparaître ce fameux mot-clé, et a apparemment conquis Tarantino, même s'il a fait causer des dizaines de cinéphiles.

24 février 2010

Miss Google 2010

Avez-vous déjà invité une brésilienne à votre soirée d'anniversaire ? Paola me raconte que ça suffit à obséder certains jeunes hommes que j'imagine charmés par les sonorités de l'accent brésilien ou de la langue portugaise. A moins que la brésilienne ait un statut particulier dans l'imaginaire collectif français...

C'est l'hypothèse que j'ai testée en allant récupérer le nombre de réponses Google de "belle brésilienne", "jolie brésilienne", et en faisant de même pour un total de 152 nationalités. Je suis fan de ce genre de tests, tout comme xkcd. Et mon petit FuryPopularity fonctionne toujours aussi bien pour effectuer des requêtes Google en masse (contrairement aux requêtes Yahoo, qui a encore changé d'apparence récemment)... en imposant un délai d'une vingtaine de secondes entre deux requêtes, pour éviter d'être détecté comme robot (il y a quelques mois 8 secondes suffisaient, argh).

Les résultats sont dans ce document tableur partagé.

Top 10 des belles : françaises, japonaises, marocaines, brésiliennes, chinoises, roumaines, mexicaines, allemandes, italiennes, américaines.
Top 10 des jolies : françaises, thaïlandaises, russes, indiennes, anglaises, italiennes, américaines, brésiliennes, espagnoles, allemandes.

Première remarque en se penchant un peu plus sur les résultats chiffrés : en les passant au logarithme on obtient une droite, excepté une irrégularité pour les nombres de résultats compris entre 10 et 40. Je ne serais pas étonné que ce soit le palier au delà duquel Google ne fournit pas les nombres exacts de résultats, mais seulement des approximations. En revanche je suis un peu étonné de ne pas tomber sur une loi de puissance comme ça a si souvent été le cas sur ce blog.

Deuxième remarque, il y a une forte corrélation entre les résultats pour "belle" et ceux pour "jolie" (coefficient de corrélation 0.88), qui tendrait à indiquer qu'effectivement ces résultats correspondent à une tendance commune, et qu'on pourrait donc les interpréter comme un inconscient collectif (ou médiatique ?) d'association de la beauté féminine avec certaines nationalités.

Mais j'entends déjà poindre les premières critiques : belles françaises, italiennes, allemandes et américaines... Google Images nous confirme qu'on ne parle pas là que des habitantes de ces pays, mais aussi de leurs voitures. Les allemands ont semble-t-il un peu moins tendance à personnifier leurs voitures (encore que, les motos peut-être un peu), j'ai donc également lancé l'expérience également avec "schöne" et "hübsche", avec les gentilés allemands trouvés ici.

Les résultats sont différents, mais tout de même un peu corrélés aux français (0.72 et 0.75). Voilà le top 10 pour "schön" : sud-africaines, russes, allemandes, italiennes, suédoises, danoises, françaises, indiennes, polonaises, autrichiennes ; et pour "hübsch" : japonaises, brésiliennes, allemandes, polonaises, françaises, chinoises, suédoises, italiennes, américaines, norvégiennes. Avec toujours une bonne corrélation entre les deux listes de résultats (0.86).

Vous remarquez le point à droite, très "schön" mais moyennement "hübsch" ? Il s'agit de l'Afrique du Sud, représentée, pour les allemands, par Charlize Théron qui truste les résultats de la requête. Elle me permet de remarquer une fois de plus combien les nombres de résultats Google sont variables du jour au lendemain, car il y a aujourd'hui beaucoup moins de résultats qu'hier soir quand j'ai récupéré les données.

N'hésitez pas à réutiliser le protocole pour obtenir des résultats plus solides (en réitérant les requêtes sur plusieurs jours pour éviter les résultats fantaisistes parfois fournis par Google), ou bien dans d'autres langues, ou sur les hommes plutôt que les femmes. Et peut-être, en testant assez de langues, pourrez-vous trouver le pays où français et française sont les mieux cotés ! Ou bien tout cela vous donnera envie de voyager un peu dans les pays du milieu et du bas du classement pour constater l'absurdité de ces stéréotypes.

31 janvier 2010

Prénom et profession

Ca fait un certain temps que traînent sur mon ordinateur les données des prénoms et professions de plus de 100 000 signataires d'une pétition que j'évoquais dans des billets précédents. Alors que je me suis récemment plongé dans la passionnante Initiation aux méthodes de la statistique linguistique de Charles Muller (sur un conseil avisé) pour un autre projet dont je parlerai bientôt ici, j'en profite pour appliquer ce que je viens d'y apprendre sur les écarts réduits. Les commentaires de vrais statisticiens sont les bienvenus...


J'ai donc à disposition un tableau de 294 prénoms qui apparaissent plus de 40 fois chacun parmi les signataires, et pour chacun la répartition en 15 professions (étudiant, informaticien, ingénieur, employé, chercheur, auteur, cadre, enseignant, lycéen, retraité, profession, libérale, chômeur, fonctionnaire, bibliothécaire, journaliste). J'aimerais alors pour chaque profession savoir quels prénoms sont sous-représentés et sur-représentés. Une première approche consisterait à calculer simplement le pourcentage de représentation de chaque prénom. Par exemple, sur 1304 Philippe, il y a 33 étudiants (soit 2,5%), alors que sur 103312 signataires, il y a 14881 étudiants (soit 14,4%). Ainsi, parmi les Philippe, les étudiants seraient sous-représentés ?

Malheureusement, ce raisonnement ne conduit qu'à une intuition et n'est pas encore confirmé statistiquement. Pour évaluer si cette sous-représentation est statistiquement significative, il faut calculer les écarts réduits, et pour cela abandonner les pourcentages pour revenir aux valeurs théoriques et valeurs observées. Comme il y a 14881 étudiants, 1304 Philippe et un total de 103312 personnes, le nombre théorique d'étudiants qui s'appellent Philippe est 14881/103312*1304 = 188 (environ). Le critère pour évaluer si cet écart absolu de -155 (=33-188) est bien significatif s'appelle l'écart réduit, il consiste à diviser l'écart absolu par l'écart-type.

Là, j'ai cru comprendre qu'on prend l'hypothèse d'une loi normale pour calculer l'écart-type théorique comme la racine du nombre d'individus considérés (de Philippe, soit 1304) multiplié par la probabilité qu'ils soient étudiants (soit p=14881/103312=0,144) multiplié par la probabilité qu'ils ne le soient pas (1-0,144=0,856). Pour l'instant tout ça m'a l'air un peu magique, mais ça semble avoir un rapport avec le théorème de Moivre-Laplace (qui demande que n soit suffisamment grand, d'où ma restriction initiale à des prénoms représentés plus de 40 fois, j'espère que c'est suffisant).

Enfin bref, on trouve donc un écart réduit de -12,21 ce qui est statistiquement significatif, car la probabilité qu'un tirage au hasard (d'étudiants tirés à probabilité 0,144 avec 1304 tirages) conduise à un tel écart type est tellement faible qu'elle n'est même pas dans la table de référence des écarts réduits du bouquin de Muller page 175 (qui s'arrête à un écart réduit de 4,5 qui est atteint ou dépassé avec proba 0,000006. Cette opération peut être répétée pour tous les prénoms et conduit à ce fichier tableur OpenOffice (les écarts réduits sont sur la feuille 2, si vous avez la chance de trouver votre prénom parmi les 294 sélectionnés...), et en particulier cet histogramme des écarts réduits pour Philippe (on considère que les écarts réduits sont significatifs en dessous de -2 et au-dessus de 2) :
On peut aussi faire un Top 10 des prénoms significativement sur-représentés dans diverses professions, en appliquant des calculs similaires (en feuille 3 du document tableur). Je les dispose ci-dessous sous forme de nuages construits avec TagCloudBuilder (il y a visiblement encore des progrès à faire vis à vis de la parité, regardez les nuages des ingénieurs, chercheurs, cadres, et employés... Notez aussi les excès de Jean-Quelquechose chez les ingénieurs et les cadres.).
Etudiants :
Informaticiens :
Ingénieurs :
Employés :
Chercheurs :
Cadres :
Enseignants:
Lycéens :
Retraités :
Professions libérales :
Chômeurs :
Fonctionnaires :
Bibliothécaires :
Journalistes :
A vous de les utiliser pour nommer vos enfants (je sens que je vais me reconvertir en consultant en prénoms). Toutefois, pas de chance, vous noterez qu'aucun prénom n'est significativement sous-représenté dans le groupe des chômeurs...

Edit du 2 février : pour amoindrir l'effet de l'âge, Vincent me propose de refaire les calculs en enlevant des données les étudiants, lycées et retraités. Résultats ce soir ou demain soir... Mise à jour du 4 février : en fait ça méritera un billet séparé un peu plus long, car ces nouveaux résultats m'inspirent de nouvelles hypothèses et tests, pour les impatients les nouveaux nuages se trouvent ici et les données là...

Des lectures sur le même thème :

29 novembre 2009

Mathématiques des papillotes (1/2)

A l'approche des fêtes de fin d'année, c'est l'occasion pour moi de vous parler d'un problème qui m'obsède depuis le collège, et que j'ai enfin résolu, celui de l'estimation du nombre de citations de papillotes (oui, oui, trois compléments du nom successifs, c'est moche).

Alors je ne parle pas des papillotes en tissu de Linette ou de celles brodées par Brodstitch pour les fêtes, encore moins de la meilleure façon de préparer le poisson, mais de cette délicieuse friandise en chocolat enrobée d'un petit papier contenant blague ou citation, le tout dans un papier extérieur brillant. Ce concept (associé en plus à la charmante légende du sieur Papillot et de son apprenti chocolatier) m'a toujours passionné, et je lis toujours la citation avec autant d'attention que je mastique le chocolat (je ne suis visiblement pas le seul dans ce cas). Et c'est assez frustrant de retomber sur une citation déjà lue quelques papillotes plus tôt. Voilà pourquoi j'ai commencé à enquêter sur le nombre total de citations de papillotes différentes, pour celles de la marque Révillon (traditionnelle dans ma famille au moment des fêtes, vous comprendrez pourquoi en comparant avec d'autres... et non, ce billet n'est pas sponsorisé :p).

C'est comme ça que depuis le collège, chaque année, j'essaie plus ou moins de garder les citations de papillotes au moment des fêtes, pour résoudre ce problème, avec les moyens du bord. Alors comme sur un papier, on arrive à lire deux citations (au moins partiellement), après avoir remarqué que deux citations qui se suivaient dans un papier étaient systématiquement consécutives, j'ai commencé par les scotcher pour espérer reconstruire un jour la séquence intégrale des citations. Au gré des déménagements, ces données ont été perdues, retrouvées, et une année j'ai constaté avec horreur que la consécutivité d'une année précédente n'était plus respectée : la liste de citations avait changé et tout le travail était à refaire !

En licence, devant quelques éléments de proba, je me suis dit qu'il serait certainement possible d'estimer mathématiquement la probabilité de trouver plusieurs fois une même citation en tirant un certain nombre de papillotes, et que ceci me permettrait certainement d'évaluer le nombre total de papillotes en comparant la probabilité théorique et celle trouvée en pratique. C'est seulement l'an dernier que j'ai trouvé une meilleure façon de formuler le problème en terme de probabilités, et j'ai pu finir les calculs cette année. C'est cette approche que je vais maintenant présenter (qui pourrait donner un sympathique exo de khôlle de math sup), j'évoquerai aussi une approche statistique qui donne les mêmes résultats. Pour mes lecteurs qui veulent éviter l'indigestion mais sont intéressés par le résultat de cette enquête mathématique, n'hésitez pas à sauter les paragraphes plus formels pour aller à la réponse en fin de billet, juste après l'image de la courbe.

L'idée consiste à évaluer la probabilité Pd,k(n) de tirer d citations différentes, parmi un total de n citations, au bout de k tirages de citations (en supposant que le tirage de chaque citation a la même probabilité). Par la dégustation de papillotes, on obtient un échantillon de citations où on connaît d et k, et la stratégie va consister à trouver la valeur de n qui maximise Pd,k(n) . Il faut donc calculer trouver une expression de cette valeur, que l'on peut exprimer en terme de mots dans un alphabet. En considérant chaque papillote comme une lettre, et chaque tirage de k papillotes comme un mot de k lettres, la probabilité Pd,k(n) est égale au nombre ad,k(n) de mots de k lettres contenant d lettres différentes divisé par le nombre de mots de k lettres (les lettres étant choisies dans un alphabet de n lettres), c'est à dire nk.

J'ai un peu bloqué sur le calcul de ad,k(n) : on peut le définir de manière récursive, ce qui permet de faire les calculs pour des valeurs assez petites de n, je le détaille dans ce document, mais une remarque de Gergely m'a permis de faire les calculs de manière plus élégante. Ce nombre ad,k(n) peut en effet s'exprimer uniquement en fonction de ad,k(d) : puisque le mot a d lettres différentes, on peut en effet se restreindre à un alphabet de d lettres, en multipliant le résultat par le nombre de projections possibles de ces d lettres sur les n lettres de l'alphabet original (un exemple pour comprendre ça est donné en slide 9 de ce diaporama). Ainsi :
ad,k(k)=ad,k(d).Cnd

Et là, magie, comme on cherche uniquement à trouver le maximum par rapport à n et que ad,k(d) ne dépend pas de n (si vous voulez savoir comment calculer ad,k(d), allez voir par là) :
maxn (Pd,k(n)) = maxn (ad,k(n) / nk) = maxn (Cnd / nk)

Gilles m'a expliqué comment modéliser le problème par une approche statistique, en considérant que le tirage suit une loi multinomiale, et en considérant comme statistique de l'échantillon le n-uplet donnant pour chaque citation son nombre de tirages. Le calcul d'un estimateur de maximum de vraisemblance pour la valeur de n fournit le même résultat, mais cette approche permettrait d'aller plus loin en calculant non seulement une valeur ponctuelle du maximum de vraisemblance mais également un intervalle de confiance. Je ne me suis toutefois pas encore plongé assez longtemps dans le Fourgeaud & Fuchs pour comprendre comment procéder.

Cette formule permet d'effectuer facilement les calculs (même si je bloque encore pour trouver une expression directe de ce maximum) pour localiser le maximum de vraisemblance, en traçant par exemple dans un tableur la courbe de Cnd / nk en fonction de n. L'an dernier, après dégustation de 52 papillotes, j'avais trouvé 40 citations différentes. J'ai voulu compléter mes données, mais les papillotes Révillon ne sont pas vendues au printemps et en été (ils arrêtent apparemment la production à cette période) et j'ai dû patienter jusqu'à cet hiver pour acheter et engloutir deux paquets (ma ligne aura un peu pâti de cette expérience, mais bon... je sers la science et c'est ma joie) : le premier m'a fourni 33 citations différentes sur 42, le second 33 différentes sur 41, l'union des deux 58 citations différentes sur 83. Ceci me donne les quatre courbes suivantes pour P40,52, P33,42, P33,41 et P58,83 en fonction de n :


Le maximum de la courbe est atteint respectivement à 93, 81, 89 et 107. Remarquez que plus l'échantillon est grand, plus le pic est fin : la précision de la méthode s'améliore...

Après avoir obtenu mes premières données, j'avais contacté Révillon pour demander confirmation de l'ordre de grandeur de 93. Ils m'ont répondu qu'il y a en fait 108 citations différentes pour les paquets de la collection "Festive" que j'avais testés. Mes collages font apparaître des cycles de 18 citations, j'ai pu en reconstituer 3 sur 6 :
Bien sûr, j'aimerais appliquer cette méthode d'estimation à d'autres données, par exemple les billets en euros (le site EuroBillTracker permet de récupérer le nombre total, et le nombre de billets différents, de l'échantillon constitué par les billets relevés par les participants au site) ou les blagues Carambar que j'évoque dans cette présentation :


Toutefois, pour ces deux estimations, outre le problème technique de calcul de très grands coefficients binomiaux pour le premier (je cherche un document de référence sur la méthode qui consiste à utiliser des logs pour ce type de calculs sur des grands nombres !), une hypothèse raisonnable (si si, Guyslain !) pour les papillotes ne fonctionne plus : le tirage de chaque billet, ou blague Carambar, n'est pas équiprobable. En effet, pour les billets, je pense que les visiteurs d'EuroBillTracker notent sur le site une plus grosse proportion de la totalité des billets de 5 euros, que de la totalité des billets de 500 euros imprimés. Pour les Carambars, le problème est que les blagues n'ont pas le même nombre de lignes. Ainsi, les blagues les plus longues ont une plus forte probabilité d'apparaître, et donc créent plus de paires que prévu dans un modèle équiprobable...


27 octobre 2009

L'informatique de mêche avec les sciences humaines

Mes véronisations donnent généralement un aperçu de l'utilisation possible d'outils informatiques en sciences humaines, et j'ai essayé d'en savoir plus sur les liens réels entre ces deux domaines en participant vendredi dernier à la journée OSIDMESH (Outils Statistiques et Informatiques pour Doctorants Montpelliérains En Sciences Humaines) organisée par le LIRMM et l'Association Contact. Le bilan en est plutôt positif : un intérêt est sensible de la part des doctorants en sciences humaines, même si tous ne le ressentent pas au même niveau (problèmes techniques liés à la rédaction de la thèse, maîtrise d'outils généraux de traitement des données ou bien prise en main de logiciels spécialisés). La rencontre a en tout cas permis de présenter quelques possibilités permises par des logiciels existants ou des projets en cours, et de se mettre en contact pour un travail en commun plus poussé.


De mon côté j'ai fait des présentations sur deux sujets déjà apparus sur ce blog, qui me donnent l'occasion de mentionner quelques nouveautés à leur propos.


Si TreeCloud (cité dans l'article sur Wordle de chercheurs du formidable Visual Communication Lab d'IBM, mazette !) a déjà fait son apparition dans le coin, je n'ai pas encore dédié de billet à la version Python disponible depuis mars. Ce ne sera pas encore le cas, même si cette présentation montre quelques nouvelles fonctionnalités (sur le corpus Pantel), en particulier l'interface graphique (pour les allergiques à la ligne de commande) et la coloration ciblée en fonction de la cooccurrence autour d'un mot (une belle idée que j'ai récupérée dans AstarTex de Jean-Marie Viprey). Attendez encore une petite semaine si vous voulez télécharger une belle version : dans la prochaine, plus besoin de s'embêter avec les espaces dans les noms de fichiers, et quelques autres fonctions supplémentaires (coloration personnalisée, liste de mots du nuage personnalisée). Il sera alors temps de préciser quelques problématiques d'analyse textuelle (voire littéraires !) pour lesquelles la visualisation en nuage arboré montre son intérêt.


Je conclus cette seconde présentation avec l'exemple de la carte interactive de Lisbonne par Pessoa pour illustrer une utilisation possible de l'API Google Maps (attention, pour la France, on pourra lui préférer l'API Geoportail qui a l'air drôlement chouette). C'est l'occasion de citer un autre projet que j'ai dérivé de celui de Lisbonne, le recensement de tous les lieux barcelonais cités dans l'oeuvre d'Eduardo Mendoza (aussi réalisé en préparation d'un charmant voyage). Pas de dialogue direct entre la carte et le texte intégral, cette fois (je laisse le facétieux Eduardo encaisser ses droits d'auteur), mais j'ai pu réutiliser directement mes petits scripts permettant de créer automatiquement une carte imprimable (avec numéros) à partir de données d'une carte personnalisée Google Maps.

Je dois avouer que cette journée m'a permis, à ma grande honte, de découvrir moi aussi des outils informatiques qui me faciliteraient la vie. Zotero (merci Isabelle !) a l'air d'être ce dont j'ai toujours rêvé pour gérer mes favoris web, ma biblio et mes pdf d'articles... Une vidéo pour saliver en page d'accueil de leur site ici.

Et une question pour finir : vous connaissez un outil pour créer, à partir d'une thèse, ou d'un article, un index des auteurs cités avec, pour chacun, des mots-clés qui le caractérisent ? J'ai en tête une petite application du nuage arboré pour faire ça de façon semi-automatisée, mais peut-être qu'une solution (entièrement automatique ?) existe déjà...

4 septembre 2009

Bilan du questionnaire fait-ou-pas

Un questionnaire circule depuis plus de deux ans sur la blogosphère française, il consiste à mettre en gras ce qu'on a fait dans sa vie, parmi une liste d'une centaine de propositions. Après l'analyse du mème de la F-list, voilà donc celle du mème "fait-ou-pas".

De nombreuses caractéristiques du mème F-list (dont évidemment celles qui compliquent la récupération et l'analyse des données) se sont retrouvées dans celui-là : origine américaine (j'en trouve une trace dès juin 2004), erreurs de transmission du mème (oubli de questions, modifications d'intitulés), changement des règles du jeu (ajout d'une question à la fin du questionnaire), diffusion communautaire (blogs de gastronomie, puis blogs de loisirs, un passage par les blogs cinéma et les blogs littéraires), transmission virale non arborée (questionnaire repris chez plusieurs sources), formats divers selon la plate-forme de blog. Et ce cas de blogueuse qui répond au questionnaire, puis à une version un peu modifiée l'année suivante...

Malgré ces obstacles, j'ai réussi à identifier une liste globalement conservée de 130 questions chez 163 blogueurs ou de commentateurs de blogs (en recherchant sur Google ou Blogsearch certaines questions du questionnaires). Parmi celles-ci, 127 avaient reçu une réponse de tous ces participants (les questions 50 et 55 ont été omises par certains participants, la 16 a été modifiée...). Ces données sont disponibles ici dans un beau tableau à double entrée de 0 et de 1 (1 si fait, 0 sinon, blogueurs en colonnes, questions en lignes... je vous laisse imaginer le nombre de films que j'ai vu cet été en parallèle de cette ingrate tâche d'acquisition manuelle de données).

Quel est l'intérêt de ces données ? Bah, pour commencer ça a bien une petite valeur de sondage, même si l'échantillon n'est certainement pas représentatif de la blogosphère française. Parmi ceux qui ont répondu en tout cas, 5% ont piloté une Ferrari, 7% ont touché un iceberg, 17% vu des baleines. 42% ont sauté à l'élastique... Euh, comment ça ? La version cour d'école, ou bien l'autre un poil plus vertigineuse ? Eh oui là aussi la polysémie du français vient nous jouer des tours. Certains se permettent aussi d'interpréter les questions de façon assez large pour pouvoir répondre positivement.

Qu'est-ce qui obtient les plus gros pourcentages ? 96% pour "Se sentir vraiment heureux, même un court moment", et "faire une bataille de boules de neige". A l'inverse, personne n'a conduit de gondole à Venise et seuls deux ont visité "tous les" continents : marieestdanssonassiette "par la pensée, la gastronomie, la musique du monde et en lecture" (quand je vous disais que ça triche un peu :)...), et les Fenouillard (dans la version "olympique" à 5 continents). Le reste des pourcentages se trouve dans la troisième colonne de ce tableau.

Et là, vous vous dites que vous aimeriez bien savoir quels blogueurs ont fait les trucs les plus exceptionnels. Comment évaluer ça ? Le nombre d'actions réalisées comme le propose Nostaledonie en commentaire chez les Fenouillard ? Non, certaines sont visiblement plus extraordinaires que d'autres. Une idée est alors de considérer chaque pourcentage comme une probabilité p d'effectuer l'action. Il y a donc aussi probabilité 1-p de ne pas effectuer cette action. Et finalement, la probabilité d'effectuer une certaine liste de ces 130 actions est le produit des probabilités correspondantes pour chaque action. Bon, certes, en faisant une simple multiplication, je considère que ces probabilités sont indépendantes, ce qui est peu raisonnable (répondre oui à "élever des enfants" n'est pas indépendant de répondre oui à "changer la couche d'un bébé" par exemple). On supposera toutefois qu'elles le sont pour simplifier le calcul. Pour simplifier la lisibilité également, on prendra le log du résultat (c'est plus facile de lire "-10" que "0.0000000001", voir la troisième ligne de ce tableau). Voici donc la liste des 5 blogueurs (blogueuses ?) ayant la vie la plus extraordinaire, parmi ceux qui ont répondu :

  1. la famille Fenouillard (loin devant)
  2. Marie est dans son assiette ! (citée plus haut...)
  3. Tout Silo
  4. Poppyrose
  5. Leeloolène

Vous remarquez la présence de la fameuse n°2 du top Wikio, et de la 149. Tiens tiens, et si les blogueurs à la vie la plus exceptionnelle étaient aussi les plus lus et cités ? Eh bien non, après vérification, pas de corrélation. La récupération de données Wikio fournit en revanche d'autres conclusions. Déjà, que leur liste de blogs référencés est loin d'être complète. Elimination des blogs inactifs, refus d'indexation de la part des blogueurs ? Ceci n'explique pas que plus de 55% des blogs recensés dans cette étude ici échappent à Wikio. Leur catégorisation, bien qu'imparfaite (1/4 des blogs catégorisés ici le sont par "divers"), permet de constater que le mème s'est répandu de façon impressionnante sur la communauté gastronomie au printemps 2007. Puis, en novembre 2007 et février 2008, passage dans la communauté loisirs (remarquez qu'au même moment que la croissance de la courbe "loisirs", "divers" et "non catégorisés" augmentent également très fort, voilà un vivier de blogs loisirs à ajouter à Wikio !). Littérature et cinéma en août 2008. En tout cas ces courbes en paliers me semblent décrire très joliment une diffusion virale par communautés successives, et je rêve d'une visualisation interactive de la diffusion sur la wikiopole...

Il reste une dernière visualisation à extraire de ces données, les lecteurs fidèles de ce blog se doutent bien que je n'allais pas garder une belle matrice de 0 et de 1 sous la main sans la transformer en arbre. Eh oui, tentons de rapprocher les questions qui ont obtenu des réponses similaires :
L'ACP donnait un résultat assez moche, alors que là quelques jolis sous-arbres apparaissent (la correspondance entre les étiquettes de l'arbre et les questions précises se trouve dans la 2° colonne de ce tableau). J'ai ajouté des couleurs pour améliorer la lisibilité : quand des feuilles sont proches et ont la même couleur, elles sont dans le même sous-arbre, et constituent donc un cluster de questions auxquelles les gens ont répondu de manière similaire. Quelques clusters pas très étonnants qui permettent de valider cette classification : {se marier, acheter une maison, élever des enfants} {avoir un piercing, un tatouage} {sauter à l'élastique, faire de l'escalade} {danser sans se soucier de qui regarde, danser avec un inconnu} {manger du kangourou, manger du requin} {marcher sur le Golden Gate, visiter Las Vegas} ou encore {porter un agneau, aider un animal à donner naissance, traire une vache}. Pour certains regroupements, on soupçonne une histoire cachée derrière : {faire un art martial, se casser un os, passer à la télé} {avoir un accident, maigrir fortement, dormir 30 heures, jeûner 5 jours}. Mais pour préciser tout ça, et surtout comprendre les étonnants {manger des sushis, faire une balade nocturne sur la plage} ou {vendre ses créations, utiliser une arme à feu}, je cherche à utiliser d'autres techniques de fouilles de données ou classification. Les règles d'association me paraissent prometteuses, notamment, et si j'arrive à en tirer quelque chose vous en aurez des nouvelles sur ce blog.

11 mai 2009

Multinuage des programmes aux élections européennes

Le logiciel TagCloud Builder de construction de nuages de mots, présenté ici il y a déjà quelque temps, a bénéficié d'une mise à jour la semaine dernière : il permet désormais de représenter les mots de plusieurs textes au sein d'un seul nuage, en attribuant une couleur à chaque texte.

Cette idée m'a été proposée par Kirsten Talbot, qui termine son master en sciences sociales en Afrique du Sud, et voulait représenter ainsi ses données sur les stéréotypes communautaires dans l'Afrique du Sud post-apartheid. En attendant de pouvoir découvrir ses visualisations et ses résultats, voici un exemple d'utilisation de cette visualisation en multinuage de mots, sur les programmes (ou ce qui y ressemble le plus...) des quatre partis français en tête dans les sondages pour les européennes selon Ipsos :

Je trouve que le résultat obtenu est bien meilleur que la simple juxtaposition de nuages créés pour chaque texte, comme celle que j'avais tentée pour les programmes PS et UMP des présidentielles il y a deux ans. Mentalement, on peut soit se focaliser sur une couleur, et bien voir les mots qui apparaissent pour celle-ci, soit lire le nuage "linéairement", et comparer pour chaque mot à quelle taille il apparaît dans chaque couleur (cette deuxième lecture permet donc le contraste des deux nuages, sans se préoccuper de trouver une bonne formule de contraste). Il manque la possibilité de cliquer sur un mot pour voir ses occurrences dans un concordancier - comme Jean l'avait fait ici pour la constitution européenne par exemple - ça ne devrait pas tarder.

Et le style n'est pas aussi chouette que les nuages Wordle. Si quelqu'un connaît (ou programme) une implémentation libre de cette méthode de visualisation (l'algorithme de placement est pour l'instant © IBM), je suis très intéressé !

En ce qui concerne les améliorations arborées des nuages de mots, voici une présentation en français du principe et des détails techniques, donnée la semaine dernière au séminaire doctorants de mon labo. Ca vous donnera peut-être envie de tester TreeCloud qui est maintenant disponible avec une interface graphique facilitant son utilisation et un manuel d'utilisateur.

Données utilisées : détaillées ici.
Edit : merci à Vincent pour la correction du lapsus sur l'année !
D'autre part je n'ai pas commenté le nuage, qui me semble pourtant intéressant sur le fond : voici quelques mots (ou absences de mots) qui peuvent surprendre (ou au moins mériter d'aller examiner les contextes) : croissance, femme, identité, développement, énergie, nouvelle, et d'autres tendances plus attendues : droite, dumping, social, automobile, biologique, mobilité, citoyen, coopération, ambition, décidé, histoire, sociale, protection, turquie, libéralisme-capitalisme.

Ah, tiens, IBM a un truc similaire dans ManyEyes, mais apparemment limité à deux textes.