Affichage des articles dont le libellé est graphique. Afficher tous les articles

4 septembre 2009

Bilan du questionnaire fait-ou-pas

Un questionnaire circule depuis plus de deux ans sur la blogosphère française, il consiste à mettre en gras ce qu'on a fait dans sa vie, parmi une liste d'une centaine de propositions. Après l'analyse du mème de la F-list, voilà donc celle du mème "fait-ou-pas".

De nombreuses caractéristiques du mème F-list (dont évidemment celles qui compliquent la récupération et l'analyse des données) se sont retrouvées dans celui-là : origine américaine (j'en trouve une trace dès juin 2004), erreurs de transmission du mème (oubli de questions, modifications d'intitulés), changement des règles du jeu (ajout d'une question à la fin du questionnaire), diffusion communautaire (blogs de gastronomie, puis blogs de loisirs, un passage par les blogs cinéma et les blogs littéraires), transmission virale non arborée (questionnaire repris chez plusieurs sources), formats divers selon la plate-forme de blog. Et ce cas de blogueuse qui répond au questionnaire, puis à une version un peu modifiée l'année suivante...

Malgré ces obstacles, j'ai réussi à identifier une liste globalement conservée de 130 questions chez 163 blogueurs ou de commentateurs de blogs (en recherchant sur Google ou Blogsearch certaines questions du questionnaires). Parmi celles-ci, 127 avaient reçu une réponse de tous ces participants (les questions 50 et 55 ont été omises par certains participants, la 16 a été modifiée...). Ces données sont disponibles ici dans un beau tableau à double entrée de 0 et de 1 (1 si fait, 0 sinon, blogueurs en colonnes, questions en lignes... je vous laisse imaginer le nombre de films que j'ai vu cet été en parallèle de cette ingrate tâche d'acquisition manuelle de données).

Quel est l'intérêt de ces données ? Bah, pour commencer ça a bien une petite valeur de sondage, même si l'échantillon n'est certainement pas représentatif de la blogosphère française. Parmi ceux qui ont répondu en tout cas, 5% ont piloté une Ferrari, 7% ont touché un iceberg, 17% vu des baleines. 42% ont sauté à l'élastique... Euh, comment ça ? La version cour d'école, ou bien l'autre un poil plus vertigineuse ? Eh oui là aussi la polysémie du français vient nous jouer des tours. Certains se permettent aussi d'interpréter les questions de façon assez large pour pouvoir répondre positivement.

Qu'est-ce qui obtient les plus gros pourcentages ? 96% pour "Se sentir vraiment heureux, même un court moment", et "faire une bataille de boules de neige". A l'inverse, personne n'a conduit de gondole à Venise et seuls deux ont visité "tous les" continents : marieestdanssonassiette "par la pensée, la gastronomie, la musique du monde et en lecture" (quand je vous disais que ça triche un peu :)...), et les Fenouillard (dans la version "olympique" à 5 continents). Le reste des pourcentages se trouve dans la troisième colonne de ce tableau.

Et là, vous vous dites que vous aimeriez bien savoir quels blogueurs ont fait les trucs les plus exceptionnels. Comment évaluer ça ? Le nombre d'actions réalisées comme le propose Nostaledonie en commentaire chez les Fenouillard ? Non, certaines sont visiblement plus extraordinaires que d'autres. Une idée est alors de considérer chaque pourcentage comme une probabilité p d'effectuer l'action. Il y a donc aussi probabilité 1-p de ne pas effectuer cette action. Et finalement, la probabilité d'effectuer une certaine liste de ces 130 actions est le produit des probabilités correspondantes pour chaque action. Bon, certes, en faisant une simple multiplication, je considère que ces probabilités sont indépendantes, ce qui est peu raisonnable (répondre oui à "élever des enfants" n'est pas indépendant de répondre oui à "changer la couche d'un bébé" par exemple). On supposera toutefois qu'elles le sont pour simplifier le calcul. Pour simplifier la lisibilité également, on prendra le log du résultat (c'est plus facile de lire "-10" que "0.0000000001", voir la troisième ligne de ce tableau). Voici donc la liste des 5 blogueurs (blogueuses ?) ayant la vie la plus extraordinaire, parmi ceux qui ont répondu :

  1. la famille Fenouillard (loin devant)
  2. Marie est dans son assiette ! (citée plus haut...)
  3. Tout Silo
  4. Poppyrose
  5. Leeloolène

Vous remarquez la présence de la fameuse n°2 du top Wikio, et de la 149. Tiens tiens, et si les blogueurs à la vie la plus exceptionnelle étaient aussi les plus lus et cités ? Eh bien non, après vérification, pas de corrélation. La récupération de données Wikio fournit en revanche d'autres conclusions. Déjà, que leur liste de blogs référencés est loin d'être complète. Elimination des blogs inactifs, refus d'indexation de la part des blogueurs ? Ceci n'explique pas que plus de 55% des blogs recensés dans cette étude ici échappent à Wikio. Leur catégorisation, bien qu'imparfaite (1/4 des blogs catégorisés ici le sont par "divers"), permet de constater que le mème s'est répandu de façon impressionnante sur la communauté gastronomie au printemps 2007. Puis, en novembre 2007 et février 2008, passage dans la communauté loisirs (remarquez qu'au même moment que la croissance de la courbe "loisirs", "divers" et "non catégorisés" augmentent également très fort, voilà un vivier de blogs loisirs à ajouter à Wikio !). Littérature et cinéma en août 2008. En tout cas ces courbes en paliers me semblent décrire très joliment une diffusion virale par communautés successives, et je rêve d'une visualisation interactive de la diffusion sur la wikiopole...

Il reste une dernière visualisation à extraire de ces données, les lecteurs fidèles de ce blog se doutent bien que je n'allais pas garder une belle matrice de 0 et de 1 sous la main sans la transformer en arbre. Eh oui, tentons de rapprocher les questions qui ont obtenu des réponses similaires :
L'ACP donnait un résultat assez moche, alors que là quelques jolis sous-arbres apparaissent (la correspondance entre les étiquettes de l'arbre et les questions précises se trouve dans la 2° colonne de ce tableau). J'ai ajouté des couleurs pour améliorer la lisibilité : quand des feuilles sont proches et ont la même couleur, elles sont dans le même sous-arbre, et constituent donc un cluster de questions auxquelles les gens ont répondu de manière similaire. Quelques clusters pas très étonnants qui permettent de valider cette classification : {se marier, acheter une maison, élever des enfants} {avoir un piercing, un tatouage} {sauter à l'élastique, faire de l'escalade} {danser sans se soucier de qui regarde, danser avec un inconnu} {manger du kangourou, manger du requin} {marcher sur le Golden Gate, visiter Las Vegas} ou encore {porter un agneau, aider un animal à donner naissance, traire une vache}. Pour certains regroupements, on soupçonne une histoire cachée derrière : {faire un art martial, se casser un os, passer à la télé} {avoir un accident, maigrir fortement, dormir 30 heures, jeûner 5 jours}. Mais pour préciser tout ça, et surtout comprendre les étonnants {manger des sushis, faire une balade nocturne sur la plage} ou {vendre ses créations, utiliser une arme à feu}, je cherche à utiliser d'autres techniques de fouilles de données ou classification. Les règles d'association me paraissent prometteuses, notamment, et si j'arrive à en tirer quelque chose vous en aurez des nouvelles sur ce blog.

23 novembre 2008

Bruits d'Aubry sur Google

Depuis juillet, je prends régulièrement la température Google des présidentiables pour 2012 en recherchant l'expression "X en 2012" ou "X candidat(e) en 2012" pour divers X. Les chiffres obtenus ne sont pas toujours très parlants si l'on regarde précisément pour chacun, mais sont globalement pertinents pour visualiser le bruit du web autour des candidatures potentielles. Depuis juillet, pas trop d'évolution pour les candidats de gauche (justement, le reflet qu'aucun champion n'est sorti du lot ?), mais ça s'est réveillé avant-hier pour Martine Aubry :
A droite, rien de nouveau (Chirac ou Villepin ont eu des bonds qui viennent d'erreurs d'évaluation du nombre de résultats par Google). En revanche pour 2017, malgré les petits chiffres, c'est plus intéressant, avec un trio de tête Copé, Sarkozy, Dati :

18 novembre 2008

Claviers espions : usure et fréquence de lettres

Dur dur de poster après une période silencieuse sur son blog... Reprendre un billet vaguement réveillé par un autre d'un blog influent ? Ficeler un rapport peu concluant sur l'influence de la plateforme sur le classement d'un blog ? Non, il faut un nouveau résultat fort, mêlant une idée théoriquement ingénieuse et calculable en pratique, un vrai projet de longue haleine qui montre qu'on n'a pas chômé...

Tout est parti de deux touches de clavier défaillantes. Delphine, déjà à l'origine de quelques posts sur ce blog, notait que les deux touches qui s'étaient détachées de son clavier faisaient partie du mot-clé principal de sa thèse. Il n'en fallait pas plus pour me faire envisager une forte corrélation entre l'usure des touches et leur fréquence d'utilisation (aussi remarquée ici par exemple), et rechercher les moyens de mesurer tout ça... et d'en déduire des choses.


Par chance, mon clavier Dell reflète assez bien son utilisation (ceux de certains Mac aussi apparemment, voire les claviers NMB Technologies), au bout d'un an. Mon "S" est par exemple presque complètement effacé. Mais surtout, si on regarde de plus près, les touches fréquemment utilisées sont vraiment usées, le plastique y est plus lisse, et elles réfléchissent beaucoup mieux la lumière. Je ne sais pas ce que ce polissage implique sur l'absorption de matières toxiques du bout des doigts, mais en tout cas il permet de faire des mesures : en éclairant le clavier par dessus et en prenant la photo de travers, les zones très réfléchissantes apparaissent plus sombres que le reste.

Il faut alors quantifier l'usure à partir de la photo. Si l'on veut des résultats très précis, on peut s'amuser à faire du traitement d'image et mesurer l'intensité sur les portions de photo qui correspondent aux touches. Ca demande un gros travail, surtout de normalisation de l'image... alors qu'on peut procéder plus simplement : construire un quadrillage 5x5, le coller sur chaque touche, et compter les carreaux, parmi ces 25, qui sont sombres. En fait, pour les premières lettres, on compte les carreaux pour préparer quelques étalons, après, on compare avec les lettres dont l'usure a déjà été évaluée.
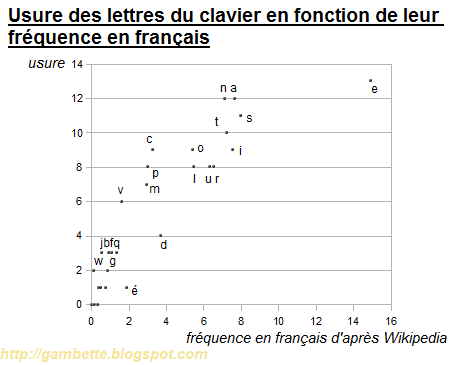
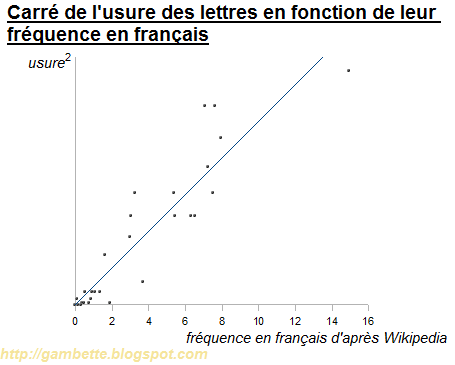
Une fois ces quantités d'usure obtenues, on peut les comparer avec les fréquences de lettres en français. Pour cela, on me l'a confirmé dans mon cours de biostats cette année, rien ne vaut un joli diagramme XY :

La corrélation est nette (coefficient 0,89), toutefois la relation entre les deux variables semble n'être pas exactement linéaire. Essayons d'élever l'usure au carré, ça semble mieux fonctionner (coefficient de corrélation 0,92), même si ce n'est pas parfait :

Qu'est-ce qui pourrait expliquer ces variations par rapport à la distribution moyenne des lettres en français ? Les gros joueurs de jeux vidéos ont apparemment leurs touches fétiches, je pense que ma forte usure de C et V vient de mon abus de raccourcis pour le copier coller, pour W c'est sûrement les adresses web. De plus, j'utilise mon ordinateur pour écrire à la fois en français et en anglais. Tiens tiens, et si j'utilisais l'usure des touches pour évaluer à quelle fréquence je tape en anglais ou en français ?

L'idée est donc que la distribution de l'usure n'est pas semblable à celle du français, mais à une combinaison linéaire de celle du français et de l'anglais. J'appelle U(l) ma fréquence d'utilisation de la lettre l, F(l) (respectivement A(l)) sa fréquence d'utilisation en français (resp. en anglais), et j'appelle x le ratio de ce que je tape en français par rapport à tout ce que j'écris avec mon ordinateur. U est donc une loi mélange de F et A : U(l) = x F(l) + (1-x) A(l). J'essaie de trouver x en connaissant une approximation de U, de F et de A pour toute lettre. Pour cela, je vais calculer le membre de droite pour toutes les valeurs de x entre 0 et 1, et évaluer la corrélation avec U. Tout peut se faire avec un tableur, ça se passe ici.

J'en profite pour une petite digression sur le coefficient de corrélation de Pearson, implémenté par COEFFICIENT.CORRELATION dans tout tableur digne de ce nom, que j'avais utilisé dans certains posts précédents sans comprendre sa formule magique. En fait, la formule est tout à fait naturelle une fois qu'on a compris que pour normaliser des distributions, classiquement, on divise les valeurs par l'écart type, avant de soustraire la moyenne (merci encore au cours de biostats, décidément ces modules doctoraux ont du bon quand on les choisit soi-même...).

Bref, passons aux résultats. J'utilise trois distributions de fréquences de lettres en français trouvées sur internet pour F, deux pour l'anglais et la distribution A. A chaque fois je calcule la valeur optimale de x. Je termine par une moyenne de ces valeurs de x : 0.81 (avec selon la distribution une variation inférieure à 10%). Bref, environ 1/5 de ce que je tape est en anglais.

A quel point la méthode présentée ici est fiable ? D'une part, il est connu que les fréquences de lettres varient selon le corpus utilisé. D'autre part, le coefficient de corrélation que je tente de maximiser afin de trouver le ratio x est peut-être trop sensible à de petites variations sur les fréquences de lettres. Pour tester ça, j'ai collé un bout de texte anglais à un bout de texte français (en connaissant le ratio x, donc) et j'ai essayé de le retrouver par la méthode de maximisation du coefficient de corrélation. Pour une étude plus sérieuse, j'aurais peut-être essayé un corpus de textes variés, là au vu des résultats je me suis contenté de mon premier essai.

J'ai utilisé cet outil en ligne de calcul de fréquence de lettres, qui fournit des pourcentages de fréquences arrondis à l'entier près (pas très précis, donc, à peu près autant que mes mesures sur le clavier). J'ai copié le premier article du Monde que j'ai eu sous les yeux dans mon flux RSS, concaténé au texte de la page d'accueil de l'outil, en anglais donc (remarquez que ces deux textes sont très courts). Puis appliqué la méthode, avec les deux distributions de fréquences pour l'anglais et les trois pour le français. En faisant la moyenne des coefficients trouvés, j'obtiens 0,79 alors que la valeur réelle était 0,81 (8327 octets pour le texte français, 1904 pour l'anglais), soit à peine 3% d'erreur (et pour chaque couple de distributions de fréquences anglais/français, moins de 10% d'erreur).

Bref, je suis assez confiant pour placer une marge d'erreur de 10%, et affirmer qu'il est possible de deviner par cette technique la langue d'un utilisateur d'ordinateur Dell qui use raisonnablement son clavier. Pas mal sans utiliser de vrai clavier espion !

28 mars 2008

Cuisine : polyèdre des ingrédients et enveloppe convexe

Ma cuisine a récemment rejoint ma liste de lieux de découverte et d'émerveillement montpelliérains (après mon labo, ma médiathèque, mon ordinateur, ma salle de concerts et mes cinémas). Pas besoin de tenter d'audacieuses expériences de gastronomie moléculaire pour être fasciné par de simples changements de forme, de couleur et de texture. Que d'émotions à expérimenter la cuisson mutationnelle des choux au Comté, le durcissement de mes fameuses meringues-radiateur, ou une simple montée de blancs en neige au fouet ! Alors rassurez-vous, ce blog ne va pas s'aventurer sur la paillasse d'un chimiste, je ne parlerai ni du pourquoi ni comment ça marche, mais seulement du jusqu'à quel point ça marche ?Rien de plus affirmatif qu'une recette de cuisine : on vous fournit une liste d'ingrédients avec des quantités bien précises, et leur mode d'emploi. Si vous déviez à peine des instructions, aucune garantie, et avec une précision des ingrédients au centigramme, prenez garde que moelleux fondant "merde-j'ai-pu-qu'-deux-oeufs" Marmiton au chocolat ne se transforme en galette compacte.
Heureusement, ce blog va apporter une contribution révolutionnaire pour tous les auteurs de recettes de cuisine : le polyèdre des ingrédients ! Et en bonus une méthode pour le calculer artisanalement à partir d'un corpus de plusieurs recettes du plat que vous voulez, trouvées sur le net par exemple. Illustration du jour : les crêpes ! (oui, je sais, j'aurais dû écrire ce billet il y a 54 jours mais j'ai totalement renoncé à publier à temps mes billets d'actualité...)

Ce qu'il y a de bien dans les crêpes, c'est que ça se fait avec en gros trois ingrédients (plus un pour la poële, qui ne compte pas), ça va donc nous permettre d'obtenir une jolie image en 3D. Des oeufs, de la farine, et du lait, voilà le dénominateur commun aux 19 recettes que j'ai réunies (dans ce fichier tableur) grâce aux sites lejus.com, 1001delices.net, recette-crepe.net, goosto.fr, supertoinette.com, recettes.qc.ca et Marmiton (désolé pour mes amis végétaliens). Mais peut-être va-t-on commencer avec seulement deux ingrédients pour bien comprendre. Disons que l'on a déjà décidé du nombre d'oeufs à utiliser, un seul par exemple. On calcule alors selon toutes les recettes, par une règle de trois, la quantité x de lait et y de farine qu'on doit ajouter (j'ai tout codé en grammes pour simplifier). On peut alors placer sur un graphique cette vingtaine de points de coordonnées (x,y) obtenus :

En bas à gauche se trouvent les recettes avec beaucoup d'oeufs (puisqu'il y a peu de farine et de lait), en haut à droite avec peu d'oeufs. En haut à gauche, plus de farine, en bas à droite, plus de lait. Qu'est-ce donc que cette sorte d'élastique orange qui se resserre autour des points ainsi dessinés ? C'est une sorte de zone de sécurité : tout point de cette zone correspond à un choix d'ingrédients qui devraient fonctionner, puisqu'il se situe "entre" des choix de quantités d'ingrédients qui fonctionnent. En mathématiques, on appelle ça l'enveloppe convexe de l'ensemble de ces points, et il existe des algorithmes variés pour la calculer automatiquement. Alors évidemment, pour ne prendre aucun risque il vaudra mieux cibler bien au milieu de cette enveloppe, vous pouvez d'ailleurs remarquer que 3 recettes présentent les mêmes quantités des trois ingrédients principaux, cela correspond à un point assez central (1/2 litre de lait et 250 grammes de farine pour 3 oeufs).

Autre enseignement de cette enveloppe convexe, on peut en déduire des informations sur la précaution à mesurer chaque ingrédient (la robustesse de la recette en fonction de chaque paramètre en gros). Remarquez combien l'enveloppe convexe est allongée et étroite (elle le serait encore plus si j'avais choisi une échelle verticale et horizontale identiques). Cela signifie que selon les recettes la quantité d'oeufs varie pas mal, mais la proportion lait/farine beaucoup moins. On peut d'ailleurs comparer pour chaque recette ses proportions par rapport aux proportions moyennes :

Et si l'on fait la moyenne de ces pourcentages de variation en valeur absolue, on obtient : 16% pour le rapport lait/farine, 28% pour le rapport farine/oeufs, 31% pour le rapport lait/oeufs. Ainsi le rapport lait/farine varie beaucoup moins que les autres parmi les recettes, il faudra donc être plus méticuleux dans ces proportions que pour le nombre d'oeufs, par rapport à la variation duquel la recette des crêpes est donc plutôt robuste (désolé pour cette structure de phrase alambiquée, mais ça me donne l'occasion de faire un joli accord de pronom relatif).

Vous pouvez aussi vous amuser à représenter sur un même graphique plusieurs desserts ayant les mêmes ingrédients principaux, ici les crêpes, les gaufres et le flan :
Attention tout de même avant de verser votre pâte à crêpes dans le gaufrier ou les ramequins au four, il y a aussi un peu d'huile et de levure dans la préparation à gaufres, et de sucre dans celle du flan.

Pour finir, passons au polyèdre 3D des ingrédients grâce à la très jolie applet Java de Tim Lambert (dont il distribue en plus de code source que j'ai modifié pour y mettre mes points de crêpes), vous pouvez agir avec la souris pour contrôler le polyèdre et le faire bouger :


Sorry, but you need Java to see the animation.

Là encore c'est une enveloppe convexe qui est calculée, en 3 dimensions, sur des points de coordonnées (x,y,z) avec cette fois le nombre d'oeufs en x, la quantité de lait en y, et de farine en z. Je place les points en fixant le nombre d'oeufs à une limite minimum et une limite maximum pour obtenir ce joli tronc de cône, tel que toute coupe perpendiculaire à l'axe x (à nombre d'oeufs constant) me donne bien le polygone d'enveloppe convexe de même forme que ci-dessus. Et pour le rendre vraiment utilisable il faudrait pouvoir laisser entrer à l'utilisateur les valeurs de quantités d'ingrédients qu'il a lui-même utilisées : si le point arrive à l'intérieur du polyèdre, tout va bien, sinon... gare à la recette loupée !

Eh bien il me reste maintenant à attendre le prochain livre de cuisine ou pâtisserie (ou site web) qui accompagnera ses recettes de polygones ou polyèdres d'ingrédients, bizarrement je crois que je devrai faire preuve d'un peu de patience. Encore que... Il y a bien des geeks qui ont programmé un moteur de recherche de recettes de cuisine à partir des ingrédients sur cuistot.org !


Mise à jour en soirée : il me semble naturel que si deux points correspondant à des quantités d'ingrédients fonctionnent pour une recette, alors tout le segment entre ces deux points fait aussi fonctionner la recette, mais certains lecteurs que je ne nommerai pas n'en sont pas convaincus. Tout contrexemple, ou toute théorie alternative quant à la structure, dans l'ensemble à multidimensionnel des ingrédients, des ensembles de points permettant de préparer avec succès un certain plat, sera le bienvenu ! Ce défi du contrexemple est doté d'un prix : une invitation à le déguster (ou bien, si je suis de bonne humeur, à déguster plutôt une des deux extrémités, qui fonctionnent, du segment).

14 mars 2008

Rétroingéniérie de Google Trends (2) : marge d'erreur

J'avais prévenu dans mon dernier billet, aujourd'hui on parle de choses techniques : la marge d'erreur de mon calcul. Rien de terrible non plus, hein, les calculs sont de niveau lycée... Et en fin de billet, quand même quelques éléments de méthodologie pour minimiser l'erreur. Résumé de l'épisode précédent : j'ai choisi une hiérarchie de termes qui apparaissent de plus en plus haut dans Google Trends, pour évaluer par règles de trois successives le niveau du terme le plus recherché par rapport au moins recherché.

Pour mon calcul je m'étais initialement arrangé instinctivement pour que dans chaque paire de termes consécutifs, le premier ait un maximum environ 2 fois plus haut que le précédent. En effet, la marge d'erreur absolue de lecture de la valeur des courbes est d'environ 1 pixel. Sauf que cette erreur absolue ne correspond pas à la même erreur relative pour la courbe du dessus et celle du dessous. Celle du dessus culmine toujours à 113 pixels : 1 pixel d'erreur c'est donc moins de 1%. Mais pour celle du dessous, si elle culmine à 50 pixels, ça fera 2% d'erreur. Si elle ne dépasse jamais 3 pixels, c'est plus de 30% d'erreur ! Alors dans ce cas, doit-on choisir une hiérarchie de courbes qui sont très proches les unes des autres ? Pas nécessairement, puisque dans ce cas effectivement on réduit l'erreur à chaque étape du calcul, pour deux termes consécutifs, mais on augmente le nombre de termes (et donc d'erreurs successives) entre le moins recherché sur Google, et le plus recherché.

Evidemment, ce délicat compromis que je viens d'exprimer avec des mots, je n'ai pas pu m'empêcher de le modéliser mathématiquement. Je vais appeler a le rapport entre la hauteur max de la courbe la plus haute et celle de la plus basse parmi deux consécutives (et donc a>1). Pour simplifier le problème je considère que dans toute mon échelle de termes, ce rapport est constant. Ainsi, idéalement, j'aimerais trouver un mot 1 cherché x fois par jour sur Google, un mot 2 cherché ax fois par jour, un mot 3 cherché a2x fois par jour... un mot n+1 cherché anx fois par jour.

Maintenant, exprimons cette histoire d'erreur à chaque étape entre deux mots consécutifs : au lieu de lire une hauteur de k pour un mot et ak=113 pour le mot suivant, disons que je me trompe d'un pixel, à chaque fois trop haut (c'est une hypothèse pessimiste, en réalité, l'erreur alterne probablement, une fois on lit trop haut, une fois trop bas, et ça compense...). Pour mon calcul, s'il n'y avait pas d'erreur, par la règle de 3 je devrais trouver comme valeur du nombre de recherches du terme le plus haut :

x.113/k = x.ak/k = xa

Problème, je fais 1 pixel d'erreur, et donc quand j'applique la règle de 3 j'obtiens :
x.113/(k+1) = x.113/(113/a+1) = x.113a/(113+a)

Ainsi à chaque étape je multiplie par 113a/(113+a) au lieu de multiplier par a, donc pour le terme le plus recherché, je trouve x(113a/(113+a))n au lieu de xan. Je sous-estime donc la valeur réelle : ainsi pour minimiser l'erreur, je dois maximiser ma valeur calculée, donc trouver la valeur de a>1 qui maximise x(113a/(113+a))n.

Deuxième partie du raisonnement maintenant : le nombre d'étapes, c'est à dire n+1 termes, certes... mais ce n dépend de a. En effet, considérons qu'on s'est fixés le terme le moins recherché (x fois) et le terme le plus recherché (x'=xan fois). Alors x'=xen ln a, d'où ln(x'/x)=n ln a et donc n=ln(x'/x)/ln a.

Injectons ça dans la formule du haut, on a sous-estimé tous les termes de la hiérarchie, et le plus haut a été évalué à :
x(113a/(113+a))ln(x'/x)/ln a

expression qu'on doit donc maximiser par rapport à a. Commençons par une analyse de cette fonction aux limites (mmmmh, les bons souvenirs de première !). En 1+, l'intérieur de la parenthèse est inférieur à 1, et l'exposant tend vers +∞, donc l'expression tend vers 0. En +∞, l'exposant tend vers 0, et l'intérieur de la parenthèse vers 113, le tout tend donc vers 1. Ca tombe bien, c'est assez intuitif, ça exprime mathématiquement le dilemme que j'exprimais au second paragraphe... Bon bref, tout ceci ne nous dit pas où se situe son maximum. Et là ni Ahmed le Physicien, ni Julian le Mathématicien, armés respectivement de Mathematica et Maple, ne me fournissent une belle formule, il reste quelques méchants RacineDe(...) dans l'expression.

Pas grave, on va se contenter d'en trouver une approximation à l'aide d'un tableur. Le fichier est ici, et voici la courbe obtenue pour un rapport de 20 000 entre le mot le moins cherché et le plus cherché (c'est de l'ordre de grandeur de celui que j'ai dans ma hiérarchie de termes) :
Ainsi l'erreur minimale est atteinte pour une valeur de a d'environ 2,75 (soit une hauteur maximale de 41 pixels pour la courbe du bas). Elle est alors d'un peu moins de 25%. C'est certes conséquent, mais rappelez-vous qu'on a choisi le scénario où les erreurs se cumulaient par sous-estimation systématique. Alors il me reste cette question théorique intéressante : peut-on calculer l'espérance de l'erreur sur la valeur calculée du terme le plus fréquemment cherché, si à chaque étape l'erreur oscille aléatoirement à chaque mesure entre -1 et +1 pixel ?

On remarque aussi que la courbe croît plus vite à gauche qu'à droite : comme suggéré en vert sur le graphique, il semble qu'il vaudrait mieux choisir une hiérarchie telle que les nombres de recherches des mots de référence consécutifs ont un rapport de 4, plutôt qu'un rapport de 2.

Maintenant, voici quelques autres moyens d'améliorer la précision du calcul. Tout d'abord la précision de la mesure : au lieu de simplement mesurer le maximum où on sait qu'il y a une erreur inévitable, on peut tenter de le calculer à partir de mesures qui contiennent moins d'erreur. Je reprends l'exemple du billet précédent avec cat, dog, et phone:
Comparaison cat ~ dog (courbe 1) : 65 px ~ 113 px
Comparaison dog ~ phone (courbe 2) : 69 px ~ 113 px

Sauf qu'au lieu de mesurer le maximum de dog, on peut l'évaluer de la façon suivante faire la moyenne des valeurs sur la courbe 1 de dog, et la moyenne des valeurs sur la courbe 2 de dog. On en déduit alors un changement d'échelle tout à fait précis. On sait alors que le maximum de dog sur la courbe 1 est atteint à 113 pixels exactement, puisque ça semble être la valeur de référence dans les dessins Google Trends. On multiplie donc cette valeur par le changement d'échelle, et le tour est joué !

Alors maintenant autre problème : comment obtenir la moyenne des valeurs d'une courbe Google Trends ? Avec le CaptuCourbe, évidemment ! Alors là aussi, attention : il arrive que certaines valeurs ne soient pas récupérées par le CaptuCourbe (problème de couleur, par exemple la courbe est coupée par une ligne verticale noire accrochée à une bulle de légende Google News). Il s'agit donc de prendre garde à effectuer la moyenne des deux courbes sur des valeurs bien récupérées !

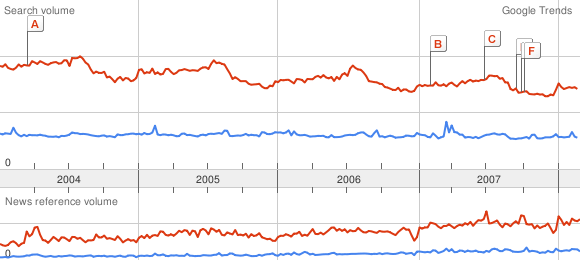
Autre chose, le CaptuCourbe, par sa méthode de capture, n'est pas très précis puisqu'il récupère tous les pixels de la couleur de la courbe, et en fait la moyenne. J'ai donc développé une nouvelle version, bientôt en ligne, qui permet de récupérer non pas la moyenne mais le max des hauteurs des pixels d'une certaine couleur. C'est cette fonction que j'utilise dans ma méthode pour calculer le max, en revanche c'est toujours celle de la moyenne que j'utilise pour calculer les moyennes des courbes. Ce petit détail n'en est pas un, comme le prouve par exemple la courbe Google Trends de Britney Spears, que j'ai capturée par la méthode du max, et de la moyenne :
Une erreur de 20% dans la mesure de plusieurs pics en utilisant la moyenne des pixels de même couleur, vraiment pas négligeable !

Pour terminer cette série de billets sur l'échelle verticale de Google Trends, il me reste encore quelques questions. Tout d'abord préciser la "valeur du foo". Grâce à des commentaires pertinents sur mon premier billet, je n'en suis pas loin. Je pourrai alors tenter d'automatiser toute la chaîne de récupération de courbes, mesures, et calculs, décrite dans le premier billet, pour fournir un programme qui précise sur une courbe Google Trends à combien de visiteurs correspondent les pics. Ceci dit je ne promets rien, ça vaudrait peut-être le coup d'attendre si l'API que Google prépare fournira ces données.

L'estimation du nombre de recherches pour un mot clé est en tout cas un défi intéressant, j'ai découvert le logiciel gratuit GTrends Made Easy qui propose de telles estimations par une méthode similaire à celle que j'ai présentée ici (en fait il ne fait qu'une seule règle de trois, en comparant le terme cherché avec un mot dont il connaît le nombre de recherches Google par un bon placement Google sur ce mot, et donc se limite aux mots qui apparaissent entre 5 et 50000 fois par jour, c'est à dire inférieurs à 100 foo), qui avait été décrite sur cette vidéo YouTube. Dommage que leurs auteurs n'aient pas poussé leur idée plus loin en enchaînant les changements d'échelle au lieu de se limiter à un.

10 mars 2008

Rétroingéniérie de Google Trends (1)

En janvier, j'avais proposé un utilitaire, le CaptuCourbe, pour extraire les valeurs d'une courbe, avec application possible à Google Trends. Depuis, l'outil s'est enrichi des couleurs par défaut des courbes Google, mais il manque toujours une donnée importante : quelle échelle verticale choisir ? Google prend en effet la précaution de cacher aux utilisateurs l'échelle utilisée. De plus comme les zooms ne sont pas permis, il n'est pas possible d'effectuer directement des comparaisons de courbes à différents ordres de grandeur. La hauteur maximum de courbe est en effet de 113 pixels, donc vous ne pouvez pas distinguer si un terme a été cherché 1000 fois, ou 10 000 fois moins qu'un autre.

Voici donc une hiérarchie de mots anglais, dans un ordre décroissant de recherches Google d'après Google Trends : of, free, sex, car, dog, gun, muscle, knife, torn, filming, separating, fooling.

On peut les utiliser pour créer une échelle pour Google Trends. Attention, elle ne sera pas précise (j'y reviendrai), mais permettra tout de même d'obtenir des valeurs quantitatives. Pour l'établir, j'ai procédé en recherchant conjointement dans Google Trends deux termes successifs dans la liste ci-dessus. Cela me permet d'évaluer le changement d'échelle pour chaque paire de successifs, en comptant la hauteur en pixel du maximum de chaque courbe. Une image est plus parlante que mes explications :

Comme je fais ça pour chaque paire de mots successifs, j'obtiens des valeurs de ce genre :
Comparaison cat ~ dog : 65 px ~ 113 px
Comparaison dog ~ phone : 69 px ~ 113 px
ce qui me permet de déduire en utilisant habilement des règles de trois que :
cat ~ dog ~ phone : 65 ~ 113 ~ 113*113/69=185,06
si l'on se base sur l'échelle de la première ligne ou bien :
cat ~ dog ~ phone : 69*65/113=39,69 ~ 69 ~ 113
si l'on se base sur l'échelle de la seconde.

Bref, j'ai reproduit ce raisonnement sur mes 11 mots pour obtenir les valeurs de maximum suivantes, en fixant la référence à fooling, et en appelant donc cette nouvelle unité le foo :

Attention, ce qui est à retenir, ce n'est pas seulement ces diverses valeurs, mais aussi la position du maximum qui atteint chaque valeur, c'est pourquoi en cliquant sur chaque mot ci-dessus vous accédez à une capture de la courbe vous permettant de localiser le max. En effet si vous voulez déterminer la valeur d'un pic pour un nouveau mot, soit vous avez compris le principe de la règle de 3 et vous amusez à calculer vous-même le max, soit vous indiquez simplement au CaptuCourbe l'échelle verticale en choisissant le max de la courbe de référence juste au-dessus du pic :
Par exemple ici environ 800 foo pour Manaudou en décembre 2007, à comparer avec les 240 foo du pic Bruni, ou les 470 foo atteints par Obama, les 1000 foo de Britney et les 3200 foo du tsunami de 2004 ou les 5700 foo de... Janet Jackson après le Superbowl 2004 !

Après l'annonce un peu commerciale de cette jolie petite échelle, l'honnêteté du scientifique m'oblige à quelques remarques :
- la marge d'erreur lors du calcul par enchaînement de règles de 3 successives : c'est le sujet de mon prochain billet et ce sera un peu technique (yaura même une jolie équation que ni Maple ni Mathematica n'arrivent à simplifier)... retenez que les nombres proposés ici doivent être valides à 10% près. Je me suis retenu de préciser plus de décimales, me souvenant de la sage annotation d'une prof de physique de lycée (au nom écorché par les sauvages utilisateurs de Note2Be) sur une de mes copies : "précision illusoire".
- non content de ne pas fournir l'échelle verticale de ses courbes, Google se permet aussi de les modifier fortement d'un jour à l'autre (c'est peut-être simplement un problème de discrétisation de la courbe réalisée "à la hache" sans se poser de question, mais dans ce cas étrange que les courbes de news en dessous soient identiques), comme le montre ce gif animé (créé avec le simplissime UnFreez) :
Attention donc si vous réutilisez un des mots ci-dessus comme référence, ne vous contentez pas de retenir la valeur du pic, ni même son positionnement, mais vérifiez en tentant de superposer la courbe de référence fournie sur ce billet, que la courbe de référence de l'image que vous voulez utiliser est bien à la même échelle, et tentez de corriger si ce n'est pas le cas.
- l'échelle reste relative, et pour en obtenir une absolue il faudrait savoir à combien de recherches Google exactement correspond 1 foo ? Toute idée de méthodologie pour connaître cette valeur est la bienvenue, pour l'instant la seule solution que j'aurais serait de créer un buzz artificiel de recherches Google, par un programme qui, un certain jour, à une certaine heure, irait rechercher un terme sur Google, et visiter une "page compteur" qui recenserait ainsi le nombre total de recherches Google sur ce terme. Encore faudrait-il avoir assez de volontaires qui accepteraient d'installer le programme, et je ne suis pas Vijay Pande... En attendant je peux remarquer que la courbe pour M6 direct a atteint 0,5 foo en février, alors que mon blog recevait environ 500 visites hebdomadaires pour ces mots-clé (pour lesquels je suis bien positionné). Bref, pour qu'un pic soit mentionné par Google Trends il faudrait cibler sur plus d'un millier de participants...


Ajout du 10/03 : je me rends compte que j'aurais peut-être dû mentionner, à propos de cette unité "foo", que le nombre de recherches auquel elle correspond est variable avec le temps. En effet les courbes Google Trends représentent une proportion des recherches sur certains termes par rapport à toutes les recherches Google. Ceci explique d'ailleurs la valeur impressionnante en foo de "Jackson". Par rapport au nombre total d'utilisateurs de Google en 2004 effectivement le buzz a été énorme, mais difficile de comparer de façon absolue en nombre de recherches 5700 foo de 2004 avec 800 foo de 2008... à moins que là aussi on puisse bricoler quelque chose ? Récupérer l'évolution du nombre de visiteurs ou de recherches Google depuis 2004, utiliser les courbes Alexa... à voir.


This post is translated to English: Reverse engineering Google Trends (1).

Fichiers source : les courbes Google Trends de chaque mot sont liées ci-dessus, voilà le fichier tableur qui a servi au calcul des valeurs en foo (attention c'est un fouillis monstre, plus de détails dans le prochain billet).

27 janvier 2008

Danger : accidents mortels !

Je ne connais pas du tout la blogosphère américaine (d'ailleurs, commencer à publier en anglais est aussi un moyen, j'espère, d'en récupérer quelques échos) mais il y a un blog anglophone que je visite régulièrement, xkcd, recueil de vignettes de BD tordantes... pour un public plutôt initié (comprenez : aussi geek que son auteur Randall Munroe, à l'origine d'autres jolis coups).

J'ai particulièrement apprécié une des dernières vignettes, qui fait appel aux nombres de résultats Google, comme ça m'est déjà arrivé sur ce blog pour l'orthographe, la célébrité des députés, ou la date de naissance du web :

Activités dangereuses
Indexées par le nombre de résultats Google pour
"mort dans un accident de ..."

Type d'accident - Résultats Google
parachutisme - 710
ascenseur - 575
surf - 496
skateboard - 473
camping - 166
jardinage - 100
patinage - 94
couture - 7
blogage - 2

Cette vignette a créé une Google Bomb slashdottée en faisant exploser le nombre de réponses pour "died in a blogging accident". L'expression avait bien sûr marqué les esprits de tous les blogueurs, qui ont repris la vignette en ajoutant les résultats de leurs propres recherches Google sur le sujet. On peut voir sur ce site ou dans le forum xkcd de nombreuses tentatives pour trouver la perle rare de l'activité dangereuse originale.

Sauf que la langue anglaise a un avantage sur le français : elle exprime ses noms d'activités par des verbes au participe présent. Là vous commencez à voir où je veux en venir, et si on envoyait carrément à Google tous les verbes anglais, pour qu'il nous dise lequel est le plus accidentogène ? Comment le faire techniquement ?

Première étape, récupérer une liste de tous les verbes anglais. Pas évident, comme en témoignent cette question Google Answers pleine de liens morts, ou ces 5 pages de réponses inutiles ou périmées de forumeurs... Bref, je me suis résolu à faire confiance à mon moteur de recherche préféré, en lui envoyant une liste de tous les verbes qui me sont passés par la tête. Manque de chance, elle renvoyait naturellement des dictionnaires complets, j'interdis donc d'un nom commun, hat, et en troisième page pour -hat strike give abandon wipe rub search seek hang eat adjust draw conclude reappear reconsolidate create destroy dream cut put drive, j'arrive enfin à une page du projet VerbNet qui présente plus de 3500 fichiers nommés par des verbes, plus quelques intrus. Même si on peut faire mieux, je m'en suis contenté...

Deuxième étape, générer les participes présents. Verbe + ing ? Oui mais il y a quelques subtilités, en fonction des dernières lettres de l'infinitif ! Heureusement que mon logiciel de tableur préféré me permet de coder quelques bouts de programmes, voilà la formule magique pour le "calcul" des participes présents (histoire de ne pas me perdre dans les parenthèses, je l'ai séparée en plusieurs cellules dans mon fichier tableur, mais pour le fun je la mets en un seul morceau) :
B1=IF(RIGHT(A1;1)="e";=IF(LEFT(RIGHT(A1;2);1)="i";CONCATENATE(LEFT(A1;LEN(A1)-2);"ying");CONCATENATE(LEFT(A1;LEN(A1)-1);"ing"));=IF(OR(RIGHT(A1;1)="d";RIGHT(A1;1)="g";RIGHT(A1;1)="m";RIGHT(A1;1)="n";RIGHT(A1;1)="p";RIGHT(A1;1)="t");=IF(OR(LEFT(RIGHT(A1;2);1)="a";LEFT(RIGHT(A1;2);1)="e";LEFT(RIGHT(A1;2);1)="i";LEFT(RIGHT(A1;2);1)="o";LEFT(RIGHT(A1;2);1)="u");=IF(OR(LEFT(RIGHT(A1;3);1)="a";LEFT(RIGHT(A1;3);1)="e";LEFT(RIGHT(A1;3);1)="i";LEFT(RIGHT(A1;3);1)="o";LEFT(RIGHT(A1;3);1)="u";AND(LEFT(RIGHT(A1;2);1)="e";RIGHT(A1;1)="n"));CONCATENATE(A1;"ing");CONCATENATE(A1;RIGHT(A1;1);"ing"));CONCATENATE(A1;"ing"));CONCATENATE(A1;"ing")))

Allez, une petite explication rapide. Si la dernière lettre est un "e", alors :
  • si l'avant-dernière est un "i", je transforme en "ying" (die -> dying)
  • sinon, je supprime le "e" et ajoute "ing" (love -> loving)
sinon :
  • si le verbe se termine par "en", j'ajoute simplement "ing" (sharpen -> sharpening)
  • sinon, si l'avant-dernière est un "d", "g", "m", "n", "p", "t", je vais la doubler si elle est précédée par une voyelle qui n'est pas précédée par une voyelle (bid -> bidding, put -> putting, mais claim -> claiming, feed -> feeding)
  • sinon, j'ajoute simplement "ing" (speak -> speaking)
J'ai créé ces règles intuitivement, en fait pour le doublement de la consonne finale, il faut vérifier si la dernière syllabe est accentuée, ma version a un très petit nombre d'exceptions, je n'ai identifié que des verbes se terminant par "on" (abandon -> abandoning, alors que con -> conning est correct).

Dernière étape, entourer chaque participe à gauche par "died in a (ou "died in an si le verbe commence par une voyelle) et à droite par accident", et envoyer chaque expression ainsi créée à Google, en utilisant FuryPopularity. J'en ai profité pour mettre le programme à jour, parce que Google a changé le style de ses résultats, et apparemment durci sa politique de détection de spam de requêtes : au bout de 200 requêtes envoyées toutes les 5 secondes, le moteur m'a empêché de continuer, et m'a débloqué seulement après captcha. En laissant une dizaine de secondes, ça passe. Je suis preneur de toute information sur leur algorithme de détection : se fonde-t-il seulement sur la fréquence (si oui, ils doivent identifier les proxys générateurs de nombreuses requêtes, non ?) ou sur la périodicité des requêtes, ou encore les actions effectuées suite aux requêtes ?

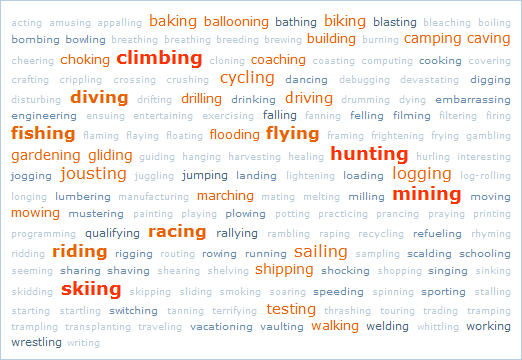
Voici le nuage brut de mots trouvés :
En analysant avec précaution ceux qui apparaissent moins fréquemment, on ne tombe malheureusement pas que sur des prétendants aux Darwin Awards. Tout d'abord, quelques parasites issus des réactions au dessin de xkcd, ou des décès d'animaux, mais aussi des choses plus gênantes : des adjectifs (amusing, embarrassing, interesting...) et des verbes n'indiquant pas une activité, mais plutôt des circonstances (exploding, crushing, choking...). Pour ces derniers, je n'ai pas de solution. On peut en revanche enlever les adjectifs verbaux assez facilement de façon automatique. Bien sûr, c'est possible en utilisant un analyseur syntaxique, voire un dictionnaire, mais je préfère rester dans l'utilisation des nombres de résultats Google.

J'ai fait plusieurs essais avant de trouver le critère discriminant. Comparer la fréquence de la forme participe présent par rapport à celle de l'infinitif (en espérant que ce soit plus élevé pour les adjectifs verbaux), ou trouver les pourcentages d'apparition du participe présent just après l'article "a", "more", ou "most". Dans le graphique ci-contre, les 5 premiers verbes donnent naissance à des adjectifs verbaux (amusant, effrayant, choquant, intéressant, dérangeant). On y voit que la stratégie du "a" ne fonctionne pas en particulier à cause des participes présents utilisés en anglais dans des mots composés : "a frying pan", une poële à frire, explique que "a frying" apparaisse si fréquemment. En revanche pas de contrexemple dans cette liste-test pour le superlatif avec "most" qui permet apparemment de faire la distinction (en fait la méthode laisse passer deux intrus : "ensuing" et "seeming" dans cette liste d'une centaine de verbes) :

Bref, une fois ce petit filtrage effectué, on peut regarder non seulement la fréquence de "died of a ... accident", mais aussi la comparer avec la fréquence de "a ... accident", ainsi que la popularité de l'activité elle-même, pour obtenir des sortes de taux d'accident (en bleu) et taux de mortalité (en rouge) :Et voilà ! Si votre activité favorite n'est pas dans la liste, vous avez au moins une base de comparaison pour tester sa dangerosité. Et si elle y est, faites attention à vous (surtout ceux qui ont prévu une petite joute équestre pour le weekend prochain...), mais ne vous inquiétez pas trop quand même, vous gardez aussi vos chances avec la bonne vieille tumeur ou la crise cardiaque !


This post is translated to English: Danger: deadly hobbies!
Et comme d'hab, les fichiers source : liste de plus de 3000 verbes anglais et la construction automatisée de leur participe présent, test des méthodes de détection des adjectifs verbaux, résultats des requête Google.

16 janvier 2008

Britney-Amy : duel mortel

Découverts grâce au Petit Journal de Canal + la semaine dernière, les sites WhenWillAmyWinehouseDie.com et WhenIsBritneyGoingToDie.com proposent un concept intéressant : pronostiquer la date de décès des deux divas, le plus proche gagnera qui un iPod Touch, qui une PS3. Buzz énorme, bien sûr, des milliers d'internautes se sont rués pour participer, laissant un petit messages de pré-condoléances au passage. Les deux sites sont évidemment optimisés pour récupérer des revenus publicitaires (contrairement à l'initiative plus confidentielle mais tout aussi "sympathique" du TopMort), et communiquent seulement les données brutes entrées par les signataires.

Il manquait donc un peu d'analyse de tous ces pronostics. Grâce à la formidable assistance de Matthieu Muffato, expert en domptage de Python, quelques lignes (de code) et quelques heures (d'exécution du programme) après que je lui aie parlé du problème, il m'envoyait son source avec les données récupérées.

La question que je m'étais initialement posé sur les pronostics était simple : quel est l'intervalle de temps le plus grand qui est encore libre, et permettant donc de maximiser a priori les chances de gagner ? A priori, c'est à dire en considérant que tout intervalle de temps d'une même durée est uniformément dangereux pour Amy et Britney, et uniformément choisi par les autres internautes.

Pas de chance, ces conditions idéales sont loin d'être vérifiées en pratique, pour une raison finalement toute simple : l'internaute veut gagner son iPod ou sa PS3 maintenant, et pas dans 30 ans ! Donc si vous voulez cibler pour le décès de votre Britney préférée un mois qui n'a encore pas été choisi par les autres visiteurs, il faudra attendre février 2023 ! Pour Amy, il y a eu moins de participants, donc si rien n'a changé depuis la récupération des données, novembre 2016 est encore libre, ou alors tenter l'année 2031, dont seul le mois d'octobre a été choisi. Je dois aussi préciser, comme Matthieu me l'a fait remarquer, qu'aucune date n'est enregistrée sur ces sites après janvier 2038, à cause probablement du codage des dates. Bref, passons aux choses "sérieuses", voilà un petit aperçu du nombre de pronostic par mois (avec simple renormalisation verticale pour Amy qui a reçu moins de votes) :
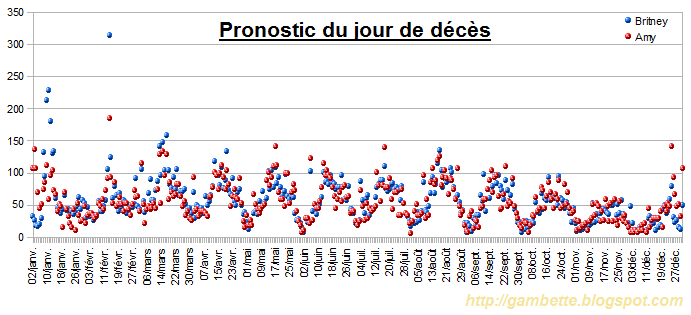
J'imagine que vous êtes aussi ahuris que je le fus quand les courbes sont apparues : elles sont quasiment identiques ! Coefficient de corrélation de 0.98, on obtient la même loi de puissance. Alors c'est l'occasion de faire un petit intermède mathématique. Pour détecter ce type de loi, on fait un tracé log/log des valeurs (c'est à dire on applique une fonction logarithmique aux abscisses, et aux ordonnées, pour afficher les points de coordonnées (log x,log y)) et on doit obtenir une droite. A vue d'oeil elle a à peu près pour équation Y=4-3X, c'est à dire quand on quitte le repère log/log et qu'on revient au linéaire : log10 y = 4-4/3 log10 x, et enfin y = 10 000 - x^(4/3), ce qui est l'équation de la courbe bleue.

En fait les lois de puissances arrivent très régulièrement dans les analyses de données réelles (en particulier de nombreux graphes petit monde ont une distribution des degrés en loi de puissance). Ce qui est remarquable est qu'ici les deux lois ont à peu près les mêmes paramètres. En regardant en détail on se rend quand même compte que les internautes ont plutôt privilégié 2008 pour Britney (qui semblait vraiment être au plus bas en ce début d'année) et 2009 pour Amy.

En regardant précisément les courbes, ont peut aussi noter une apparente périodicité. En tout cas elles ne sont pas monotones, et une représentation des proportions de pronostics de chaque mois dans l'année pour Miss Winehouse donne la courbe des pourcentages à gauche. Les variations sont étonnantes, entre novembre et août, on passe du simple au double ! Je n'ai pas d'explication a priori sur les choix réduits des mois de novembre, décembre, et février, peut-être que c'est un mécanisme similaire à celui que décrit Knuth dans un de ses premiers exos du tome 2 : demandez à un ami (ou un ennemi) un chiffre aléatoire, vous obtiendez plus souvent le nombre 7.

Pour en finir avec les chiffres, la représentation des pronostics par jour, toutes années confondues. J'ai enlevé le premier janvier qui était artificiellement haut à cause du problème du codage des années, qui a donné énormément de 01/07/1970.
Là à nouveau un phénomène de périodicité étonnant, les joueurs préfèrent visiblement les milieux de mois. Notez l'esprit retors qui fait apparaître aussi haut le 14 février, surtout pour la pauvre Britney. Même le point de son anniversaire le 2 décembre apparaît anormalement haut par rapport à ses voisins...

Alors pour oublier tout ça terminons sur une note de recueillement, d'émotion et de poésie, avec les nuages de mots des pré-condoléances pour les deux stars.
This post is translated to English: Britney-Amy, Celebrity Deathmatch.
Fichier tableur des pronostics par jour, par mois, autres fichiers source fournis sur demande, à moins que je les mette ici un jour.

2 janvier 2008

Comparer les courbes de buzz avec le CaptuCourbes

Il y a un peu plus d'un an, alors que le candidat Bayrou commençait à faire buzzer la blogosphère, j'avais essayé de comparer plusieurs outils de mesure de buzz pour évaluer le bruit des trois principaux candidats sur le web, dans la presse, et dans les blogs. Une suite de décalquages et dilatations manuelles avait permis d'aboutir à une juxtaposition expressive mais peu satisfaisante, et j'avais commencé à réfléchir à un outil permettant de récupérer les valeurs d'une image de courbe. J'y avais réfléchi un peu plus fort à la fin de ma compilation manuelle des courbes de sondages du premier tour des présidentielles. Des outils permettant de numériser des courbes sont recensés sur cette page, mais la plupart ont disparu ou sont payants. Le premier, Engauge Digitizer, est très appétissant (logiciel libre, multi-plateformes, reconnaissance automatique de courbes), mais s'avère un peu lourd, et fournit un fichier avec une liste des points identifiés, aux coordonnées réelles, alors qu'on préfère dans un tableur avoir une liste de points aux abscisses entières et d'écart constant, pour reconstituer le graphique.

Bref, voilà un petit utilitaire libre (pour Windows) pour transformer une image de courbe en tableau ouvrable dans Excel ou OpenOffice, le CaptuCourbe ! L'idée est que vous allez lui indiquer la couleur de la courbe à récupérer, fixer l'échelle horizontale et verticale, ainsi que le pas de discrétisation, c'est à dire l'intervalle horizontal entre les points à récupérer. Cette démarche assez intuitive est détaillée dans le tutoriel du CaptuCourbe. Pour certaines images, la couleur de la courbe n'est pas uniforme, il suffira de la traiter en augmentant le contraste (un petit coup d'enhance colors dans le petit IrfanView par exemple), par exemple, pour diminuer le nombre de couleurs. Pensez aussi que la ou les couleurs de la courbe ne doivent pas être présentes dans le reste de l'image, si c'est le cas, il faudra penser à effacer les parties parasites.

Une petite mise en application du logiciel ? J'ai récupéré et réuni (fichier OpenOffice ici) les données de graphiques de suivi de buzz pour les deux informations qui ont fait vibrer la toile fin décembre :
La première courbe a été choisie comme référence, les autres du même buzz ont été dilatées de sorte que leur moyenne sur la période du 17 au 19 décembre (le premier pic) soit identique. On remarque une grande uniformité des courbes sur le premier sujet, qui a plus fait causer sur les blogs que le second. Pour ce dernier, on peut noter l'énorme pic de recherche Google par rapport au buzz sur les blogs, le phénomène est expliqué ici.

Les outils sur les blogs donnent des courbes très similaires, bien que leurs bases soient de taille différente : Technorati revendique une base de 112 millions de blogs, 69 millions pour BlogPulse, et 17 millions pour BlogScope. Si l'on compare plus finement les trois courbes, BlogPulse apparaît toujours un peu en retard, de moins de 24h en tout cas (certainement une différence sur l'heure de début de la journée). BlogScope semble montrer des pics plus marqués, peut-être que leur base plus petite contient plutôt les blogs influents et toujours premiers sur les scoops, et moins les petits qui relaient l'info avec quelques heures de retard.

J'ai choisi d'ajouter les graphiques de Trendio, sorte de bourse aux mots clés ou aux noms de personnalités, qu'on pourrait penser un bon indicateur de buzz. Ce n'est pas vraiment le cas, les courbes sont beaucoup moins nerveuses que ce qu'on pourrait attendre, parasitées par l'incertitude des investisseurs...

Absent de cette comparaison, l'outil de veille2com, le Sous-Marin Jaune. En effet les requêtes dont les résultats ont été publiés ne correspondaient pas exactement à celles que j'ai utilisées dans la comparaison ci-dessus, et l'outil se semble pas être accessible au public. C'est d'ailleurs tout à fait regrettable : même si je comprends que ScanBlog préfère monnayer ses outils de suivi de buzz, en laisser une partie en accès public permettrait non seulement d'en faire parler, mais éventuellement de montrer la valeur ajoutée par rapport aux autres outils de suivi de la blogosphère cités ci-dessus (si les courbes obtenues montraient des tendances différentes par exemple). Enfin, l'ouverture partielle aux internautes permettrait de récupérer leurs requêtes pour constituer une base de données des intentions, ce qui devrait intéresser une entreprise dédiée au suivi des buzz.

19 octobre 2007

Dissection d'une pétition (1)

De retour après avoir passé du temps à l'Inathèque, déménagé, commencé ma thèse, et préparé mes premiers enseignements, me voilà prêt à décortiquer un nouveau phénomène viral, après la F-list, la pétition "Touche pas à mon ADN".

Là malheureusement, on n'a pas autant d'informations sur la transmission du phénomène que pour les F-lists, mais on va essayer de tirer quelques conclusions à partir de la jolie base de plus de 200 000 signataires disponibles sur le site TouchePasAMonAdn.com. Première difficulté, récupérer la base de données, qui est répartie en plusieurs feuilles de 400 noms. Pour ça j'ai mon "aspirateur" personnel, qui visite les pages voulues en extrayant les informations utiles du code HTML des pages. Une petite difficulté supplémentaire : la liste se met à jour pendant l'aspiration, il a donc fallu mettre en place a posteriori une détection automatique des signataires qui avaient été enregistrés deux fois : en fin de page et en début de page suivante. Ca paraît relativement simple, hein ? Sauf que la tâche se complique quand les organisateurs décident de nettoyer leur base de signataires d'avant le 11 octobre, en réorganisant au passage de façon apparemment aléatoire (rangée ni dans l'ordre alphabétique, ni chronologique) la liste des signatures avant cette date.

Alors pourquoi une telle réorganisation ? Tout d'abord, à cause des signataires qui cliquent mal : beaucoup de doublons apparaissent dans la liste brute. Ensuite, à cause des petits rigolos qui font des blagues. En voilà un petit florilège (vous vous rappelez des Zidane et Chirac d'Unitaid ?), attention la finesse n'est pas toujours au rendez-vous...

04 octobre 2007, 02:15;nicolas sarkozy;nabot présidentiel (république bananière);
04 octobre 2007, 12:29;Nicolas Sarkozy;;
04 octobre 2007, 13:01;Nicolas Sarkozy;Président de rien du tout;
04 octobre 2007, 14:54;NICOLAS SARKOZY;président (france);
04 octobre 2007, 17:43;Nicolas Sarkozy;Président (aucune);
04 octobre 2007, 18:38;nicolas sarkozy;président;
04 octobre 2007, 20:52;Nicolas Sarkozy de Nagy Bocsa;Président, enfin... je crois;
16 octobre 2007, 08:36;nicolas sarkozy;président des francais;
03 octobre 2007, 11:00;brice hortefeux;schizophrène (Dictature Sarkozyenne);
03 octobre 2007, 11:52;BRICE Hortefeux;Fuhrer (République Francaise);
03 octobre 2007, 13:41;hortefeux brice;raciste 2nd;
03 octobre 2007, 17:12;Brice HORTEFEUX;;
03 octobre 2007, 17:28;Brice Hortefeux;Face de pet;
03 octobre 2007, 21:47;BRICE HORTEFEUX;ministre de la betise;
03 octobre 2007, 22:50;Brice Hortefeux;futur ex-Ministre;
03 octobre 2007, 23:13;Brice Hortefeux;;
04 octobre 2007, 16:12;brice hortefeux;;
04 octobre 2007, 16:13;Brice HORTEFEUX;Ministre (SARKOLAND);
16 octobre 2007, 12:16;brice hortefeux;;
03 octobre 2007, 21:59;Thierry Mariani;Député cocu;
03 octobre 2007, 18:48;thierry mariani;député (bientôt chômeur);
12 octobre 2007, 15:04;Thierry Mariani;député;
13 octobre 2007, 21:04;THIERRY MARIANI;MINISTRE : vous êtes tous des rigolos !;
03 octobre 2007, 10:53;GEORGES BUSH;u want2fukme;
03 octobre 2007, 22:22;jorge bush;rongeur (otan);
04 octobre 2007, 15:37;georges bush;;
04 octobre 2007, 23:30;GEORGES BUSH;USA;
13 octobre 2007, 22:54;Debeuliou Bush;President of the United-States of America;
16 octobre 2007, 06:33;georges bush;;
12 octobre 2007, 18:49;François Mitterrand;Illusionniste;
13 octobre 2007, 17:41;Chirac Bernadette;Pute des routes;
16 octobre 2007, 10:57;Jacques Chirac;ancien Président de la République;
03 octobre 2007, 11:35;zidane zinedine;retraité;
03 octobre 2007, 18:05;Zinedine Zidane;ancien footballeur;
03 octobre 2007, 22:50;zidane zinedine;footballeur;
03 octobre 2007, 23:23;zinedine zidane;footballer (OM);
04 octobre 2007, 23:27;Zinédine Zidane;Footballeur retraité;
15 octobre 2007, 18:38;Zinedine Zidane;retraitée du sport (les pervers);
15 octobre 2007, 19:06;Bernard Kouchner;National Socio-traitre (Nazie) (Heil Hitler !);
04 octobre 2007, 23:32;KOUCHNER Bernard;Extérieur du Ministère;
16 octobre 2007, 09:26;Francois Bayrou;Clown;
04 octobre 2007, 10:35;fadela amara;traitre (ump);
17 octobre 2007, 07:20;test test;test (test);
17 octobre 2007, 07:17;Kipeutebattre croustibat;poisson pané (findus);
16 octobre 2007, 02:02;Kylie Minogue;Chanteuse;


Depuis, certains de ces noms ont disparu : les Sarkozy et Hortefeux d'avant le 11 octobre. Il reste les Zidane. J'imagine donc qu'une certaine partie du tri a été faite manuellement (pour automatiser un peu tout ça je suggérerais de classer les signataires par ordre alphabétique et vérifier les groupes de personnes qui ont le même nom et prénom, ou encore d'utiliser FuryPopularity sur les noms de tous les signataires pour identifier les noms connus... et donc suspects). La partie automatique de suppression des répétitions a visiblement été efficace, puisqu'elle a fait passer le nombre de signataires du 4 octobre de 41000 à 33000 environ, pour le 3 octobre de 30000 à 28000. L'ordre de grandeur est toutefois respecté, ce qui peut rassurer les quelques visiteurs étonnés par ces doublons.

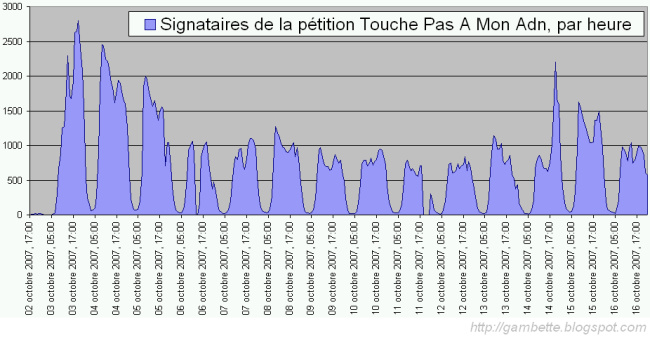
Bref, même si la récupération de la base n'est pas immédiate, elle est possible, et je l'ai bien vite enregistrée en supprimant les données nominatives, gardant seulement l'heure et la profession pour chaque signataire. La profession, je la garde en réserve pour la deuxième et la troisième partie de ce billet, regardons seulement l'évolution des signatures pendant la première quinzaine de la pétition :
Remarquons d'abord le joli démarrage, qui doit laisser rêveur tout adepte de marketing sur internet... Est-ce que la "qualité du produit" a suffi à attirer une telle foule ? Quels ont été les relais publicitaires pour faire connaître le site aussi vite ? Médias traditionnels, bouche à oreille, blogs, mails ? S'il n'est pas évident de le déterminer (le décollage commence à 8h du matin !), on peut en revanche remarquer une forte corrélation entre le nombre de billets de blogs citant la pétition, ou son adresse, et le nombre de signataires :
Notre tableur préféré nous donne un coefficient de corrélation de 0.80 entre le nombre de signataires et le nombre de billets quotidiens contenant "Touche pas à mon ADN" d'après Blogsearch, 0.76 avec le nombre de ceux qui contiennent le lien vers touchepasamonadn.com. Remarquons aussi que les deux courbes Blogsearch très proches avant le 13 octobre divergent ensuite. Pourquoi ?

La clé de l'énigme, c'est le meeting concert Touche pas à mon ADN, dont les gens ont visiblement parlé sur leur blog sans donner l'adresse de la pétition. Toutefois l'événement a eu un retentissement médiatique qui se visualise très bien le 14 octobre au soir avec deux pics de signatures vers 19h50 et 20h20, et qui redonne de l'énergie au nombre de signatures par heure.

Enfin vous aurez noté sur le graphique de l'évolution des signatures deux interruptions du site, le 11 octobre au soir, et le 6 octobre avant 17h. Il semble tout de même avoir tenu le coup aux moments les plus critiques.

Pas encore efficace, cette pétition montre toutefois quelques conditions nécessaires pour un succès. Un relai médiatique, une solide structure technique pour accueillir les signatures voire vérifier leur authenticité. Où s'arrête l'initiative populaire et où commence le lobbying super organisé et forcément bien financé ? En attendant de telles initiatives permettent au moins de maintenir une certaine vigilance... et nous donner des indications sur les horaires de surf des étudiants, des enseignants, des retraités, des chercheurs, des ingénieurs. A suivre très bientôt, dans le prochain billet !

1 octobre 2006

Quand la loi de Zipf atteint le nombre des années...

J'ai étudié le nombre de résultats Yahoo (parce qu'on sait bien que Google pour faire des stats c'est mââl) pour tous les nombres à 4 chiffres entre 1901 et 2006, et la loi de Zipf semble pointer le bout de son nez. En effet le nombre de résultats n(x) semble inversement proportionnel au nombre x recherché. Pour visualiser cela un peu mieux, je trace non pas la courbe de n(x), mais celle de 1 000 000 000/n(x), en pensant obtenir à peu de choses près une droite. Au passage, je ne représente pas les valeurs pour x divisible par 10, puisque ces nombres sont généralement beaucoup plus présents sur le web que leurs voisins, et créent donc du bruit dans les données obtenues (du bruit, étant donné l'utilisation qu'on veut en faire, cf ci-dessous). Voilà le résultat obtenu, avec en violet la droite de régression linéaire de ces points (merci OpenOffice Calc) :

On peut remarquer que globalement, les points sont bien proches de cette droite, à part après 2006. Mais en zoomant un peu plus, on voit que le comportement diffère entre 1995 et 2006. C'est donc plutôt deux segments de droite qui semblent décrire le mieux les valeurs obtenues, entre 1901 et 2006.

Je m'attendais à visualiser plus clairement certaines "années clé", comme 1914, 1918, 1939, 1945... C'est en effet le cas pour 1945 qu'on voit plus bas que prévu (étant plus cité sur le net que 1944 ou 1946), ou 1901 (vive la loi sur les associations !).

Bon, et maintenant, quelle utilité à cette remarque ? Eh bien justement à évaluer la pertinence des résultats chiffrés des moteurs de recherche pour faire des statistiques. Il s'agira tout d'abord de déterminer expérimentalement quelle loi semble la plus correcte (par exemple : il y a forte corrélation entre 1/x et le nombre de pages sur internet contenant le nombre x pour x allant de 1901 à 1994, avec x non divisible par 10). Si ça semble effectivement être le cas sur tous les moteurs, le coefficient de corrélation trouvé permettrait d'évaluer la qualité du moteur pour une utilisation statistique (notamment de calcul de la NGD).