27 janvier 2008

Danger : accidents mortels !

Je ne connais pas du tout la blogosphère américaine (d'ailleurs, commencer à publier en anglais est aussi un moyen, j'espère, d'en récupérer quelques échos) mais il y a un blog anglophone que je visite régulièrement, xkcd, recueil de vignettes de BD tordantes... pour un public plutôt initié (comprenez : aussi geek que son auteur Randall Munroe, à l'origine d'autres jolis coups).

J'ai particulièrement apprécié une des dernières vignettes, qui fait appel aux nombres de résultats Google, comme ça m'est déjà arrivé sur ce blog pour l'orthographe, la célébrité des députés, ou la date de naissance du web :

Activités dangereuses
Indexées par le nombre de résultats Google pour
"mort dans un accident de ..."

Type d'accident - Résultats Google
parachutisme - 710
ascenseur - 575
surf - 496
skateboard - 473
camping - 166
jardinage - 100
patinage - 94
couture - 7
blogage - 2

Cette vignette a créé une Google Bomb slashdottée en faisant exploser le nombre de réponses pour "died in a blogging accident". L'expression avait bien sûr marqué les esprits de tous les blogueurs, qui ont repris la vignette en ajoutant les résultats de leurs propres recherches Google sur le sujet. On peut voir sur ce site ou dans le forum xkcd de nombreuses tentatives pour trouver la perle rare de l'activité dangereuse originale.

Sauf que la langue anglaise a un avantage sur le français : elle exprime ses noms d'activités par des verbes au participe présent. Là vous commencez à voir où je veux en venir, et si on envoyait carrément à Google tous les verbes anglais, pour qu'il nous dise lequel est le plus accidentogène ? Comment le faire techniquement ?

Première étape, récupérer une liste de tous les verbes anglais. Pas évident, comme en témoignent cette question Google Answers pleine de liens morts, ou ces 5 pages de réponses inutiles ou périmées de forumeurs... Bref, je me suis résolu à faire confiance à mon moteur de recherche préféré, en lui envoyant une liste de tous les verbes qui me sont passés par la tête. Manque de chance, elle renvoyait naturellement des dictionnaires complets, j'interdis donc d'un nom commun, hat, et en troisième page pour -hat strike give abandon wipe rub search seek hang eat adjust draw conclude reappear reconsolidate create destroy dream cut put drive, j'arrive enfin à une page du projet VerbNet qui présente plus de 3500 fichiers nommés par des verbes, plus quelques intrus. Même si on peut faire mieux, je m'en suis contenté...

Deuxième étape, générer les participes présents. Verbe + ing ? Oui mais il y a quelques subtilités, en fonction des dernières lettres de l'infinitif ! Heureusement que mon logiciel de tableur préféré me permet de coder quelques bouts de programmes, voilà la formule magique pour le "calcul" des participes présents (histoire de ne pas me perdre dans les parenthèses, je l'ai séparée en plusieurs cellules dans mon fichier tableur, mais pour le fun je la mets en un seul morceau) :
B1=IF(RIGHT(A1;1)="e";=IF(LEFT(RIGHT(A1;2);1)="i";CONCATENATE(LEFT(A1;LEN(A1)-2);"ying");CONCATENATE(LEFT(A1;LEN(A1)-1);"ing"));=IF(OR(RIGHT(A1;1)="d";RIGHT(A1;1)="g";RIGHT(A1;1)="m";RIGHT(A1;1)="n";RIGHT(A1;1)="p";RIGHT(A1;1)="t");=IF(OR(LEFT(RIGHT(A1;2);1)="a";LEFT(RIGHT(A1;2);1)="e";LEFT(RIGHT(A1;2);1)="i";LEFT(RIGHT(A1;2);1)="o";LEFT(RIGHT(A1;2);1)="u");=IF(OR(LEFT(RIGHT(A1;3);1)="a";LEFT(RIGHT(A1;3);1)="e";LEFT(RIGHT(A1;3);1)="i";LEFT(RIGHT(A1;3);1)="o";LEFT(RIGHT(A1;3);1)="u";AND(LEFT(RIGHT(A1;2);1)="e";RIGHT(A1;1)="n"));CONCATENATE(A1;"ing");CONCATENATE(A1;RIGHT(A1;1);"ing"));CONCATENATE(A1;"ing"));CONCATENATE(A1;"ing")))

Allez, une petite explication rapide. Si la dernière lettre est un "e", alors :
  • si l'avant-dernière est un "i", je transforme en "ying" (die -> dying)
  • sinon, je supprime le "e" et ajoute "ing" (love -> loving)
sinon :
  • si le verbe se termine par "en", j'ajoute simplement "ing" (sharpen -> sharpening)
  • sinon, si l'avant-dernière est un "d", "g", "m", "n", "p", "t", je vais la doubler si elle est précédée par une voyelle qui n'est pas précédée par une voyelle (bid -> bidding, put -> putting, mais claim -> claiming, feed -> feeding)
  • sinon, j'ajoute simplement "ing" (speak -> speaking)
J'ai créé ces règles intuitivement, en fait pour le doublement de la consonne finale, il faut vérifier si la dernière syllabe est accentuée, ma version a un très petit nombre d'exceptions, je n'ai identifié que des verbes se terminant par "on" (abandon -> abandoning, alors que con -> conning est correct).

Dernière étape, entourer chaque participe à gauche par "died in a (ou "died in an si le verbe commence par une voyelle) et à droite par accident", et envoyer chaque expression ainsi créée à Google, en utilisant FuryPopularity. J'en ai profité pour mettre le programme à jour, parce que Google a changé le style de ses résultats, et apparemment durci sa politique de détection de spam de requêtes : au bout de 200 requêtes envoyées toutes les 5 secondes, le moteur m'a empêché de continuer, et m'a débloqué seulement après captcha. En laissant une dizaine de secondes, ça passe. Je suis preneur de toute information sur leur algorithme de détection : se fonde-t-il seulement sur la fréquence (si oui, ils doivent identifier les proxys générateurs de nombreuses requêtes, non ?) ou sur la périodicité des requêtes, ou encore les actions effectuées suite aux requêtes ?

Voici le nuage brut de mots trouvés :
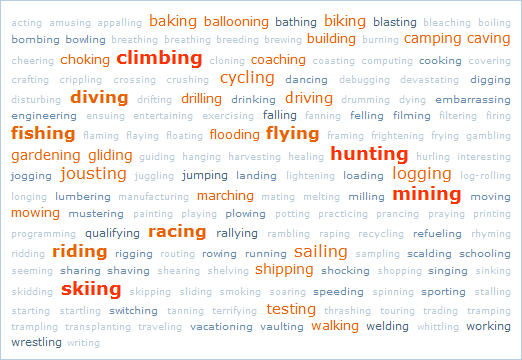
En analysant avec précaution ceux qui apparaissent moins fréquemment, on ne tombe malheureusement pas que sur des prétendants aux Darwin Awards. Tout d'abord, quelques parasites issus des réactions au dessin de xkcd, ou des décès d'animaux, mais aussi des choses plus gênantes : des adjectifs (amusing, embarrassing, interesting...) et des verbes n'indiquant pas une activité, mais plutôt des circonstances (exploding, crushing, choking...). Pour ces derniers, je n'ai pas de solution. On peut en revanche enlever les adjectifs verbaux assez facilement de façon automatique. Bien sûr, c'est possible en utilisant un analyseur syntaxique, voire un dictionnaire, mais je préfère rester dans l'utilisation des nombres de résultats Google.

J'ai fait plusieurs essais avant de trouver le critère discriminant. Comparer la fréquence de la forme participe présent par rapport à celle de l'infinitif (en espérant que ce soit plus élevé pour les adjectifs verbaux), ou trouver les pourcentages d'apparition du participe présent just après l'article "a", "more", ou "most". Dans le graphique ci-contre, les 5 premiers verbes donnent naissance à des adjectifs verbaux (amusant, effrayant, choquant, intéressant, dérangeant). On y voit que la stratégie du "a" ne fonctionne pas en particulier à cause des participes présents utilisés en anglais dans des mots composés : "a frying pan", une poële à frire, explique que "a frying" apparaisse si fréquemment. En revanche pas de contrexemple dans cette liste-test pour le superlatif avec "most" qui permet apparemment de faire la distinction (en fait la méthode laisse passer deux intrus : "ensuing" et "seeming" dans cette liste d'une centaine de verbes) :

Bref, une fois ce petit filtrage effectué, on peut regarder non seulement la fréquence de "died of a ... accident", mais aussi la comparer avec la fréquence de "a ... accident", ainsi que la popularité de l'activité elle-même, pour obtenir des sortes de taux d'accident (en bleu) et taux de mortalité (en rouge) :Et voilà ! Si votre activité favorite n'est pas dans la liste, vous avez au moins une base de comparaison pour tester sa dangerosité. Et si elle y est, faites attention à vous (surtout ceux qui ont prévu une petite joute équestre pour le weekend prochain...), mais ne vous inquiétez pas trop quand même, vous gardez aussi vos chances avec la bonne vieille tumeur ou la crise cardiaque !


This post is translated to English: Danger: deadly hobbies!
Et comme d'hab, les fichiers source : liste de plus de 3000 verbes anglais et la construction automatisée de leur participe présent, test des méthodes de détection des adjectifs verbaux, résultats des requête Google.

16 janvier 2008

Britney-Amy : duel mortel

Découverts grâce au Petit Journal de Canal + la semaine dernière, les sites WhenWillAmyWinehouseDie.com et WhenIsBritneyGoingToDie.com proposent un concept intéressant : pronostiquer la date de décès des deux divas, le plus proche gagnera qui un iPod Touch, qui une PS3. Buzz énorme, bien sûr, des milliers d'internautes se sont rués pour participer, laissant un petit messages de pré-condoléances au passage. Les deux sites sont évidemment optimisés pour récupérer des revenus publicitaires (contrairement à l'initiative plus confidentielle mais tout aussi "sympathique" du TopMort), et communiquent seulement les données brutes entrées par les signataires.

Il manquait donc un peu d'analyse de tous ces pronostics. Grâce à la formidable assistance de Matthieu Muffato, expert en domptage de Python, quelques lignes (de code) et quelques heures (d'exécution du programme) après que je lui aie parlé du problème, il m'envoyait son source avec les données récupérées.

La question que je m'étais initialement posé sur les pronostics était simple : quel est l'intervalle de temps le plus grand qui est encore libre, et permettant donc de maximiser a priori les chances de gagner ? A priori, c'est à dire en considérant que tout intervalle de temps d'une même durée est uniformément dangereux pour Amy et Britney, et uniformément choisi par les autres internautes.

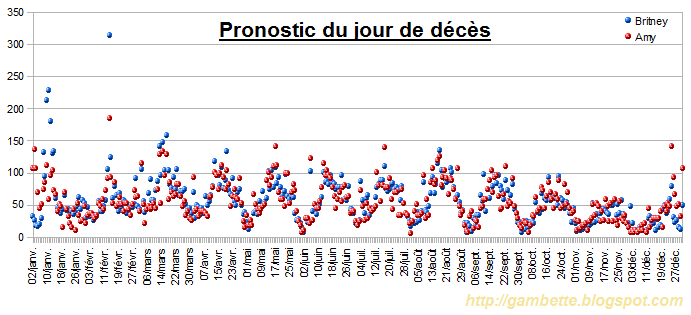
Pas de chance, ces conditions idéales sont loin d'être vérifiées en pratique, pour une raison finalement toute simple : l'internaute veut gagner son iPod ou sa PS3 maintenant, et pas dans 30 ans ! Donc si vous voulez cibler pour le décès de votre Britney préférée un mois qui n'a encore pas été choisi par les autres visiteurs, il faudra attendre février 2023 ! Pour Amy, il y a eu moins de participants, donc si rien n'a changé depuis la récupération des données, novembre 2016 est encore libre, ou alors tenter l'année 2031, dont seul le mois d'octobre a été choisi. Je dois aussi préciser, comme Matthieu me l'a fait remarquer, qu'aucune date n'est enregistrée sur ces sites après janvier 2038, à cause probablement du codage des dates. Bref, passons aux choses "sérieuses", voilà un petit aperçu du nombre de pronostic par mois (avec simple renormalisation verticale pour Amy qui a reçu moins de votes) :
J'imagine que vous êtes aussi ahuris que je le fus quand les courbes sont apparues : elles sont quasiment identiques ! Coefficient de corrélation de 0.98, on obtient la même loi de puissance. Alors c'est l'occasion de faire un petit intermède mathématique. Pour détecter ce type de loi, on fait un tracé log/log des valeurs (c'est à dire on applique une fonction logarithmique aux abscisses, et aux ordonnées, pour afficher les points de coordonnées (log x,log y)) et on doit obtenir une droite. A vue d'oeil elle a à peu près pour équation Y=4-3X, c'est à dire quand on quitte le repère log/log et qu'on revient au linéaire : log10 y = 4-4/3 log10 x, et enfin y = 10 000 - x^(4/3), ce qui est l'équation de la courbe bleue.

En fait les lois de puissances arrivent très régulièrement dans les analyses de données réelles (en particulier de nombreux graphes petit monde ont une distribution des degrés en loi de puissance). Ce qui est remarquable est qu'ici les deux lois ont à peu près les mêmes paramètres. En regardant en détail on se rend quand même compte que les internautes ont plutôt privilégié 2008 pour Britney (qui semblait vraiment être au plus bas en ce début d'année) et 2009 pour Amy.

En regardant précisément les courbes, ont peut aussi noter une apparente périodicité. En tout cas elles ne sont pas monotones, et une représentation des proportions de pronostics de chaque mois dans l'année pour Miss Winehouse donne la courbe des pourcentages à gauche. Les variations sont étonnantes, entre novembre et août, on passe du simple au double ! Je n'ai pas d'explication a priori sur les choix réduits des mois de novembre, décembre, et février, peut-être que c'est un mécanisme similaire à celui que décrit Knuth dans un de ses premiers exos du tome 2 : demandez à un ami (ou un ennemi) un chiffre aléatoire, vous obtiendez plus souvent le nombre 7.

Pour en finir avec les chiffres, la représentation des pronostics par jour, toutes années confondues. J'ai enlevé le premier janvier qui était artificiellement haut à cause du problème du codage des années, qui a donné énormément de 01/07/1970.
Là à nouveau un phénomène de périodicité étonnant, les joueurs préfèrent visiblement les milieux de mois. Notez l'esprit retors qui fait apparaître aussi haut le 14 février, surtout pour la pauvre Britney. Même le point de son anniversaire le 2 décembre apparaît anormalement haut par rapport à ses voisins...

Alors pour oublier tout ça terminons sur une note de recueillement, d'émotion et de poésie, avec les nuages de mots des pré-condoléances pour les deux stars.
This post is translated to English: Britney-Amy, Celebrity Deathmatch.
Fichier tableur des pronostics par jour, par mois, autres fichiers source fournis sur demande, à moins que je les mette ici un jour.

11 janvier 2008

Sarkozy l'Orateur (2) : décryptage de l'impro-Sarko

Je les avais promis dans mon dernier billet, mais je ne les donnerai pas, les nuages arborés des deux versions (prévue, et prononcée) du discours de conférence de presse de Sarkozy. Pourquoi ? Je suis toujours loin d'être satisfait des détails techniques de la construction de ces objets, et même si je suis convaincu qu'un système de consensus d'arbres permet de bien les comparer (tiens, on s'approche de mon sujet de thèse, là...), quand les arbres à comparer ne sont pas très fiables, ça ne fonctionne pas. Bref, pas de jolie visualisation à l'interprétation casse-gueule, mais plutôt un bon vieux traitement semi-automatisé des différences entre les deux textes.

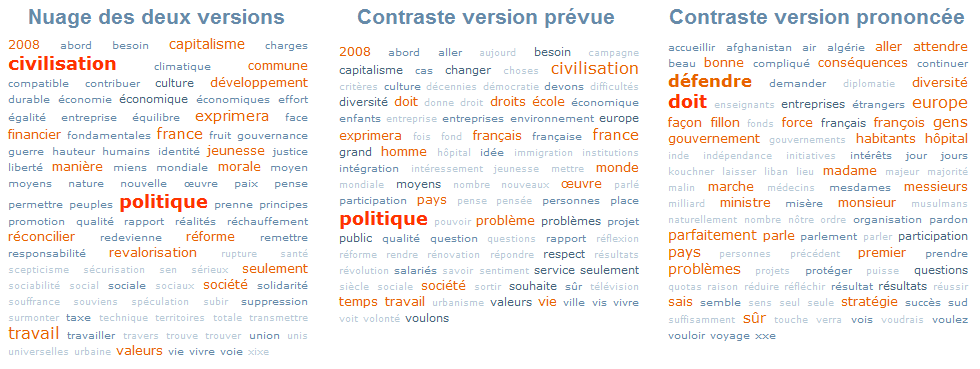
Nuages de mots des deux versions du discours de conférence de presse de SarkozyCommençons par la dynamique globale des changements. Je l'évoquais image à l'appui dans mon dernier billet, Sarkozy se lâche peu à peu dans son discours, et finit par improviser complètement en laissant de côté le texte prévu. Et à s'écarter des chemins balisés, on commet des erreurs. En particulier une de celles que j'adore, traque, et compile, une erreur d'accord de pronom relatif, dans sa forme la plus pure qu'est le "danlekel" invariable :

« Quelle est la ville dans lequel nous voulons vivre ? »
Dans le milieu du discours, on peut aussi noter une litote bien maladroite : "les enseignants sont plus victimes que coupables dans cette affaire" ! A moins qu'il faille vraiment prendre la phrase au pied de la lettre, et fustiger les enseignants coupables de ne pas passer leurs weekends à réparer et repeindre leur université... De même il est un peu cavalier en ajoutant qu'on ne parle jamais d'urbanisme pendant les campagnes politiques (hum, certes, ce sont des discours, pas des débats, dans Discours2007).

Maintenant voyons quels sont les thèmes des passages improvisés, et des passages supprimés (indiqués barrés) significatifs, ils expliquent bien sûr les mots mis en relief dans le nuage de mots "contrasté" de la version pronconcée :
Tous ces passages, c'est du pur Sarkozy. Pas de conseiller, pas de notes. Juste un freestyle présidentiel. Et là on peut se lancer dans l'analyse du style.

Malheureusement je n'ai pas les outils pour la détection et la mesure de l'anaphore. A vue de nez, j'ai quand même été tout à fait surpris d'en trouver un certain nombre ("comment..." ligne 112, "Paris doit" ligne 553, "L'Europe" ligne 844, "On aurait eu l'air malin" lignes 879 et 892, "Et bien sûr" ligne 1081...) dans les passages improvisés. Se serait-il donc converti au style Guaino, ou bien y a-t-il une autre explication ? Ils est de plus tout à fait frappant de noter à quel point elles sont renforcées à l'oral. Comme je l'expliquais, les retours à la ligne dans le texte prononcé indiquent des pauses dans le discours, et les anaphores arrivent toutes en début de ligne ! On peut aussi remarquer ligne 37 comment deux répétitions de "du respect" sont supprimées à l'oral, mais la suppression d'un "et" et une pause permettent de conserver la fonction rhétorique de l'anaphore.

Passons à une autre caractéristique du discours sarkozien : le pronom "je". Pour cela on fait mouliner le TagCloud Builder non pas sur les textes originaux, mais sur leurs listes contrastées et normalisées d'occurences de mots, ce que j'avais déjà fait sur les programmes du PS et de l'UMP (malheureusement cet outil de contraste est encore trop peu abouti pour le distribuer). J'ai pris bien soin pour une fois de laisser tous les mots dans le nuage, pronoms, conjonctions et interjections inclus, ce qui donne donc un aperçu du style oral de Sarkozy. Et les "je", alors ? Certes, le "j'" ressort, mais la fréquence des "je" est inférieure dans le texte prononcé par rapport au texte prévu ! Comptons les fréquences en détail (et c'est l'occasion de livrer une astuce pratique pour compter facilement le nombre d'occurences d'un mot dans un texte : ouvrez-le dans un éditeur ou traitement de texte, faites Rechercher/Remplacer, le mot éventuellement suivi d'un espace, par lui-même, choisissez Remplacer tout, et voilà la réponse !) : 14,99 fois pour 1000 mots dans le texte prononcé, contre 12,80 fois pour 1000 mots dans le texte prévu ! On a bien fait de ne pas s'arrêter à la première impression donnée par le nuage, et il ne pourra pas prétendre que ceux qui lui écrivent ses discours le forcent à se mettre en avant !

Dans le style familier à la Sarko, on peut noter le pronom "on", le "y" de "il y a" voire "y a", ou encore le "eh" de "eh ben" ou "eh bien". Au fait, vous vous rappelez du "naturellement" de Chirac ? Sarko préfère le "parfaitement" (fréquence d'environ 1 pour 1000 mots dans ce discours), ce qui semble aussi se confirmer avec ses discours de campagne.

Et pour finir sur le style Sarkozy, une remarque que je faisais dans le billet précédent et que je confirme aujourd'hui, l'emploi du verbe "épouser", deux fois à l'oral mardi, semble être conjoncturel (dans les discours recensés dans Discours2007 il apparaît moins de 0.1 pour 10 000 mots, contre plus d'une fois pour 10 000 ici).

Enfin, je l'ai omis dans mon dernier billet, je dois mentionner un outil qui m'a particulièrement aidé dans ma transcription : le Real Player Download & Recording Manager qui s'installe avec RealPlayer11 Basic (hein, mais ils font quoi, dans la blogsophère française ???), et qui propose de télécharger en un clic toutes les vidéos ou sons croisés sur internet. A quel point c'est légal ? Real n'est pas une petite boîte douteuse en tout cas, j'ai l'impression que comme Altavista, ce système va devenir un excellent assistant au piratage, pour initiés...


Ajout du 25 mars 2008 : et pour aller plus loin dans l'analyse du discours sarkozien, jetez-vous sur l'indispensable Les mots de Nicolas Sarkozy !

9 janvier 2008

Sarkozy l'Orateur (1) : version prévue et prononcée du discours de la conférence de presse

Devinette : du sketch de quel humoriste engagé sont tirées les lignes qui suivent ?

« Le G8, mais enfin qu'est-ce que c'est ? On se réunit deux jours et demi, sans la Chine, sans l'Inde, sans le Brésil, sans le Mexique, sans l'Afrique du Sud. Simplement, deux milliards et demi de gens qu'on oublie. Ah, alors évidemment, on les invite pour le déjeuner du troisième jour. Le plus extraordinaire c'est qu'ils viennent. »
Non, pas Bedos. Non, pas Dieudonné... Mais bien notre Président, dans la version prononcée de son discours de conférence de presse d'hier, que vous ne trouverez pas en PDF sur le site de l'Elysée.Un petit aperçu de la réaction du public, avec Morin et Kouchner, et un troisième que je ne reconnais pas, qui se bidonnent. Bon, en fait tout le discours n'était pas prononcé sur un style aussi décontracté, qui apparaissait seulement dans les impros de Nico sur le texte original.

Alors évidemment, c'est le texte original qui m'avait attiré tout d'abord, pour en faire le nuage arboré. Contrairement au discours de voeux, la version PDF sur le site de l'Elysée a un codage étrange qui m'empêche d'en récupérer le texte (si vous comprenez ce qui se passe, ou savez comment le récupérer quand même, ça m'intéresse beaucoup !), heureusement que Linternaute (je n'ai jamais dit tout le bien que je pense de ce site où on trouve absolument tout et n'importe quoi) est là pour me fournir un document exploitable. Malheureusement les différences avec le discours réellement prononcé sont importantes ! Ni une, ni deux, me voilà parti dans la transcription. Mon temps de sommeil en a un peu pâti, mais le résultat est là. Non seulement vous avez le texte, mais aussi une intuition sur sa prononciation, puisque je suis allé à la ligne à chaque pause. Les sauts de ligne indiquent seulement une différence thématique, ils correspondent à peu près aux sauts de paragraphe du discours prévu. Evidemment j'ai pu y glisser des erreurs ou omissions, n'hésitez pas à me les signaler...

Bon, et maintenant, jouons aux 7 différences entre les deux versions. Pour comparer deux fichiers j'utilise habituellement CompareIt qui essaie d'identifier des lignes entre fichiers (fichier du texte originalement prévu), et présente une visualisation plutôt bien faite de l'alignement effectué, la bande verticale sur la gauche. Pour un meilleur contraste, j'ai mis les lignes identiques en noir, celles ajoutées en vert, celles supprimées en rouge, et celles modifiées en bleu. CompareIt permet aussi d'exporter un rapport des différences avec les textes sur deux colonnes, que vous trouverez ici.

Peut être trouvez-vous plus lisible de voir sur un seul texte les deux versions, comme Jean Véronis l'avait fait pour le discours de Ségolène Royal à Villepinte. Pour cela j'ai utilisé Diff'Doc, qui est gratuit, voilà donc la synthèse des textes prévu et prononcé.

Evidemment ce document est une mine d'informations pour qui veut analyser le style oratoire de Sarkozy, puisqu'on y trouve à la fois ses longs passage d'improvisation, mais aussi ses petites corrections de détail, ou encore les passages qu'il a finalement décidé d'oublier. Il est flagrant sur la bande-image de gauche qu'il se lâche au fur et à mesure, et finit son discours en oubliant complètement le dernier paragraphe initialement prévu.

Au programme de la seconde partie de ce billet, bien sûr les nuages arborés des deux textes : est-ce que les modifications lors de la prononciation du discours changent radicalement les arbres ? Et peut-être aussi une analyse plus en profondeur des différences (le verbe épouser a été ajouté oralement par deux fois par rapport au texte original ;))...


Pour ceux qui ont lu en diagonale : le discours prévu, le discours prononcé, le diff Diff'Doc sur 1 colonne de texte, le diff CompareIt sur deux colonnes de texte, mon billet suivant sur le sujet.

2 janvier 2008

Comparer les courbes de buzz avec le CaptuCourbes

Il y a un peu plus d'un an, alors que le candidat Bayrou commençait à faire buzzer la blogosphère, j'avais essayé de comparer plusieurs outils de mesure de buzz pour évaluer le bruit des trois principaux candidats sur le web, dans la presse, et dans les blogs. Une suite de décalquages et dilatations manuelles avait permis d'aboutir à une juxtaposition expressive mais peu satisfaisante, et j'avais commencé à réfléchir à un outil permettant de récupérer les valeurs d'une image de courbe. J'y avais réfléchi un peu plus fort à la fin de ma compilation manuelle des courbes de sondages du premier tour des présidentielles. Des outils permettant de numériser des courbes sont recensés sur cette page, mais la plupart ont disparu ou sont payants. Le premier, Engauge Digitizer, est très appétissant (logiciel libre, multi-plateformes, reconnaissance automatique de courbes), mais s'avère un peu lourd, et fournit un fichier avec une liste des points identifiés, aux coordonnées réelles, alors qu'on préfère dans un tableur avoir une liste de points aux abscisses entières et d'écart constant, pour reconstituer le graphique.

Bref, voilà un petit utilitaire libre (pour Windows) pour transformer une image de courbe en tableau ouvrable dans Excel ou OpenOffice, le CaptuCourbe ! L'idée est que vous allez lui indiquer la couleur de la courbe à récupérer, fixer l'échelle horizontale et verticale, ainsi que le pas de discrétisation, c'est à dire l'intervalle horizontal entre les points à récupérer. Cette démarche assez intuitive est détaillée dans le tutoriel du CaptuCourbe. Pour certaines images, la couleur de la courbe n'est pas uniforme, il suffira de la traiter en augmentant le contraste (un petit coup d'enhance colors dans le petit IrfanView par exemple), par exemple, pour diminuer le nombre de couleurs. Pensez aussi que la ou les couleurs de la courbe ne doivent pas être présentes dans le reste de l'image, si c'est le cas, il faudra penser à effacer les parties parasites.

Une petite mise en application du logiciel ? J'ai récupéré et réuni (fichier OpenOffice ici) les données de graphiques de suivi de buzz pour les deux informations qui ont fait vibrer la toile fin décembre :
La première courbe a été choisie comme référence, les autres du même buzz ont été dilatées de sorte que leur moyenne sur la période du 17 au 19 décembre (le premier pic) soit identique. On remarque une grande uniformité des courbes sur le premier sujet, qui a plus fait causer sur les blogs que le second. Pour ce dernier, on peut noter l'énorme pic de recherche Google par rapport au buzz sur les blogs, le phénomène est expliqué ici.

Les outils sur les blogs donnent des courbes très similaires, bien que leurs bases soient de taille différente : Technorati revendique une base de 112 millions de blogs, 69 millions pour BlogPulse, et 17 millions pour BlogScope. Si l'on compare plus finement les trois courbes, BlogPulse apparaît toujours un peu en retard, de moins de 24h en tout cas (certainement une différence sur l'heure de début de la journée). BlogScope semble montrer des pics plus marqués, peut-être que leur base plus petite contient plutôt les blogs influents et toujours premiers sur les scoops, et moins les petits qui relaient l'info avec quelques heures de retard.

J'ai choisi d'ajouter les graphiques de Trendio, sorte de bourse aux mots clés ou aux noms de personnalités, qu'on pourrait penser un bon indicateur de buzz. Ce n'est pas vraiment le cas, les courbes sont beaucoup moins nerveuses que ce qu'on pourrait attendre, parasitées par l'incertitude des investisseurs...

Absent de cette comparaison, l'outil de veille2com, le Sous-Marin Jaune. En effet les requêtes dont les résultats ont été publiés ne correspondaient pas exactement à celles que j'ai utilisées dans la comparaison ci-dessus, et l'outil se semble pas être accessible au public. C'est d'ailleurs tout à fait regrettable : même si je comprends que ScanBlog préfère monnayer ses outils de suivi de buzz, en laisser une partie en accès public permettrait non seulement d'en faire parler, mais éventuellement de montrer la valeur ajoutée par rapport aux autres outils de suivi de la blogosphère cités ci-dessus (si les courbes obtenues montraient des tendances différentes par exemple). Enfin, l'ouverture partielle aux internautes permettrait de récupérer leurs requêtes pour constituer une base de données des intentions, ce qui devrait intéresser une entreprise dédiée au suivi des buzz.

1 janvier 2008

tag cloud + tag tree = nuage arboré (2) Les voeux présidentiels pour 2008

De quoi nous a parlé notre Président dans ses voeux hier soir ? On avait eu droit l'an dernier aux nuages de mots des voeux des présidentiables pour nous en donner de jolies synthèses ; cette année, évolution technologique oblige, on va faire le nuage arboré de ce discours de 9 minutes. Pour ceux qui n'auraient pas suivi l'épisode précédent, ou le billet initial sur Aixtal, un nuage arboré, c'est le pouvoir de visualisation du nuage de mots, associé à celui de la classification hiérarchique en un arbre binaire non orienté !

La preuve en images pour tous les mots prononcés plus de deux fois :
nous donne :


La bonne nouvelle, c'est que si vous aussi vous souhaitez créer vous-même de tels nuages arborés, c'est possible en utilisant la nouvelle version 0.2 de TreeCloud Builder, associée au logiciel SplitsTree (introduction rapide à SplitsTree ici en français). La meilleure nouvelle, c'est que la prochaine version, actuellement en cours de codage et qui sera publiée en même temps que la troisième partie de ce billet, ne nécessitera plus d'utiliser SplitsTree.

La mauvaise nouvelle, c'est que dans la forme actuelle du logiciel (non documenté, fourni "tel quel" avec ses sources), l'arbre construit, même s'il reflète en un sens une certaine proximité entre les mots rapprochés dans ses sous-arbres, reste à prendre avec précaution. En effet l'enchaînement des algorithmes actuels ne me convainc pas. Je rentre dans les détails techniques, vous pouvez donc sauter la fin de ce paragraphe si ça ne vous passionne pas. Il y a actuellement plusieurs gros points faibles dans la construction de l'arbre. Tout d'abord le choix de la distance entre mots. TreeCloud Builder implémente la distance proposée dans le billet précédent, ainsi qu'une formule dérivée d'une formule de cooccurence classique : d1(a,b) = 1 - max(p(a|b),p(b|a)), où p(a|b) est la probabilité qu'une fenêtre de 20 mots autour du mot b contienne le mot a. Le problème avec cette distance d1 est qu'elle n'a rien d'arboré : tout arbre construit par des méthodes classiques en phylogénie ressemble très fortement à une étoile avec de longues branches menant aux feuilles, et des branches internes très courtes. Pour éviter ce problème je l'ai bricolée afin d'augmenter artificiellement la taille des branches internes du résultat obtenu (pour l'instant je ne comprends pas tout à fait comment ça marche, théoriquement, mais en pratique, ça marche) : d2(a,b) = log(101)-log(1+max(100p(a|b),100p(b|a))). Comme la matrice de distances obtenue contient beaucoup de log(101), les distances entre feuilles éloignées sont peu significatives, j'applique donc plutôt la méthode UPGMA (et voilà pourquoi ce billet n'est pas tagué phylogénie mais plutôt clustering) qui agglomère successivement dans l'arbre les mots les plus proches selon cette distance d2.

Revenons tout de même au nuage arboré créé. Même s'il est à prendre avec des pincettes, des phénomènes intéressants y apparaissent. Tout d'abord, l'urgence, vous n'avez pas pu louper l'anaphore alla Guaino. La figure de style apparaît dans l'arbre, puisqu'anaphore est accompagné dans "son sous-arbre" par des mots peu fréquents. Pas vraiment de grand concept-clé accolé à l'urgence, donc, mais une série de mesures. En revanche, le rôle de la France dans le monde, ça occupe un bon sous-arbre, et la représentation arborée permet notamment de désambiguïser le sens du mot vieux : Sarkozy ne parlait pas de nos chers aînés, mais bien de notre vieux pays. Remarquez aussi le sous-arbre des participes passés (voulu, pris, faite), organisés autour de l'ouverture, signes d'une promesse tenue. Même s'il est rigolo, le rapprochement de souci et coeur est artificiel, dû à la faible fréquence des deux mots, dommage pour les psychanalystes en arbre. Autres sous-arbres intéressants, celui des considérations présidentielles sur les valeurs de la vie (famille et travail), et celui plus grave sur la société et son avenir, pour lequel nous devons faire confiance à l'action du gouvernement...

Rendez-vous j'espère avant fin février pour une version aboutie et robuste théoriquement d'un TreeCloud Builder qui vous ferait vite et bien vos nuages arborés. En attendant, ce blog accueillera sous peu un nouvel utilitaire libre, qui permettra de récupérer d'une image les valeurs d'une courbe qu'elle contient. Fans des comparaisons Google Trends, Technorati Chart, Sous-marin Jaune, faites chauffer vos tableurs, c'est pour très bientôt !

Le programme TreeCloud.

12 décembre 2007

tag cloud + tag tree = nuage arboré (1)

Vous avez déjà travaillé avec deux objets, pour vous rendre compte que combinés ils fonctionnaient vachement mieux ? C'est la vraie révélation du dernier article de Jean Véronis sur Aixtal !
Après lecture de son blog ou du mien, vous êtes convaincus qu'un nuage de mots dont la taille (et la couleur, j'apprécie beaucoup les teintes rouges, oranges, et bleues du Nébuloscope, introduites en partie chez TagCloud) reflète la fréquence, c'est très utile pour donner un aperçu rapide d'un texte ou d'un corpus. Vous êtes tout autant convaincus qu'un arbre phylogénétique peut donner un aperçu rapide de relations entre des mots-clés. Et quand on mixe les deux ? Je cite : "c'est marrant les arbres... ils peuvent nous raconter des histoires". Et voilà, un nouvel outil de visualisation d'histoires !

Dans l'exemple dédié à Laurence Ferrari, ce sont les résultats Wikio qui sont "passsés à la moulinette". Mais de la même façon qu'on peut effectuer un nuage de mots depuis un simple texte (avec TagCloudBuilder et une échelle de coloriage logarithmique bien sûr !), j'ai l'impression qu'un nuage arboré (tree-cloud pour nos amis anglophones) est encore un meilleur moyen d'avoir un aperçu rapide d'un texte. L'ordre alphabétique complètement artificiel des tags dans le nuage est remplacé par une disposition hiérarchique intuitive et informatrice !

Alors maintenant, quelle distance entre mots choisir pour reconstituer l'arbre, sur un simple texte ? J'ai fait l'essai suivant : pour chaque paire de mots, leur distance mutuelle est égale au log du nombre de mots minimal qui les sépare. J'avais déjà tenté de commencer à justifier théoriquement l'introduction du log pour certaines reconstructions "phylogénétiques" (la seconde partie du billet est toujours dans les cartons), là je l'introduis a priori seulement pour éviter quelques trop longues branches. J'ai prévu de tester quelques améliorations de cette idée : nombre de mots moyen séparant la paire de mots, éventuellement seulement sur les occurences les plus rapprochées de la paire...

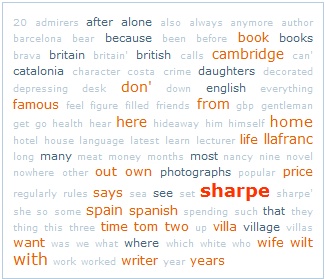
Je garde ces préoccupations pour un éventuel billet suivant, et je livre un exemple d'application de ce principe, tiré du premier texte de longueur convenable que j'avais sous la main, une interview en anglais de Tom Sharpe. L'heure tardive ne me permet pas de mixer arbre et nuage de mots, les voici donc, à mixer mentalement (pour le moment) :
Pour la construction de l'arbre, j'ai gardé seulement les mots présents plus de 3 fois, et contrairement au nuage de mots, n'ai pas enlevé les mots très présents peu porteurs de sens (I, the, to, l'antidico quoi...), qui ne gènent pourtant pas vraiment dans l'arbre (is, of, in, the, he arrivent au niveau du centre).

Le choix de la distance conduit à certains rapprochement un peu artificiels, toutefois la plupart des sous-arbres ont un sens. Soit constitués justement de mots de l'antidico, donc à négliger, soit reflétant les principaux thèmes de l'article. En particulier le sujet général apparaît dans le sous-arbre {village,where,Tom,Sharpe}. Afficher le contexte au passage de la souris sur une feuille ou un sous-arbre serait donc particulièrement intéressant.

Du travail en perspective, donc. A suivre sur ce blog... et sur treecloud.org !

Les fichiers sources des images ci-dessus : fichier Nexus de l'arbre phylogénétique, mots et occurences, mots et occurences avec anti-dico manuel, nuage de mots de TagCloudBuilder, programme de construction de la matrice de distance format Nexus et source Delphi peu commenté pour l'instant.

23 octobre 2007

Dissection d'une pétition (3) : robustesse des résultats

Je reviens sur les résultats de mon dernier billet concernant les tendances horaires d'utilisation d'internet selon la catégorie professionnelle. Quelques éléments de tendance avaient été identifiés, et j'avais avancé dans chaque cas une cause pouvant les expliquer. A quel point ces tendances sont-elles réelles, pourraient-elles être dues à la procédure utilisée pour obtenir les graphiques ?

En général pour vérifier que des résultats trouvés à partir d'analyses statistiques sont corrects, on réeffectue tous les calculs en modifiant légèrement les données. C'est la technique de "rééchantillonnage" ou "bootstrap", particulièrement utilisée en phylogénie (c'est d'ailleurs cette étape de vérification qui traîne et m'empêche de terminer mon billet sur une proposition de "distance Eurovision").

Dans le cas de la pétition TouchePasAMonAdn je ne vais pas modifier les données de départ concernant les signataires, mais plutôt utiliser d'autres règles de regroupement de professions qui donneront donc lieu à un nouveau lot de données. J'avais précisé que les règles que j'avais utilisées pour interpréter les noms de professions entrées par les signataires étaient un peu arbitraires, j'obtenais finalement trois gros groupes (retraités, étudiants, enseignants), et un ensemble de groupes beaucoup plus petits. C'est en tombant sur l'analyse des statistiques sur la pétition EUCD.info que j'ai découvert d'autres règles de groupement de professions qui m'ont semblé meilleures (page 2). Sont-elles effectivement meilleures ? Est-ce qu'en les appliquant on obtient des courbes de tendances similaires ?

Première réponse : oui, les règles d'Eucd sont meilleures, puisqu'elles permettent d'identifier plus de professions. Mes règles personnelles appliquées sur les signataires du 4 octobre permettait de récupérer la profession de 50,5% d'entre eux. Avec les règles d'Eucd.info, j'arrive à 64,3% d'identification de la profession (les signataires de TouchePasAMonAdn ont "mieux" indiqué leur profession que ceux d'Eucd où ils atteignaient seulement 36,6% d'identification). Et en plus de la quantité, la qualité est au rendez-vous : les courbes sont beaucoup plus équilibrées, avec le groupe des "employés" qui passe en première position dans l'ensemble des signataires.

Seconde réponse : oui, les tendances identifiées sont toujours visibles, excepté peut-être le "repas de 13h" des journalistes un peu noyés dans la masse. La disjonction du groupe d'étudiants en post-bac et lycéens/collégiens permet aussi d'identifier une nouvelle tendance sur ces derniers (utilisation d'internet plutôt le soir).

On remarque aussi certaines courbes presque constantes, celles des cadres, des professions libérales, des fonctionnaires, groupes au sein desquels on ne peut donc pas identifier de comportement commun vis à vis de l'utilisation d'internet.

Enfin je m'étais bien gardé de comparer entre différentes professions les pourcentages de signataires trouvés (pour éviter de fausses impressions du genre "ceux qui ont le plus signé la pétition sont les employés", attention j'ai 30% de professions que je n'ai pas identifiées !), mais après cet avertissement je peux me permettre de comparer les pourcentages de signataires par profession avec ceux de la pétition EUCD.info :
Et là les pourcentages de signataires de la pétition TouchePasAMonAdn sont clairement plus représentatifs de la société française que ceux de Eucd.info. Je suis particulièrement étonné par la proportion de retraités : traduit-elle un plus grand intérêt pour cette pétition comme pour les enseignants ou les professions libérales, ou est-ce simplement un reflet de la forte augmentation du "taux de connexion" des retraités depuis 2 ans (la pétition EUCD a commencé fin 2005) ?

21 octobre 2007

Dissection d'une pétition (2) : à quelle heure surfent les retraités, enseignants, étudiants, ingénieurs...

J'expliquais dans mon dernier billet comment récupérer l'heure et la profession de chaque signature de la pétition Touche pas à mon ADN. On va voir maintenant que les résultats obtenus illustrent les habitudes de surf sur internet de chaque profession.

Tout d'abord voyons comment j'ai uniformisé les noms de professions (vous pouvez passer directement au graphique en bas si vous voulez éviter ces détails techniques...). Effectivement, dans la base de données brutes, on trouve "étudiant" aussi bien qu'"étudiantes", les professeurs détaillent parfois quelle matière ils enseignent, etc. Bref il faut regrouper certaines professions. Voici les règles utilisées (sur des chaînes de caractères que j'ai "désaccentuées"), dans cet ordre, tout à fait subjectives et critiquables (les commentaires sont faits pour ça [modification du 21/11/2013 : si je devais refaire le travail ci-dessous aujourd'hui, je ne mettrais évidemment pas "doctorant" et "thesard" dans la catégorie "étudiant", mais bien dans la catégorie "chercheurs", je n'étais alors qu'au début de mon doctorat et pas très sensibilisé à ces questions...]) :
profession contient "retraite" > retraité
profession contient "etudiant" ou "lyceen" ou "collegien" ou "doctorant" ou "thesard" > étudiant
profession = "prof" ou contient "enseignant" ou "professeur" > enseignant
profession contient "medecin" > médecin
profession contient "sans emploi" ou "sans profession" ou "chomeur" > chomeur
profession contient "architecte" > architecte
profession contient "assistant" et "social" > assistante sociale
profession contient "chercheu" > chercheur
profession contient "fonctionnaire" > fonctionnaire
profession contient "infirmier" > infirmier
profession contient "graphiste" > graphiste
profession contient "informaticien" ou "webmaster" > informaticien
profession contient "ingenieur" > ingénieur
profession contient "journaliste" > journaliste
profession contient "musicien" ou "chanteu" > musicien
profession contient "psychologue" > psychologue
profession contient "secretaire" > secrétaire
profession contient "technicien" > technicien
profession contient "commer" ou "vendeu" > commercial
profession contient "au foyer" > mère au foyer
profession contient "ouvrier" > ouvrier
profession contient "plombier" ou "artisan" ou "electricien" > artisan

Pourquoi me limiter à ceux-là ? La méthodologie pour déterminer les noms de métiers "significatifs" a été la suivante : afficher dans un tableur le tableau des professions récupérées pour les deux premiers jours de la pétition (eh oui, les tableurs ont un nombre de ligne limité, je ne pouvais pas insérer toute ma base), trier par nom de métier croissant, puis filtrer (c'est formidable, cette fonction des tableurs découverte à l'occasion de mon enseignement de C2I...) tous les métiers qui apparaissent plus de 50 fois.

Résultat : pour le 4 octobre par exemple, sur 32845 signataires, 30222 ont indiqué leur profession, mes règles basiques me permettent d'en récupérer 16605. Au total je récupère 79104 indications de professions. Assez pour que la loi des grands nombres s'applique et que je puisse espérer obtenir des résultats représentatifs. Voici le graphique des données récupérées pour les signatures du 2 au 10 octobre (j'avais mentionné dans mon post précédent que les données des jours suivants contiennent des doublons qui peuvent être gênants pour ces stats) :
En sélectionnant les courbes des trois groupes les plus représentés : enseignants, étudiants, retraités, on remarque que leur allure est similaire les jours de semaine, et un peu différente le weekend. Ce sont ces régularités qui justifient qu'effectivement certains motifs particuliers apparaissent pour chaque profession, que l'on va pouvoir tenter d'expliquer : un creux dans une des courbes indique que moins de personnes signent la pétition, elles doivent donc faire autre chose que surfer sur internet. Par exemple, remarquons le creux de 16h le dimanche. Il doit y avoir une explication : la promenade dominicale peut-être ? (Re)précisons que le creux du samedi a une cause technique : une défaillance du site web de la pétition certainement.

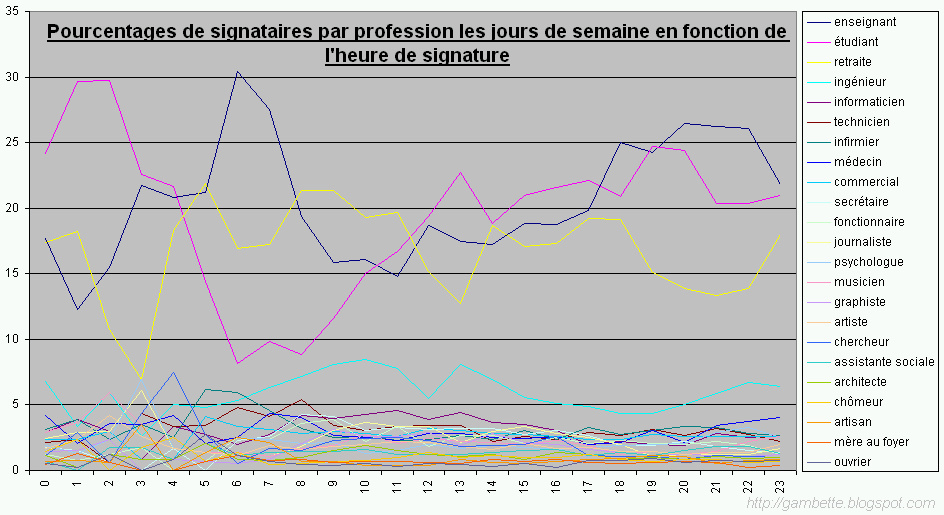
Certaines régularités étant observables pour les jours du lundi au vendredi, on va donc regrouper les données de ces jours pour obtenir des statistiques horaires par profession et visualiser certaines de leurs habitudes de vie. Comme on s'intéresse aux spécificités de chaque profession, c'est moins le nombre de signataires horaires que le pourcentage horaire de signataires de chaque profession qui nous intéresse, le voici donc représenté :
Regardons les trois groupes les plus représentés : entre minuit et 3h, belle prépondérance de la courbe des étudiants, visiblement plus couche-tard. Attention toutefois, entre 1h et 6h, les données ne sont pas extrêmement significatives... Si les retraités semblent avoir une représentation constante depuis 4 heures du matin, il semble que beaucoup d'enseignants vont surfer au réveil, entre 6h et 8h. Pour les étudiants, le réveil a visiblement lieu plus tard, ce qui apparaissait déjà bien sur la courbe s'étendant sur toute la semaine. Nouveau pic enseignant à 18h, petit surf de retour du boulot certainement ? Pour les retraités, les creux se placent à 13h et entre 19h et 22h : repas de midi, et soirée devant la télé ?

Maintenant regardons plus précisément les groupes moins représentés :
La pause repas d'une heure le midi semble particulièrement suivie par les ingénieurs qui semblent utiliser internet dès leur arrivée au travail le matin, et éventuellement en rentrant chez eux le soir après 19h. On a un beau pic de psychologues insomniaques à 4h du matin qui concerne en fait 8 individus, et de chercheurs à 5h, qui en concerne 9... on atteint ici les limites de significativité. Pour les informaticiens, se dégage bien un plateau entre 8h et 16h, intervalle qui doit correspondre à leurs heures de travail et donc de présence sur internet. Pour les journalistes enfin, remarquons comme pour les ingénieurs le creux vraisemblablement expliqué par la pause repas, qui semble là être décalée à 13h.

La compilation de ces courbes fait donc bien apparaître quelques variations significatives (le prochain billet s'intéressera justement à cette significativité, et à la robustesse des résultats présentés ici), qu'on peut tenter d'expliquer par des comportements globaux inhérents à la profession. N'hésitez pas à en mentionner d'autres en commentaires, pour visualiser mieux une courbe en la mettant en gras, vous pouvez modifier le document source, un fichier au format Excel.

19 octobre 2007

Dissection d'une pétition (1)

De retour après avoir passé du temps à l'Inathèque, déménagé, commencé ma thèse, et préparé mes premiers enseignements, me voilà prêt à décortiquer un nouveau phénomène viral, après la F-list, la pétition "Touche pas à mon ADN".

Là malheureusement, on n'a pas autant d'informations sur la transmission du phénomène que pour les F-lists, mais on va essayer de tirer quelques conclusions à partir de la jolie base de plus de 200 000 signataires disponibles sur le site TouchePasAMonAdn.com. Première difficulté, récupérer la base de données, qui est répartie en plusieurs feuilles de 400 noms. Pour ça j'ai mon "aspirateur" personnel, qui visite les pages voulues en extrayant les informations utiles du code HTML des pages. Une petite difficulté supplémentaire : la liste se met à jour pendant l'aspiration, il a donc fallu mettre en place a posteriori une détection automatique des signataires qui avaient été enregistrés deux fois : en fin de page et en début de page suivante. Ca paraît relativement simple, hein ? Sauf que la tâche se complique quand les organisateurs décident de nettoyer leur base de signataires d'avant le 11 octobre, en réorganisant au passage de façon apparemment aléatoire (rangée ni dans l'ordre alphabétique, ni chronologique) la liste des signatures avant cette date.

Alors pourquoi une telle réorganisation ? Tout d'abord, à cause des signataires qui cliquent mal : beaucoup de doublons apparaissent dans la liste brute. Ensuite, à cause des petits rigolos qui font des blagues. En voilà un petit florilège (vous vous rappelez des Zidane et Chirac d'Unitaid ?), attention la finesse n'est pas toujours au rendez-vous...

04 octobre 2007, 02:15;nicolas sarkozy;nabot présidentiel (république bananière);
04 octobre 2007, 12:29;Nicolas Sarkozy;;
04 octobre 2007, 13:01;Nicolas Sarkozy;Président de rien du tout;
04 octobre 2007, 14:54;NICOLAS SARKOZY;président (france);
04 octobre 2007, 17:43;Nicolas Sarkozy;Président (aucune);
04 octobre 2007, 18:38;nicolas sarkozy;président;
04 octobre 2007, 20:52;Nicolas Sarkozy de Nagy Bocsa;Président, enfin... je crois;
16 octobre 2007, 08:36;nicolas sarkozy;président des francais;
03 octobre 2007, 11:00;brice hortefeux;schizophrène (Dictature Sarkozyenne);
03 octobre 2007, 11:52;BRICE Hortefeux;Fuhrer (République Francaise);
03 octobre 2007, 13:41;hortefeux brice;raciste 2nd;
03 octobre 2007, 17:12;Brice HORTEFEUX;;
03 octobre 2007, 17:28;Brice Hortefeux;Face de pet;
03 octobre 2007, 21:47;BRICE HORTEFEUX;ministre de la betise;
03 octobre 2007, 22:50;Brice Hortefeux;futur ex-Ministre;
03 octobre 2007, 23:13;Brice Hortefeux;;
04 octobre 2007, 16:12;brice hortefeux;;
04 octobre 2007, 16:13;Brice HORTEFEUX;Ministre (SARKOLAND);
16 octobre 2007, 12:16;brice hortefeux;;
03 octobre 2007, 21:59;Thierry Mariani;Député cocu;
03 octobre 2007, 18:48;thierry mariani;député (bientôt chômeur);
12 octobre 2007, 15:04;Thierry Mariani;député;
13 octobre 2007, 21:04;THIERRY MARIANI;MINISTRE : vous êtes tous des rigolos !;
03 octobre 2007, 10:53;GEORGES BUSH;u want2fukme;
03 octobre 2007, 22:22;jorge bush;rongeur (otan);
04 octobre 2007, 15:37;georges bush;;
04 octobre 2007, 23:30;GEORGES BUSH;USA;
13 octobre 2007, 22:54;Debeuliou Bush;President of the United-States of America;
16 octobre 2007, 06:33;georges bush;;
12 octobre 2007, 18:49;François Mitterrand;Illusionniste;
13 octobre 2007, 17:41;Chirac Bernadette;Pute des routes;
16 octobre 2007, 10:57;Jacques Chirac;ancien Président de la République;
03 octobre 2007, 11:35;zidane zinedine;retraité;
03 octobre 2007, 18:05;Zinedine Zidane;ancien footballeur;
03 octobre 2007, 22:50;zidane zinedine;footballeur;
03 octobre 2007, 23:23;zinedine zidane;footballer (OM);
04 octobre 2007, 23:27;Zinédine Zidane;Footballeur retraité;
15 octobre 2007, 18:38;Zinedine Zidane;retraitée du sport (les pervers);
15 octobre 2007, 19:06;Bernard Kouchner;National Socio-traitre (Nazie) (Heil Hitler !);
04 octobre 2007, 23:32;KOUCHNER Bernard;Extérieur du Ministère;
16 octobre 2007, 09:26;Francois Bayrou;Clown;
04 octobre 2007, 10:35;fadela amara;traitre (ump);
17 octobre 2007, 07:20;test test;test (test);
17 octobre 2007, 07:17;Kipeutebattre croustibat;poisson pané (findus);
16 octobre 2007, 02:02;Kylie Minogue;Chanteuse;


Depuis, certains de ces noms ont disparu : les Sarkozy et Hortefeux d'avant le 11 octobre. Il reste les Zidane. J'imagine donc qu'une certaine partie du tri a été faite manuellement (pour automatiser un peu tout ça je suggérerais de classer les signataires par ordre alphabétique et vérifier les groupes de personnes qui ont le même nom et prénom, ou encore d'utiliser FuryPopularity sur les noms de tous les signataires pour identifier les noms connus... et donc suspects). La partie automatique de suppression des répétitions a visiblement été efficace, puisqu'elle a fait passer le nombre de signataires du 4 octobre de 41000 à 33000 environ, pour le 3 octobre de 30000 à 28000. L'ordre de grandeur est toutefois respecté, ce qui peut rassurer les quelques visiteurs étonnés par ces doublons.

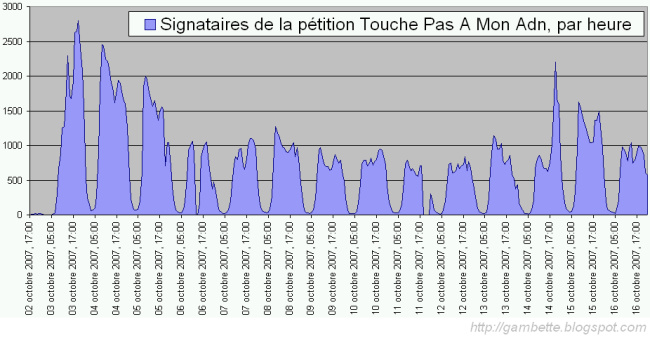
Bref, même si la récupération de la base n'est pas immédiate, elle est possible, et je l'ai bien vite enregistrée en supprimant les données nominatives, gardant seulement l'heure et la profession pour chaque signataire. La profession, je la garde en réserve pour la deuxième et la troisième partie de ce billet, regardons seulement l'évolution des signatures pendant la première quinzaine de la pétition :
Remarquons d'abord le joli démarrage, qui doit laisser rêveur tout adepte de marketing sur internet... Est-ce que la "qualité du produit" a suffi à attirer une telle foule ? Quels ont été les relais publicitaires pour faire connaître le site aussi vite ? Médias traditionnels, bouche à oreille, blogs, mails ? S'il n'est pas évident de le déterminer (le décollage commence à 8h du matin !), on peut en revanche remarquer une forte corrélation entre le nombre de billets de blogs citant la pétition, ou son adresse, et le nombre de signataires :
Notre tableur préféré nous donne un coefficient de corrélation de 0.80 entre le nombre de signataires et le nombre de billets quotidiens contenant "Touche pas à mon ADN" d'après Blogsearch, 0.76 avec le nombre de ceux qui contiennent le lien vers touchepasamonadn.com. Remarquons aussi que les deux courbes Blogsearch très proches avant le 13 octobre divergent ensuite. Pourquoi ?

La clé de l'énigme, c'est le meeting concert Touche pas à mon ADN, dont les gens ont visiblement parlé sur leur blog sans donner l'adresse de la pétition. Toutefois l'événement a eu un retentissement médiatique qui se visualise très bien le 14 octobre au soir avec deux pics de signatures vers 19h50 et 20h20, et qui redonne de l'énergie au nombre de signatures par heure.

Enfin vous aurez noté sur le graphique de l'évolution des signatures deux interruptions du site, le 11 octobre au soir, et le 6 octobre avant 17h. Il semble tout de même avoir tenu le coup aux moments les plus critiques.

Pas encore efficace, cette pétition montre toutefois quelques conditions nécessaires pour un succès. Un relai médiatique, une solide structure technique pour accueillir les signatures voire vérifier leur authenticité. Où s'arrête l'initiative populaire et où commence le lobbying super organisé et forcément bien financé ? En attendant de telles initiatives permettent au moins de maintenir une certaine vigilance... et nous donner des indications sur les horaires de surf des étudiants, des enseignants, des retraités, des chercheurs, des ingénieurs. A suivre très bientôt, dans le prochain billet !

5 juillet 2007

Avoir vocation à... une héritation de Chirac

Parti traquer les erreurs de pronoms relatifs (oui, merci, la pêche a été bonne...), j'ai été étonné, après le billet de Jean Véronis sur l'expression "avoir vocation à", de l'entendre 3 fois dans la bouche de Brice Hortefeux dimanche dernier dans son passage au Grand Jury d'RTL :

"les pays d'immigration n'ont pas vocation à laisser partir [...] toute leur élite"
"Tout immigré en situation irrégulière a vocation à être reconduit à la frontière"
"s'ils sont interpelés, ils ont vocation à être reconduits dans leur pays"

Alors, contamination par le patron ? Ou bien reflet d'une utilisation plus généralisée ?

Pour tester cela j'ai tout d'abord essayé une combinaison de recherches Google de la forme :
n1 = nombre de résultats Google pour ("Nicolas Sarkozy")
n2 = nombre de résultats Google pour ("Nicolas Sarkozy" "vocation à")
n3 = nombre de résultats Google pour ("Nicolas Sarkozy" "pas vocation à")


Pour effectuer ces recherches en masse sur une brochette de politiques, aucun problème, mon programme FuryPopularity dont je vous avais déjà parlé se débrouille très bien. Je viens d'ailleurs d'y ajouter la possibilité de récupérer le nombre de résultats pour un ensemble de requêtes sur les moteurs Yahoo et Dir.com. L'objectif était donc de comparer pour l'ensemble des politiques les valeurs n2/n1, et aussi les n3/n1.

Premier problème, encore et toujours, les fantaisies des moteurs Yahoo et Google. Les deux sont concernés, pour Yahoo j'ai même eu parfois n3>n2 ! Mais bon, ça, je m'y attendais. J'ai essayé d'ajouter un petit test pour m'assurer que les chiffres n'étaient pas trop absurdes, récupérer aussi :
n4 = nombre de résultats Google pour ("Nicolas Sarkozy" "vocation à" -"pas vocation à")
Là théoriquement n2-n3-n4=0, je considérais le résultat comme correct quand (n2-n3-n4)/n2 restait inférieur à 10% : rien à faire, les deux moteurs fournissaient des résultats incohérents et non significatifs. Idem du point de vue du manque de significativité pour Dir.com qui est plus rigoureux dans ses annonces de résultats.

Bref, il fallait un corpus de discours d'hommes politiques, plus spécifique que le web tout entier. Evidemment, je me tiens au courant de l'actualité... Mais 19 discours de politique générale, ça ne fourmille pas de "vocations à". Heureusement mon moteur de recherche préféré (malgré ses défauts cités plus haut) m'a indiqué le corpus du "concours" DEFT'05, qui réunit des extraits d'allocutions de Jacques Chirac et François Mitterrand (bien annoté, ce qui m'a permis de séparer les uns des autres sans programmer une ligne de code, avec simplement des rechercher/remplacer et Microsoft Excel). Verdict sur les 1 036 331 mots de Chirac et les 202 120 de Mitterrand ? 95 "vocation à" pour le premier, 4 pour le second.

Bingo ! C'était bien vu de la part de Narvic dans les commentaires d'Aixtal, Jacques Chirac atteint un joli 9,17 "vocation à" sur 100 000 mots, face aux presque 11 pour 100 000 de Nicolas Sarkozy, et aux 1,98 sur 100 000 de François Mitterrand


Alors, Sarkozy digne héritier de Chirac pour l'utilisation de cette expression ? Pas tout à fait, il a su ajouter sa petite rupture. Comptons parmi toutes ces occurences le nombre de "pas vocation à" : 9,4% pour Jacques, 42,5% pour Nicolas...

De là à irriter l'ancien président comme le prétend Google...

19 juin 2007

Google toujours misogyne

Google s'était un peu corrigé après l'affaire de "toutesdesbeautés" et du ségolisme, allant même jusqu'à douter de l'ouverture d'un "Sarkozy gauchiste". Mais ses suggestions orthographiques continuent à dégrader l'image de la femme : apparemment les filles préféreraient sécher plutôt que bûcher.

Les garçons bûcheurs quant à eux deviennent bouchers :

11 juin 2007

Archives du blog François-Mitterrand-2007

You've been Google-cach'd!Fin du mystère sur le blogueur/médium de François Mitterrand, grâce à Nicolas Voisin dont la démarche est plus ou moins appréciée.

La fermeture s'est accompagnée de la suppression de tous les billets précédents. Heureusement que notre ami Google avait (presque ?) tout archivé scrupuleusement. Comme ce n'est pas très facile de se promener là dedans, voici le catalogue des billets ordonnés chronologiquement ! Et le cache de Google n'étant pas éternel, je remplacerai à leur disposition les liens cassés par des pointeurs vers les fichiers fraîchement sauvegardés (ce qui n'était d'ailleurs pas trivial, je n'ai pas réussi à configurer mon aspirateur préféré pour archiver tout ça et j'ai dû concocter un petit programme personnel).

A ce propos, je me demande d'ailleurs comment sont gérées les questions de droits d'auteur pour des productions anonymes... En tout cas, Google ne se pose pas la question, pour le plus grand plaisir des lecteurs du "cache" !

30 mai 2007

Eurovision, géopolitique et phylogénie, partie 1/2 : des pourcentages d'amitié aux distances d'amitié

Un peu plus d'un an que ce blog existe, je me permets donc de faire un petit bilan, avant de passer au sujet principal de ce billet, qui répond justement au premier posté ici l'an dernier, à propos de l'Eurovision.

Un rythme pas trop inégal d'un peu moins d'un billet par semaine, une collection de petits outils informatiques qui s'agrandit régulièrement (celui pour créer des nuages de mots, lancer de multiples requêtes Google, analyser les logs MSN), quelques idées de futurs billets en tête, tout cela m'incite à continuer dans la même veine. Surtout que ce blog m'est finalement très utile. Pour mettre à l'épreuve quelques idées reçues (sur la collusion des votes à l'Eurovision, la qualité des sondages...), ou quelques idées tout court (l'utilisation des moteurs de recherche pour l'orthographe et ses limites, le déclin de la qualité de traduction des titres de films...). Mais il m'a aussi permis quelques découvertes inattendues, sur la datation du big bang du web, la spécificité francophone de l'abréviation "MacDo" ou le syndrôme des moutons de Panurge chez les députés. Et je profite souvent d'avoir posté un billet pour approfondir un peu sur le sujet (certes, il serait préférable de le faire avant, mais je ne tiens pas vraiment à me lancer dans une étude biblio systématiquement...).

Je ne suis pas le premier à me féliciter des avantages du blog en tant qu'outil comunautaire, mais les discussions faisant suite à certains posts, qu'elles aient lieu sur le blog ou non, ont toujours été très enrichissantes. Et elles ont parfois rejoint directement un sujet de recherche scientifique "sérieux", que ce soit pour l'illustrer (le Voronoï des McDos parisiens par exemple, pour illustrer le jeu de Voronoï, ou la visualisation en plan de métro pour l'isomorphisme de graphes), le motiver (de nombreuses problématiques sur les distances en phylogénie), ou rester à sa frontière en attendant des liens éventuels (le corpus de la F-list et les modèles de diffusion ou les communautés dans les blogs). Bref, le blog qui s'introduit comme une des composantes de la méthode scientifique, ça me plaît bien, et je vais continuer à véroniser encore un peu...

Et pour aujourd'hui, ce sera un problème qui me trotte dans la tête depuis quelque temps déjà. Cela fait belle lurette que l'arbre phylogénétique a été utilisé pour représenter autre chose que des relations de parenté entre espèces ou gènes... C'est simplement un excellent outil de visualisation, qui est très expressif pour représenter des données séparées par des distances connues, plus en tout cas qu'un plongement dans le plan (en deux dimensions, parfois même plus expressif qu'un plongement en 3D...), bien qu'il soit planaire.

Le problème est que pour des applications non bioinformatiques, les distances utilisées doivent ressembler à des distances le long de branches d'un arbre pour que celui-ci soit vraiment expressif. On peut se rappeler de l'arbre des thèmes de la présidentielle de Jean Véronis construit à partir des "distances Google normalisées", qui était beaucoup plus expressif quand on fixait une longueur unitaire à toutes les arêtes de l'arbre. Si on ne le faisait pas, on obtenait une sorte d'étoile, avec des branches menant aux feuilles toujours très longues.

J'avais obtenu pour l'Eurovision l'an dernier un arbre assez satisfaisant, mais celui-ci représentait seulement les proximités de votes entre les pays : deux pays étaient rapprochés s'ils votaient de la même façon, et pas s'ils votaient l'un pour l'autre. Or ce second problème semble plus intéressant quand on désire quantifier les effets du vote d'amitié entre pays voisins. Reste à trouver une distance d(i,j) qui reflète que le pays i avantage le pays j dans ses votes, et inversement. Si vous voulez éviter ces détails techniques croustillants et passer directement aux résultats... vous n'avez plus qu'à attendre la seconde partie du billet

Un des défis est que la distance soit normalisée, c'est à dire qu'un pays n'ayant pas souvent participé, ou ayant reçu peu de points, ait des distances avec les autres comparables à celles d'un pays souvent présent au palmarès. Pour cela je propose donc l'approche suivante, qui m'a surpris par ses résultats qui semblent robustes (j'obtiens pour cette distance des arbres très similaires avec diverses méthodes de reconstruction, je reviendrai là-dessus...).

J'appelle P(i->j) le pourcentage des points donnés par le pays i au pays j, parmi tous les points reçus par le pays j. Un des avantages de cette approche est que le nombre de compétitions auxquelles ont participé i et j importe peu (ce qui est intéressant parce que par exemple l'Albanie n'a participé qu'une fois de 1975 à 2004, alors que la Grande-Bretagne était présente tous les ans). On dispose donc d'un ensemble de données normalisées P(i->j) pour chaque couple de pays, et on voudrait les transformer en données de distances qu'on note d(i->j). En particulier on veut qu'elles soient symétriques, c'est à dire que d(i->j) = d(j->i), et on veut que d(i->j) soit petit quand P(i->j) et P(j->i) sont grands, c'est à dire que d soit une fonction décroissante par rapport à P. Mais quelle fonction décroissante choisir ?

Pour trouver cette fonction convenable pour d, commençons par raisonner sur de petits exemples, c'est à dire de petits arbres binaires non enracinés où d est donc connue, et où on cherche à déterminer pour chaque noeud i des pourcentages P(j->i) raisonnables. On commence par l'arbre le plus simple possible, à 3 feuilles, en figure (a) ci-dessous. Chaque feuille étant placée à distance égale de ses deux voisins, les pourcentages des deux voisins doivent être égaux, c'est à dire par exemple pour la feuille 2 que : P(1->2) = P(3->2) = 1/2.
Supposons maintenant qu'on insère une feuille 4 dans l'arête qui aboutit à 3, comme illustré dans la figure (b). Le sous-arbre contenant 1 et 2 n'étant pas changé, on garde P(1->2) = P(2->1) = 1/2. Il reste donc 50% des points reçus par 1 à attribuer à 3 et 4, qui sont tous deux à la même distance de 1, donc : P(3->1) = P(4->1) = 1/4. En procédant de même pour chacune des autres feuilles, on obtient les pourcentages indiqués dans la figure (b).
De même, si on ajoute une nouvelle feuille, 5, on peut attribuer les points pour obtenir les pourcentages indiqués en figure (c). En fait la procédure pour attribuer les pourcentages de points de la feuille i peut se voir ainsi : on part de la feuille i et on parcourt l'arbre : à chaque embranchement rencontré, on divise par deux le nombre de points attribué par chacun des sous-arbres délimités par l'embranchement. Cette technique permet bien d'arriver à un total de 100% des points attribués, pour chaque feuille.

La formule est donc la suivante pour P en fonction de d :

P(i->j) = P(i->j) = 1/2^(d(i->j)-1),
ce qui donne pour d en fonction de P :
d(i->j) = 1 + log2 (1/P(i->j)),
et comme on veut que les distances soient symétriques, on fait la moyenne :
d(i,j) = (d(i->j) + d(j->i))/2.

Il reste à gérer un "léger" problème, celui des cas où P(i->j)=0, qui devrait donner une distance infinie. Quelle distance choisir dans ces cas-là, qui ne sont pas rares ? Difficile de choisir, je ne vois aucune façon naturelle de répondre à la question, et tous les essais que j'ai faits (choisir par exemple la plus grande distance dans la matrice pour ces cas-là, ou deux fois cette distance) donne des arbres avec quelques très longues branches au niveau des pays touchés par le problème. Ceci dit, il y a un moyen simple de régler le problème : corriger les données a priori !

Au lieu d'utiliser les données brutes, on va effectuer une sorte de lissage en ajoutant le fait que tout pays donne de toute façon un point à tout autre pays. Ainsi, en notant p(i->j) le nombre de points réellement donnés à j par i, au lieu de définir :
P(i->j) = p(i->j) / (Σk p(k->j)),
on définit :
P(i->j) = (1+p(i->j)) / (Σk 1+p(k->j)).
Ainsi, P n'est jamais nul, et l'arbre obtenu est plutôt convaincant... mais pour s'en rendre compte il faudra attendre la seconde partie de ce billet ;).

Je suis allé faire un petit tour dans la littérature concernant le concours de l'Eurovision, et les moyens utilisés pour estimer une "distance Eurovision" entre les pays sont assez variés.

Il y a une sorte de référence en la matière, l'article de Fenn, Suleman, Efstathiou et Johnson de 2005 (paru cette année dans Physica A) qui propose plusieurs critères quantitatifs :
- ils considèrent pour chaque année le graphe formé simplement en mettant les pays comme noeuds et une arête entre deux noeuds si un pays a donné un ou des points à l'autre. Ils comparent les coefficients de clustering, et la distribution des degrés (des paramètres classiques en étude de réseaux sociaux), de ce réseau par rapport à un réseau correspondant à un concours attribuant les points aléatoirement.
- pour dessiner un dendrogramme (une sorte d'arbre phylogénétique), ils ne se basent pas sur une distance indiquant l'affinité entre pays (qui était pourtant exprimée par le coefficient de clustering, et la distribution des degrés), mais reviennent à une approche plus classique de comparaison des votes, en utilisant le coefficient de Pearson (donc un peu plus sophistiqué que la simple somme des valeurs absolues des différences que j'avais utilisée l'an dernier), et en utilisant la méthode UPGMA pour la construction de l'arbre. En tout cas l'arbre obtenu fait bien ressortir quelques signaux forts d'affinité de goûts entre pays.

L'analyse de Gatherer de 2006 cherche à identifier localement les collusions entre pays et leur évolution, mais ne fournit pas de panorama global.

L'article de Dekker, The Eurovision Song Contest as a 'Friendship' Network, propose un "score d'amitié" intéressant : il estime un score attendu en fonction des résultats globaux, et le score d'amitié reflète la différence entre le nombre de points attendu et le nombre de points réellement obtenus. Toutefois, l'auteur indique que la construction d'un arbre phylogénétique n'est pas appropriée en utilisant ces scores : ajouter un bruit aléatoire de 0 à 0,1% pour altérer les données fournit des arbres assez différents. C'est justement sur ce point que j'espère que la formule de distance présentée dans ce billet sera plus robuste.
A noter aussi dans cet article le joli graphique en 3D représentant les points attribués entre pays en fonction de la proximité entre eux (calculée en terme de nombre minimal de frontières à traverser pour passer de l'un à l'autre).

Bref, tests et figures à venir, en attendant vous pourrez toujours aller voir la carte de l'Europe colorée en fonction des points attribués au concours 2007 sur Agoravox...